← Tous les textes du Grand Oral
MathsSESNSI
Le nombre $\mathrm{e} \approx 2{,}718$ est, avec $\pi$, la constante la plus célèbre des mathématiques. En terminale, il apparaît d'un coup, comme la valeur en $1$ de la fonction exponentielle. Mais son histoire commence ailleurs : dans une question de banquier posée par Jacques Bernoulli à la fin du XVIIe siècle. Et il réapparaît là où on ne l'attend pas : quand on tire au sort les cadeaux de Noël d'une classe, ou quand on cherche la meilleure stratégie pour choisir le meilleur candidat.
Ce texte rassemble ces connaissances, avec les mathématiques de terminale : suites et limites, logarithme et exponentielle, dérivation, intégrale, dénombrement, probabilités, algorithmique. C'est un texte presque entièrement mathématique. Il ne propose pas de Grand Oral tout fait : à chacun d'y choisir une direction et d'y construire sa question.
- La question de Bernoulli : les intérêts composés
- La suite $(1 + 1/n)^n$ : croissante, majorée, de limite e
- Des logarithmes de Napier à la lettre d'Euler
- L'exponentielle, unique fonction égale à sa dérivée
- e comme somme des $1/k!$
- e n'est pas une fraction
- Les dérangements : le tirage au sort des cadeaux
- Le problème du meilleur choix
- e partout
- Des directions pour construire sa question
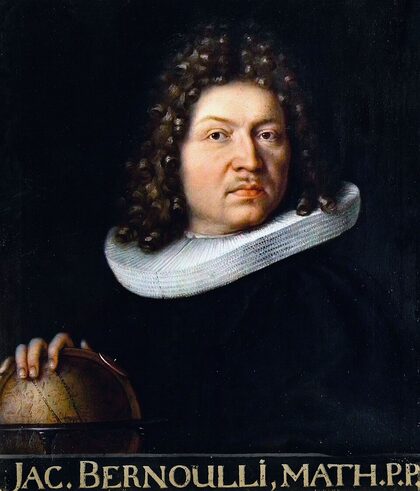
Vers 1683, le Bâlois Jacques Bernoulli (1654-1705) se pose une question d'intérêts. On place $1$ euro (il parlait d'écus) à un taux de $100\,\%$ par an. Au bout d'un an, on a $1 + 1 = 2$ euros. Mais que se passe-t-il si la banque verse les intérêts plus souvent, et que ces intérêts rapportent à leur tour des intérêts ? C'est le principe des intérêts composés.
- Deux fois par an : au bout de six mois, la banque verse la moitié du taux, $50\,\%$, et l'on a $1 \times 1{,}5 = 1{,}5$ euro. Au bout d'un an, ces $1{,}5$ euro rapportent encore $50\,\%$ : $1{,}5 \times 1{,}5 = 2{,}25$ euros.
- Quatre fois par an : à chaque trimestre, le capital est multiplié par $1 + \frac{1}{4} = 1{,}25$, donc au bout d'un an on a $1{,}25^4 \approx 2{,}441$ euros.
- Douze fois par an : chaque mois, le capital est multiplié par $1 + \frac{1}{12}$, et au bout d'un an on a $\left(1 + \frac{1}{12}\right)^{12} \approx 2{,}613$ euros.
Avec $n$ versements par an, le capital est multiplié $n$ fois par $1 + \frac{1}{n}$ : c'est une suite géométrique, et au bout d'un an le capital vaut
$$u_n = \left(1 + \frac{1}{n}\right)^n.$$| versements | $n$ | $u_n$ |
|---|---|---|
| une fois par an | $1$ | $2$ |
| deux fois | $2$ | $2{,}25$ |
| chaque trimestre | $4$ | $2{,}441\,4$ |
| chaque mois | $12$ | $2{,}613\,0$ |
| chaque semaine | $52$ | $2{,}692\,6$ |
| chaque jour | $365$ | $2{,}714\,6$ |
| chaque heure | $8\,760$ | $2{,}718\,13$ |
| chaque minute | $525\,600$ | $2{,}718\,279$ |
Le capital augmente, mais de moins en moins : passer d'un versement par jour à un versement par minute ne rapporte même pas un demi-centime. Il semble se rapprocher d'un plafond, environ $2{,}718$. Bernoulli montre que ce plafond est compris entre $2$ et $3$ : c'est le nombre que nous appelons $\mathrm{e}$. Il correspond à des intérêts versés « à chaque instant » : on parle d'intérêts continus.
Avec un taux annuel $r$ (par exemple $r = 0{,}03$ pour $3\,\%$) versé en $n$ fois, le capital est multiplié en un an par $\left(1 + \frac{r}{n}\right)^n$, qui tend vers $\mathrm{e}^{r}$ quand $n$ tend vers $+\infty$ (on le démontre comme dans la section suivante, ou dans le texte sur la méthode d'Euler). Pour $r = 0{,}03$, on trouve $\mathrm{e}^{0{,}03} \approx 1{,}030\,45$ : avec des intérêts continus, un taux de $3\,\%$ rapporte en fait environ $3{,}045\,\%$ par an. L'écart est faible pour un taux faible, ce que dit l'approximation $\mathrm{e}^{r} \approx 1 + r$ près de $0$.
C'est aussi l'origine de la règle de 70 des économistes : un capital (ou un PIB, ou une population) qui croît de $r\,\%$ par an double en environ $\frac{70}{r}$ ans. En effet, avec une croissance continue, $\mathrm{e}^{\frac{r}{100}t} = 2$ donne $t = \frac{100 \ln 2}{r}$, et $100 \ln 2 \approx 69{,}3$.
Le tableau suggère trois propriétés de la suite $u_n = \left(1 + \frac{1}{n}\right)^n$ : elle est croissante, elle est majorée, et elle a une limite proche de $2{,}718$. Démontrons-les avec le logarithme. Pour tout entier $n \geqslant 1$, on a $1 + \frac{1}{n} > 0$, donc
$$u_n = \mathrm{e}^{\,n \ln\left(1 + \frac{1}{n}\right)}.$$Étape 1 : se ramener à une fonction. La fonction exponentielle est croissante, donc il suffit de montrer que la suite $v_n = n\ln\left(1 + \frac{1}{n}\right)$ est croissante. On étudie pour cela la fonction $h$ définie sur $]0 ; +\infty[$ par $h(x) = x \ln\left(1 + \frac{1}{x}\right)$, qui vérifie $h(n) = v_n$.
Étape 2 : dériver. On écrit $h(x) = x\bigl(\ln(x + 1) - \ln x\bigr)$. Par la formule de dérivation d'un produit,
$$\begin{aligned} h'(x) &= \ln(x+1) - \ln x \\ &\quad + x\left(\frac{1}{x+1} - \frac{1}{x}\right), \end{aligned}$$et comme $x\left(\frac{1}{x+1} - \frac{1}{x}\right) = \frac{x}{x+1} - 1 = -\frac{1}{x+1}$,
$$h'(x) = \ln\left(1 + \frac{1}{x}\right) - \frac{1}{x+1}.$$Étape 3 : étudier le signe avec une autre fonction. Posons $t = \frac{1}{x} > 0$. Alors $\frac{1}{x+1} = \frac{t}{1+t}$, donc $h'(x) = \varphi(t)$ avec $\varphi(t) = \ln(1+t) - \frac{t}{1+t}$. La fonction $\varphi$ est dérivable sur $[0 ; +\infty[$ et
$$\varphi'(t) = \frac{1}{1+t} - \frac{1}{(1+t)^2} = \frac{t}{(1+t)^2}.$$Pour $t > 0$, $\varphi'(t) > 0$ : $\varphi$ est strictement croissante sur $[0 ; +\infty[$, et $\varphi(0) = 0$. Donc $\varphi(t) > 0$ pour tout $t > 0$.
Étape 4 : conclure. Ainsi $h'(x) > 0$ sur $]0 ; +\infty[$ : $h$ est strictement croissante, donc la suite $(v_n)$ aussi, et $(u_n) = \left(\mathrm{e}^{v_n}\right)$ est strictement croissante.
Étape 1. La fonction $g(t) = t - \ln(1 + t)$ a pour dérivée $g'(t) = 1 - \frac{1}{1+t} = \frac{t}{1+t}$, positive sur $[0 ; +\infty[$. Elle est donc croissante, et comme $g(0) = 0$, on a $\ln(1 + t) \leqslant t$ pour tout $t \geqslant 0$.
Étape 2. Avec $t = \frac{1}{n}$ : $v_n = n \ln\left(1 + \frac{1}{n}\right) \leqslant 1$, donc $u_n = \mathrm{e}^{v_n} \leqslant \mathrm{e}^1 = \mathrm{e}$.
Une suite croissante et majorée converge : c'est le théorème de la limite monotone, au programme. Reste à trouver sa limite.
Étape 1 : un taux d'accroissement. Posons $t = \frac{1}{n}$. Alors
$$v_n = \frac{\ln(1 + t) - \ln 1}{t},$$qui est le taux d'accroissement de la fonction $\ln$ entre $1$ et $1 + t$.
Étape 2 : un nombre dérivé. Quand $n$ tend vers $+\infty$, $t$ tend vers $0$, et ce taux tend vers le nombre dérivé $\ln'(1) = \frac{1}{1} = 1$. Donc $\displaystyle\lim_{n \to +\infty} v_n = 1$.
Étape 3 : composer. La fonction exponentielle est continue en $1$, donc $u_n = \mathrm{e}^{v_n}$ tend vers $\mathrm{e}^1 = \mathrm{e}$.
Le même raisonnement, avec $\frac{a}{n}$ au lieu de $\frac{1}{n}$, montre que $\left(1 + \frac{a}{n}\right)^n$ tend vers $\mathrm{e}^a$ pour tout réel $a$. C'est exactement ce que calcule la méthode d'Euler pour l'équation $y' = ay$ : les intérêts de Bernoulli et la ligne brisée d'Euler sont le même calcul.
Mais cette suite converge lentement : avec un versement par heure, on n'a encore que $3$ décimales exactes. On montre que l'écart $\mathrm{e} - u_n$ est environ $\frac{\mathrm{e}}{2n}$ : pour gagner une décimale, il faut multiplier $n$ par $10$. La section e comme somme des $1/k!$ donne une méthode beaucoup plus rapide.
Le nombre e n'a pas été découvert en un jour, ni par une seule personne. Les grandes étapes, que l'on peut raconter avec prudence sur les dates :
- 1614 : l'Écossais John Napier publie ses tables de logarithmes, qui transforment les multiplications en additions. Ses logarithmes sont liés au nombre $\frac{1}{\mathrm{e}}$ par un changement d'échelle, mais le nombre e n'y apparaît pas comme tel.
- Vers 1647-1649 : Grégoire de Saint-Vincent et son élève Alphonse de Sarasa remarquent que l'aire sous l'hyperbole $y = \frac{1}{x}$ se comporte comme un logarithme : c'est notre $\ln x = \int_1^x \frac{1}{t}\,\mathrm{d}t$. Le texte sur le logarithme de Brouncker raconte cette histoire. Le nombre e est alors le nombre pour lequel cette aire vaut $1$.
- 1683-1690 : Jacques Bernoulli rencontre la limite des intérêts composés et l'encadre entre $2$ et $3$.
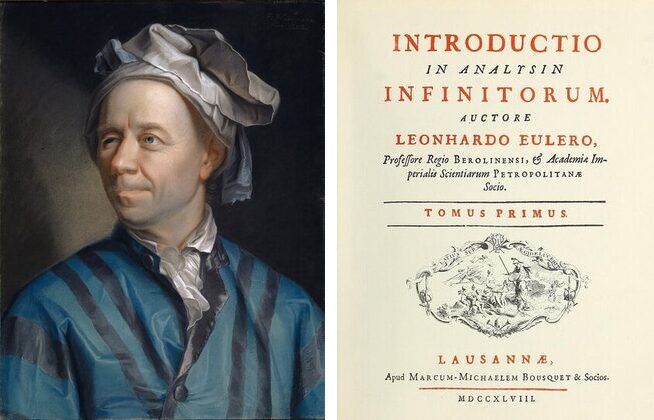
- 1727-1731 : Leonhard Euler utilise la lettre $\mathrm{e}$ dans un manuscrit sur le tir des canons, puis dans une lettre à Christian Goldbach en 1731. Le choix de la lettre est discuté : initiale d'« exponentielle », simple lettre disponible après $a$, $b$, $c$, $d$ déjà utilisées dans le manuscrit… On ne sait pas, et l'idée qu'Euler aurait choisi l'initiale de son nom n'est pas sérieuse.
- 1748 : dans son Introduction à l'analyse des infiniment petits, Euler écrit e comme la somme $1 + \frac{1}{1} + \frac{1}{1 \times 2} + \frac{1}{1 \times 2 \times 3} + \cdots$ et en donne $23$ décimales.
- 1737-1744 : Euler démontre que e est irrationnel. 1873 : Charles Hermite démontre que e est transcendant : il n'est solution d'aucune équation polynomiale à coefficients entiers. Ce sera le cas de $\pi$ neuf ans plus tard (voir le texte sur π).
En terminale, on définit la fonction exponentielle comme l'unique fonction $f$ dérivable sur $\mathbb{R}$ telle que $f' = f$ et $f(0) = 1$, puis $\mathrm{e} = \exp(1)$. L'existence d'une telle fonction est admise. L'unicité, elle, se démontre, et la démonstration est un classique de l'oral.
Étape 1. Posons $\varphi(x) = f(x) \times f(-x)$. Par la dérivée d'un produit et d'une composée,
$$\varphi'(x) = f'(x)\,f(-x) - f(x)\,f'(-x).$$Étape 2. Comme $f' = f$, $\varphi'(x)$ $= f(x)f(-x) - f(x)f(-x)$ $= 0$ : $\varphi$ est constante sur $\mathbb{R}$, égale à $\varphi(0) = f(0)^2 = 1$.
Étape 3. Pour tout réel $x$, $f(x) \times f(-x) = 1$, donc $f(x) \neq 0$.
Étape 1. Soit $g$ une autre fonction dérivable telle que $g' = g$ et $g(0) = 1$. Comme $f$ ne s'annule pas, on peut poser $q = \frac{g}{f}$.
Étape 2. Par la dérivée d'un quotient,
$$q' = \frac{g'f - gf'}{f^2} = \frac{gf - gf}{f^2} = 0.$$Étape 3. Donc $q$ est constante, égale à $q(0) = \frac{1}{1} = 1$, et $g = f$.
Cette définition explique pourquoi e est partout en physique, en biologie, en économie : dès qu'une grandeur varie proportionnellement à elle-même (une population, un capital, une quantité de noyaux radioactifs), elle est décrite par une exponentielle, voir la radioactivité.
Pour tout entier $k \geqslant 1$, on note $k! = 1 \times 2 \times \cdots \times k$ (« factorielle $k$ ») et $0! = 1$. On pose
$$S_n = \sum_{k=0}^{n} \frac{1}{k!}.$$À la main : $S_0 = 1$, $S_1 = 1 + 1 = 2$, $S_2 = 2 + \frac{1}{2} = 2{,}5$, $S_3 = 2{,}5 + \frac{1}{6} \approx 2{,}666\,7$, $S_4 = S_3 + \frac{1}{24} \approx 2{,}708\,3$.
| $n$ | $S_n$ | $\mathrm{e} - S_n$ | $\left(1 + \frac{1}{n}\right)^n$ |
|---|---|---|---|
| $2$ | $2{,}5$ | $0{,}22$ | $2{,}25$ |
| $4$ | $2{,}708\,33$ | $0{,}009\,9$ | $2{,}441\,4$ |
| $6$ | $2{,}718\,06$ | $0{,}000\,23$ | $2{,}521\,6$ |
| $8$ | $2{,}718\,279$ | $3{,}1 \times 10^{-6}$ | $2{,}565\,8$ |
| $10$ | $2{,}718\,281\,80$ | $2{,}7 \times 10^{-8}$ | $2{,}593\,7$ |
| $12$ | $2{,}718\,281\,828\,3$ | $1{,}7 \times 10^{-10}$ | $2{,}613\,0$ |
Avec seulement $13$ termes, la somme donne $9$ décimales exactes, quand la suite de Bernoulli n'en donne aucune. Démontrons que $S_n$ tend vers e, et mesurons l'erreur. On utilise une fonction auxiliaire et une intégrale.
Étape 1 : une fonction auxiliaire. On pose, pour $x$ réel,
$$P_n(x) = \sum_{k=0}^{n} \frac{x^k}{k!}$$et $f_n(x) = \mathrm{e}^{-x} P_n(x)$. On a $P_n(1) = S_n$, $f_n(0) = 1$ et $f_n(1) = \frac{S_n}{\mathrm{e}}$.
Étape 2 : dériver $P_n$. La dérivée de $\frac{x^k}{k!}$ est $\frac{k x^{k-1}}{k!} = \frac{x^{k-1}}{(k-1)!}$ pour $k \geqslant 1$, et celle du terme constant est nulle. Donc $P_n'(x) = P_{n-1}(x)$, c'est-à-dire
$$P_n'(x) = P_n(x) - \frac{x^n}{n!}.$$À la main pour $n = 2$ : $P_2(x) = 1 + x + \frac{x^2}{2}$ et $P_2'(x) = 1 + x = P_2(x) - \frac{x^2}{2}$.
Étape 3 : dériver $f_n$. Par la dérivée d'un produit,
$$\begin{aligned} f_n'(x) &= \mathrm{e}^{-x}\bigl(P_n'(x) - P_n(x)\bigr) \\ &= -\,\mathrm{e}^{-x}\,\frac{x^n}{n!}. \end{aligned}$$Étape 4 : intégrer. Comme $f_n$ est une primitive de $f_n'$,
$$f_n(1) - f_n(0) = \int_0^1 f_n'(t)\,\mathrm{d}t,$$c'est-à-dire
$$1 - \frac{S_n}{\mathrm{e}} = I_n,$$avec
$$I_n = \int_0^1 \mathrm{e}^{-t}\,\frac{t^n}{n!}\,\mathrm{d}t.$$Étape 5 : encadrer l'intégrale. Sur $[0 ; 1]$, on a $0 \leqslant \mathrm{e}^{-t} \leqslant 1$, donc $0 \leqslant \mathrm{e}^{-t}\frac{t^n}{n!} \leqslant \frac{t^n}{n!}$. Par positivité de l'intégrale,
$$0 \leqslant I_n \leqslant \int_0^1 \frac{t^n}{n!}\,\mathrm{d}t = \frac{1}{(n+1)!}.$$De plus, la fonction intégrée est continue, positive et non nulle sur $]0 ; 1]$, donc $I_n > 0$ ; et $\mathrm{e}^{-t} < 1$ pour $t > 0$, donc l'inégalité de droite est stricte.
Étape 6 : conclure. En multipliant par e : $\mathrm{e} - S_n = \mathrm{e}\,I_n$, d'où
$$0 < \mathrm{e} - S_n < \frac{\mathrm{e}}{(n+1)!}.$$Conséquences. Comme $(n+1)!$ tend vers $+\infty$, on obtient par le théorème des gendarmes $\displaystyle\lim_{n \to +\infty} S_n = \mathrm{e}$, ce qu'Euler écrit
$$\mathrm{e} = \sum_{k=0}^{+\infty} \frac{1}{k!}.$$Avec $n = 2$ : $\mathrm{e} - 2{,}5 < \frac{\mathrm{e}}{6}$, donc $\frac{5}{6}\mathrm{e} < 2{,}5$, soit $\mathrm{e} < 3$. L'erreur est donc inférieure à $\frac{3}{(n+1)!}$ : pour $n = 12$, moins de $5 \times 10^{-10}$. La factorielle grandit si vite que chaque terme ajouté apporte environ une décimale de plus.
La même méthode montre, pour tout réel $x$, que $\mathrm{e}^x = \displaystyle\sum_{k=0}^{+\infty} \frac{x^k}{k!}$ : c'est ainsi que les calculatrices peuvent calculer l'exponentielle, avec des polynômes (voir aussi l'animation sur les polynômes qui approchent l'exponentielle).
Le programme suivant compare les deux méthodes. La variable terme évite de recalculer la factorielle : on passe de
$\frac{1}{(k-1)!}$ à $\frac{1}{k!}$ en divisant par $k$.
On voit l'erreur de la somme fondre jusqu'à la précision de la machine (environ $10^{-16}$), tandis que celle de la suite de Bernoulli décroît à peine. Pour calculer des milliards de décimales de e, les records récents utilisent des sommes de ce type, réorganisées pour l'ordinateur.
Euler l'a démontré en 1737 par une autre méthode. La preuve ci-dessous, publiée en 1815 et attribuée à Joseph Fourier, n'utilise que l'encadrement de la section précédente : c'est une démonstration par l'absurde accessible en terminale.
Étape 1 : l'hypothèse. Supposons que $\mathrm{e} = \frac{p}{q}$ avec $p$ et $q$ entiers naturels non nuls. Quitte à écrire $\frac{p}{q} = \frac{2p}{2q}$, on peut supposer $q \geqslant 2$.
Étape 2 : fabriquer un entier. Considérons le nombre
$$A = q!\,(\mathrm{e} - S_q).$$D'une part, $q!\,\mathrm{e} = q! \times \frac{p}{q} = p \times (q-1)!$ est un entier. D'autre part, $q!\,S_q = \displaystyle\sum_{k=0}^{q} \frac{q!}{k!}$ est une somme d'entiers, car pour $k \leqslant q$, $\frac{q!}{k!} = (k+1)(k+2)\cdots q$ est un produit d'entiers (ou vaut $1$). Donc $A$ est un entier.
Étape 3 : encadrer cet entier. D'après l'encadrement démontré plus haut, avec $\mathrm{e} < 3$,
$$\begin{aligned} 0 < A &< q! \times \frac{\mathrm{e}}{(q+1)!} \\ &= \frac{\mathrm{e}}{q+1} < \frac{3}{q+1}. \end{aligned}$$Comme $q \geqslant 2$, $\frac{3}{q+1} \leqslant 1$. Donc $0 < A < 1$.
Étape 4 : la contradiction. Il n'existe aucun entier strictement compris entre $0$ et $1$. L'hypothèse est donc fausse : e n'est pas un quotient de deux entiers.
Le cœur de la preuve est que les sommes $S_n$ approchent e trop bien pour une fraction : une fraction de dénominateur $q$ ne peut pas être approchée par d'autres fractions de dénominateur $q!$ avec une erreur aussi petite, sans leur être égale. On ne sait pas faire aussi simple pour $\pi$, dont l'irrationalité (Lambert, 1761) demande plus de travail.
Avant les vacances, une classe organise un échange de cadeaux : chacun écrit son prénom sur un papier, on mélange, et chacun tire un papier au hasard pour savoir à qui il offrira un cadeau. Problème : quelqu'un peut tirer son propre prénom, et il faut alors tout recommencer. Quelle est la probabilité que personne ne tire son propre prénom ?
C'est un vieux problème : Pierre Rémond de Montmort l'étudie en 1708 sous le nom de « problème des rencontres », et on le présente souvent avec $n$ lettres mises au hasard dans $n$ enveloppes déjà adressées. Une répartition où aucun élément n'est à sa place s'appelle un dérangement. On note $D_n$ le nombre de dérangements de $n$ éléments.
Avec trois élèves A, B, C, il y a $3! = 6$ tirages possibles, tous équiprobables. On note dans l'ordre le prénom tiré par A, B, puis C : ABC, ACB, BAC, BCA, CAB, CBA. Seuls BCA et CAB ne laissent personne avec son propre prénom : $D_3 = 2$, et la probabilité vaut $\frac{2}{6} = \frac{1}{3}$.
Avec quatre élèves, on peut faire la liste des $4! = 24$ tirages ; on trouve $D_4 = 9$, soit une probabilité $\frac{9}{24} = 0{,}375$. Pour une classe de $30$, la liste est impossible : $30!$ a $33$ chiffres. Il faut une formule.
On pose $D_1 = 0$ (un élève seul tire forcément son prénom) et $D_2 = 1$ (les deux échangent).
Étape 1. Dans un dérangement de $n$ élèves, l'élève 1 tire le prénom d'un autre élève, disons l'élève $j$ : il y a $n - 1$ choix possibles pour $j$, et le même nombre de dérangements pour chaque choix.
Étape 2 : premier cas. L'élève $j$ tire le prénom de l'élève 1 (ils s'échangent leurs cadeaux). Les $n - 2$ autres élèves doivent alors former un dérangement entre eux : $D_{n-2}$ possibilités.
Étape 3 : second cas. L'élève $j$ ne tire pas le prénom de l'élève 1. Le prénom « 1 » est alors interdit à $j$, comme son propre prénom est interdit à chacun des autres. Si l'on rebaptise provisoirement le papier « 1 » en « $j$ », il s'agit exactement de répartir $n - 1$ papiers entre les $n - 1$ élèves autres que 1, sans que personne ne tire « son » papier : $D_{n-1}$ possibilités.
Étape 4. Pour chacun des $n - 1$ choix de $j$, il y a $D_{n-1} + D_{n-2}$ dérangements, d'où la formule. Vérification : $D_3 = 2 \times (1 + 0) = 2$ et $D_4 = 3 \times (2 + 1) = 9$.
La formule donne ensuite $D_5 = 4 \times (9 + 2) = 44$, $D_6 = 5 \times 53 = 265$, etc. On note $p_n = \frac{D_n}{n!}$ la probabilité qu'aucun des $n$ élèves ne tire son prénom.
| $n$ | $D_n$ | $n!$ | $p_n$ |
|---|---|---|---|
| $3$ | $2$ | $6$ | $0{,}333\,3$ |
| $4$ | $9$ | $24$ | $0{,}375\,0$ |
| $5$ | $44$ | $120$ | $0{,}366\,7$ |
| $6$ | $265$ | $720$ | $0{,}368\,06$ |
| $8$ | $14\,833$ | $40\,320$ | $0{,}367\,882$ |
| $10$ | $1\,334\,961$ | $3\,628\,800$ | $0{,}367\,879\,5$ |
La probabilité se stabilise très vite autour de $0{,}3679$, et c'est $\frac{1}{\mathrm{e}} \approx 0{,}367\,879$.
Étape 1 : une suite géométrique cachée. Posons $w_n = D_n - n D_{n-1}$ pour $n \geqslant 2$. La formule de récurrence donne $D_n - nD_{n-1}$ $= -D_{n-1} + (n-1)D_{n-2}$, c'est-à-dire $w_n = -w_{n-1}$. La suite $(w_n)$ est géométrique de raison $-1$, et $w_2 = 1 - 2 \times 0 = 1$, donc $w_n = (-1)^n$.
Étape 2 : diviser par $n!$. De $D_n - nD_{n-1} = (-1)^n$ on tire
$$p_n - p_{n-1} = \frac{(-1)^n}{n!}.$$En ajoutant ces égalités de proche en proche à partir de $p_1 = 0 = 1 - 1$, on obtient $p_n = \displaystyle\sum_{k=0}^{n} \frac{(-1)^k}{k!}$. Vérification : $p_3 = 1 - 1 + \frac{1}{2} - \frac{1}{6} = \frac{1}{3}$.
Étape 3 : la même idée qu'à la section précédente. On pose $g_n(x) = \mathrm{e}^{x} \displaystyle\sum_{k=0}^{n} \frac{(-x)^k}{k!}$, de sorte que $g_n(0) = 1$ et $g_n(1) = \mathrm{e}\,p_n$. Le même calcul de dérivée qu'à l'étape 3 de la démonstration précédente donne
$$g_n'(x) = \mathrm{e}^{x}\,\frac{(-x)^n}{n!}.$$Étape 4 : intégrer et encadrer. Donc $\mathrm{e}\,p_n - 1 = (-1)^n J_n$ avec $J_n = \displaystyle\int_0^1 \mathrm{e}^{t}\,\frac{t^n}{n!}\,\mathrm{d}t$. Comme $1 \leqslant \mathrm{e}^t \leqslant \mathrm{e}$ sur $[0 ; 1]$, $0 \leqslant J_n \leqslant \frac{\mathrm{e}}{(n+1)!}$, d'où
$$\left| p_n - \frac{1}{\mathrm{e}} \right| \leqslant \frac{1}{(n+1)!}.$$Étape 5. Le majorant tend vers $0$ : $p_n$ tend vers $\frac{1}{\mathrm{e}}$. Pour $n = 10$, l'écart est déjà inférieur à $\frac{1}{11!} \approx 2{,}5 \times 10^{-8}$.
Ce que cela dit de la classe. Quelle que soit sa taille (au-delà de quelques élèves), la probabilité que le tirage réussisse du premier coup est d'environ $37\,\%$ : dans environ $63\,\%$ des cas, il faudra recommencer. Le résultat est surprenant : on pourrait croire qu'avec plus d'élèves, il y a plus de risques que l'un d'eux tire son prénom, ou au contraire moins, puisque chacun a moins de chances de le tirer. Les deux effets se compensent exactement à la limite.
Le nombre de tirages nécessaires suit une loi géométrique de paramètre $p \approx \frac{1}{\mathrm{e}}$ : son espérance est $\frac{1}{p} \approx \mathrm{e} \approx 2{,}7$ tirages. En moyenne, il faut donc près de trois tirages pour réussir.
Le programme mélange au hasard les prénoms d'une classe de $30$ élèves, compte la proportion de tirages sans personne à sa place, et la compare à $\frac{1}{\mathrm{e}}$. D'après la loi des grands nombres, plus on fait de tirages, plus il est probable que cette fréquence soit proche de la probabilité $p_{30}$, elle-même égale à $\frac{1}{\mathrm{e}}$ à $10^{-30}$ près.
Une entreprise doit embaucher une personne parmi $n$ candidats, qui se présentent un par un dans un ordre aléatoire. Après chaque entretien, il faut décider tout de suite : embaucher (et s'arrêter) ou refuser (définitivement). On sait seulement comparer le candidat présent à ceux déjà vus. On veut maximiser la probabilité d'embaucher le meilleur des $n$. Ce « problème de la secrétaire » a été popularisé en 1960 par le journaliste scientifique Martin Gardner ; on raconte aussi, avec prudence, que l'astronome Kepler aurait cherché une épouse en 1611 en rencontrant successivement onze candidates.
Une stratégie naturelle : observer sans embaucher les $r - 1$ premiers candidats, puis embaucher le premier candidat meilleur que tous ceux vus jusque-là. Si l'on refuse trop peu de candidats, on manque d'information ; si l'on en refuse trop, le meilleur a de bonnes chances d'être déjà passé. Quel est le bon nombre ?
On réussit si le meilleur candidat se présente en position $k \geqslant r$ et si l'on ne s'est pas arrêté avant lui. Or on s'arrête avant le rang $k$ si l'un des candidats des rangs $r$ à $k - 1$ bat tous les précédents. On ne s'arrête donc pas avant le rang $k$ exactement quand le meilleur des $k - 1$ premiers candidats est parmi les $r - 1$ observés, ce qui a pour probabilité $\frac{r-1}{k-1}$ (le meilleur des $k - 1$ premiers est à n'importe laquelle des $k - 1$ places, avec la même probabilité). Le meilleur est en position $k$ avec la probabilité $\frac{1}{n}$. Par la formule des probabilités totales, pour $r \geqslant 2$,
$$P_n(r) = \sum_{k=r}^{n} \frac{1}{n} \times \frac{r-1}{k-1},$$soit
$$P_n(r) = \frac{r-1}{n} \sum_{j=r-1}^{n-1} \frac{1}{j}.$$À la main pour $n = 4$ et $r = 2$ (on observe le premier, puis on prend le premier meilleur que lui) : $P_4(2) = \frac{1}{4}\left(1 + \frac{1}{2} + \frac{1}{3}\right) = \frac{11}{24} \approx 0{,}458$, bien mieux que $\frac{1}{4}$ en prenant un candidat au hasard.
Étape 1 : comparer la somme à une intégrale. La fonction $t \mapsto \frac{1}{t}$ est décroissante, donc pour $j \geqslant 1$, $\frac{1}{j}$ est compris entre les aires $\int_j^{j+1} \frac{\mathrm{d}t}{t}$ et $\int_{j-1}^{j} \frac{\mathrm{d}t}{t}$ (rectangles de largeur $1$ sous et au-dessus de la courbe). En additionnant, quand $r$ et $n$ sont grands,
$$\sum_{j=r-1}^{n-1} \frac{1}{j} \approx \int_{r-1}^{n} \frac{\mathrm{d}t}{t} = \ln\frac{n}{r-1}.$$Étape 2 : une fonction d'une variable. En notant $x = \frac{r-1}{n}$ la proportion de candidats observés, on obtient $P_n(r) \approx f(x)$ avec
$$f(x) = -x \ln x, \quad x \in \,]0 ; 1].$$Étape 3 : étudier $f$. $f'(x) = -\ln x - x \times \frac{1}{x} = -\ln x - 1$, qui s'annule pour $\ln x = -1$, soit $x = \frac{1}{\mathrm{e}}$ ; $f'$ est positive avant et négative après. Le maximum est
$$f\left(\frac{1}{\mathrm{e}}\right) = -\frac{1}{\mathrm{e}} \times (-1) = \frac{1}{\mathrm{e}}.$$Conclusion : il faut observer sans embaucher environ $37\,\%$ des candidats (une proportion $\frac{1}{\mathrm{e}}$), puis prendre le premier qui les bat tous ; on obtient alors le meilleur avec une probabilité proche de $\frac{1}{\mathrm{e}} \approx 37\,\%$, quel que soit le nombre de candidats. Pour $100$ candidats, le calcul exact donne l'optimum en observant les $37$ premiers, avec une probabilité de réussite d'environ $0{,}371$. Il est démontré qu'aucune stratégie ne fait mieux, ce que l'on admet ici.
Le programme simule la stratégie pour $50$ candidats, avec plusieurs nombres de candidats observés, et compte la fréquence des fois où le meilleur est embauché. La meilleure fréquence doit apparaître autour de $18$ candidats observés ($50 / \mathrm{e} \approx 18{,}4$).
- La croissance continue : une grandeur dont la vitesse de variation est proportionnelle à elle-même vérifie $y' = ky$, donc $y(t) = y(0)\,\mathrm{e}^{kt}$ : capital à intérêts continus, population de bactéries, décroissance radioactive ($k < 0$), refroidissement d'une tasse de café (voir la méthode d'Euler).
- La chaînette : la forme d'un câble suspendu, $y = \frac{\mathrm{e}^{x} + \mathrm{e}^{-x}}{2}$ à un changement d'échelle près, que Galilée confondait avec une parabole (voir le dôme et la chaînette).
- Le logarithme népérien : e est la base du logarithme « naturel », celui dont la dérivée est $\frac{1}{x}$ ; en français, on parle aussi de la constante de Néper, du nom francisé de Napier.
- Les probabilités : les dérangements et le meilleur choix de ce texte, mais aussi la probabilité de ne jamais gagner en jouant $n$ fois à un jeu où l'on gagne une fois sur $n$ : $\left(1 - \frac{1}{n}\right)^n$, qui tend vers $\frac{1}{\mathrm{e}}$ (même démonstration que pour $\left(1 + \frac{1}{n}\right)^n$, avec $a = -1$).
Ce texte n'est pas un Grand Oral. Il rassemble des connaissances dans lesquelles chacun peut choisir une direction, la creuser et formuler sa propre question. Quelques directions possibles :
- Mathématiques : la limite de $\left(1 + \frac{1}{n}\right)^n$ par le nombre dérivé ; l'unicité de l'exponentielle ; l'encadrement de e par une intégrale et la vitesse de convergence ; l'irrationalité de e ; les dérangements (récurrence, suite géométrique, limite) ; le meilleur choix (somme, intégrale, étude de $-x\ln x$).
- SES : les intérêts composés et continus, le taux équivalent, la règle de 70 et le temps de doublement d'un capital ou d'un PIB ; les stratégies d'arrêt optimal (embauche, achat d'un logement, recherche d'un emploi) et leurs limites.
- NSI : calculer des décimales de e, comparer la vitesse de deux algorithmes, simuler un tirage au sort, mélanger une liste au hasard.
Le jury peut interroger sur les chapitres de spécialité mobilisés. Avec ce thème, il est utile de connaître parfaitement : la définition de la fonction exponentielle et ses propriétés ; la fonction logarithme et sa dérivée ; le nombre dérivé comme limite d'un taux d'accroissement ; les dérivées d'un produit, d'un quotient, d'une composée ; le théorème de la limite monotone et celui des gendarmes ; les suites géométriques ; la positivité de l'intégrale et le calcul par une primitive ; la factorielle et le dénombrement des permutations ; la formule des probabilités totales et la loi géométrique ; le raisonnement par l'absurde.
Pour réviser ces chapitres, l'application Maths FlashBac reprend tout le cours de spécialité en cartes.
- e (nombre), dérangement et problème du secrétaire (Wikipédia).
- Sur ce site : Le logarithme de Brouncker, La méthode d'Euler, Le nombre π, Le dôme et la chaînette, La radioactivité et Aristote et l'infini.