← Tous les textes du Grand Oral
MathsSESHGGSP
Si l'État ne prélève rien, il ne reçoit rien. S'il prélève la totalité d'un revenu, plus personne n'a intérêt à gagner ce revenu, ou du moins à le déclarer : il ne reçoit, là encore, presque rien. Entre les deux, la recette de l'impôt monte puis redescend. C'est l'idée de la courbe de Laffer, résumée par une formule ancienne : trop d'impôt tue l'impôt.
L'idée est simple et presque indiscutable. Ce qui est discuté, depuis cinquante ans, c'est où se trouve le sommet : à 30 %, à 50 %, à 80 % ? La réponse change tout. Si un pays est à droite du sommet, baisser l'impôt rapporte plus ; s'il est à gauche, baisser l'impôt rapporte moins. Les mathématiques permettent de poser la question proprement : elles montrent que le sommet dépend d'un seul nombre, difficile à mesurer, l'élasticité.
Ce texte rassemble ces connaissances, avec les mathématiques de terminale : dérivée d'un produit et d'une fonction composée, exponentielle et logarithme, variations et maximum, algorithmique. Il ne prend pas parti dans le débat politique, et ne propose pas de Grand Oral tout fait : à chacun d'y choisir une direction et d'y construire sa question.
- L'idée : recette = taux × assiette
- Un exemple à la main
- Le modèle avec élasticité : le sommet démontré
- Un autre modèle, une autre réponse
- Une vieille idée : d'Ibn Khaldoun à la serviette de Laffer
- Ce que disent les études
- Des expériences réelles, discutées
- Pourquoi le modèle est trop simple
- Des directions pour construire sa question
Un impôt s'applique à une assiette : les revenus déclarés pour l'impôt sur le revenu, les ventes pour la TVA, les paquets vendus pour la taxe sur le tabac. Si le taux est $t$ (un nombre entre $0$ et $1$, c'est-à-dire entre $0\,\%$ et $100\,\%$) et l'assiette $B$, la recette est
$$R = t \times B.$$Si l'assiette ne bougeait pas, la recette serait proportionnelle au taux : doubler le taux doublerait la recette. Mais l'assiette réagit au taux. Quand l'impôt augmente, certains travaillent moins, d'autres déclarent moins, déplacent leurs revenus vers une forme moins taxée ou vers un autre pays ; un produit plus taxé se vend moins, ou passe en contrebande. L'assiette est donc une fonction décroissante du taux, notée $B(t)$, et la recette devient une fonction du taux :
$$R(t) = t \times B(t).$$Deux valeurs sont faciles à trouver. Pour $t = 0$, la recette est nulle. Pour $t = 1$ (impôt de $100\,\%$), on admet que plus rien n'est déclaré : $B(1) = 0$, donc la recette est encore nulle. Entre les deux, la recette est positive. Une fonction continue sur $[0 ; 1]$, nulle aux deux bouts et positive entre les deux, monte puis redescend : elle atteint un maximum quelque part. C'est tout le contenu de la « courbe de Laffer ». La vraie question est la position de ce maximum, et pour la trouver il faut un modèle de l'assiette $B(t)$.
Prenons un modèle très simple, choisi pour l'exemple : sans impôt, l'assiette vaut $100$ (milliards d'euros, par exemple), et elle diminue proportionnellement à la part que l'impôt laisse au contribuable,
$$B(t) = 100\,(1 - t).$$Avec un impôt de $30\,\%$, il reste $70\,\%$ du revenu au contribuable, et l'assiette vaut $70$. On calcule quelques recettes :
| taux $t$ | $10\,\%$ | $30\,\%$ | $50\,\%$ | $70\,\%$ | $90\,\%$ |
|---|---|---|---|---|---|
| assiette $B(t)$ | $90$ | $70$ | $50$ | $30$ | $10$ |
| recette $t \times B(t)$ | $9$ | $21$ | $25$ | $21$ | $9$ |
La recette monte jusqu'à $25$ pour un taux de $50\,\%$, puis redescend. Les taux de $30\,\%$ et de $70\,\%$ rapportent exactement la même chose : c'est l'aspect le plus frappant de la courbe. Deux politiques très différentes, l'une à droite et l'autre à gauche du sommet, peuvent produire la même recette.
Ici, $R(t) = 100\,t\,(1 - t)$ est un polynôme du second degré, dont la parabole a son sommet en $t = \frac{1}{2}$. On le retrouve par la dérivée : $R'(t) = 100\,(1 - 2t)$, positive avant $\frac{1}{2}$, négative après.
Que se passe-t-il quand on augmente le taux d'un point, de $30\,\%$ à $31\,\%$ ?
- L'effet mécanique : un point de plus sur l'assiette actuelle, soit $0{,}01 \times 70 = 0{,}70$ de recette en plus.
- L'effet de comportement : l'assiette baisse d'un point, de $70$ à $69$, et cette perte est taxée à $30\,\%$ : $0{,}30$ de recette en moins.
Le bilan est d'environ $+0{,}40$ : on vérifie que $R(0{,}31) = 0{,}31 \times 69 = 21{,}39$. À $50\,\%$, les deux effets valent chacun $0{,}50$ et s'annulent : c'est le sommet. Au-delà, l'effet de comportement l'emporte, et augmenter l'impôt fait baisser la recette.
Cette décomposition est exactement la dérivée d'un produit. Comme $R(t) = t \times B(t)$,
$$R'(t) = \underbrace{B(t)}_{\text{effet mécanique}} + \underbrace{t\,B'(t)}_{\text{effet de comportement}}.$$Le premier terme est positif, le second négatif (car $B$ est décroissante). Le sommet est atteint quand ils se compensent.
Le modèle précédent est trop rigide : rien ne dit que l'assiette réagit autant. Les économistes mesurent cette réaction par une élasticité, notée $\varepsilon$ : si la part laissée au contribuable, $1 - t$, augmente de $1\,\%$, l'assiette augmente d'environ $\varepsilon\,\%$. Un modèle simple qui a cette propriété est
$$B(t) = B_0\,(1 - t)^{\varepsilon},$$où $B_0$ est l'assiette sans impôt et $\varepsilon$ un réel strictement positif. Pour $\varepsilon = 1$, on retrouve l'exemple à la main. Pour $\varepsilon = 0{,}5$, passer de $50\,\%$ à $55\,\%$ d'impôt fait baisser la part gardée de $0{,}50$ à $0{,}45$, soit $-10\,\%$, et l'assiette est multipliée par $\sqrt{0{,}9} \approx 0{,}949$, soit environ $-5\,\%$ : la moitié, comme annoncé.
Pour un réel $\varepsilon$ quelconque, la puissance se définit avec l'exponentielle et le logarithme : pour $0 \leqslant t < 1$,
$$(1 - t)^{\varepsilon} = \mathrm{e}^{\varepsilon \ln(1 - t)}.$$La recette est $R(t) = B_0\,t\,(1 - t)^{\varepsilon}$ pour $t \in [0 ; 1[$.
Étape 1 : dérivée de l'assiette. On écrit $B(t) = B_0\,\mathrm{e}^{u(t)}$ avec $u(t) = \varepsilon \ln(1 - t)$. La dérivée de $\ln(1 - t)$ est $\dfrac{-1}{1 - t}$, donc $u'(t) = \dfrac{-\varepsilon}{1 - t}$, et par la dérivée de $\mathrm{e}^{u}$ :
$$B'(t) = u'(t)\,B_0\,\mathrm{e}^{u(t)} = \frac{-\varepsilon}{1 - t}\,B(t).$$Étape 2 : dérivée de la recette. Par la dérivée d'un produit,
$$\begin{aligned} R'(t) &= B(t) + t\,B'(t) \\ &= B(t) - \frac{\varepsilon\,t}{1 - t}\,B(t) \\ &= B(t) \times \frac{1 - t - \varepsilon\,t}{1 - t}. \end{aligned}$$On obtient
$$R'(t) = \frac{B(t)}{1 - t} \times \big(1 - (1 + \varepsilon)\,t\big).$$Étape 3 : signe. Pour $0 \leqslant t < 1$, $B(t) > 0$ (une exponentielle est strictement positive) et $1 - t > 0$. Le signe de $R'(t)$ est donc celui de $1 - (1 + \varepsilon)\,t$, qui est positif pour $t < \dfrac{1}{1 + \varepsilon}$ et négatif ensuite.
Étape 4 : conclusion. La recette est croissante sur $\left[0 ; \dfrac{1}{1 + \varepsilon}\right]$ et décroissante sur $\left[\dfrac{1}{1 + \varepsilon} ; 1\right[$. Elle atteint son maximum pour le taux
$$t^* = \frac{1}{1 + \varepsilon}.$$Le résultat est d'une grande simplicité, et il dit l'essentiel : le sommet ne dépend que de l'élasticité. Plus l'assiette réagit (plus $\varepsilon$ est grand), plus le sommet est à gauche.
| élasticité $\varepsilon$ | $0{,}25$ | $0{,}5$ | $1$ | $2$ |
|---|---|---|---|---|
| taux du sommet $t^*$ | $80\,\%$ | $66{,}7\,\%$ | $50\,\%$ | $33{,}3\,\%$ |
| recette maximale (pour $B_0 = 100$) | $53{,}5$ | $38{,}5$ | $25$ | $14{,}8$ |
Pour $\varepsilon = 0{,}5$, on vérifie à la main avec $B_0 = 100$ : à $50\,\%$, la recette vaut $0{,}5 \times 100\sqrt{0{,}5} \approx 35{,}4$ ; au sommet $t^* = \frac{2}{3}$, elle vaut $\frac{2}{3} \times 100\sqrt{\frac{1}{3}} \approx 38{,}5$ ; à $80\,\%$, elle retombe à $0{,}8 \times 100\sqrt{0{,}2} \approx 35{,}8$.
Le tableur ci-dessous calcule l'assiette et la recette de $5$ en $5$ points de taux. On peut changer l'élasticité (case B1) ou l'assiette sans
impôt (case B2) : la colonne C montre où se trouve le sommet. La formule de la case B5 est
=$B$2*(1-A5/100)**$B$1, où ** désigne la puissance.
Rien n'oblige à choisir la puissance $(1 - t)^{\varepsilon}$. Un autre modèle courant fait décroître l'assiette exponentiellement :
$$B(t) = B_0\,\mathrm{e}^{-a t}, \qquad R(t) = B_0\,t\,\mathrm{e}^{-a t},$$avec $a > 0$. La dérivée d'un produit donne
$$R'(t) = B_0\,\mathrm{e}^{-a t}\,(1 - a t),$$du signe de $1 - a t$ : le sommet est en $t^* = \dfrac{1}{a}$. Pour $a = 2$, il est à $50\,\%$ ; pour $a = 4$, à $25\,\%$. Mais pour $a \leqslant 1$, on a $t^* \geqslant 1$ : la recette augmente sur tout l'intervalle $[0 ; 1]$, et ce modèle prédit qu'un impôt de $100\,\%$ rapporte encore $B_0\,\mathrm{e}^{-a}$, ce qui est peu réaliste.
La leçon est importante pour un Grand Oral : la position du sommet n'est pas une propriété de « la » courbe de Laffer, mais du modèle choisi et des valeurs mesurées de ses paramètres. Deux économistes qui partent de modèles différents, ou de mesures différentes, arrivent honnêtement à des taux très différents.
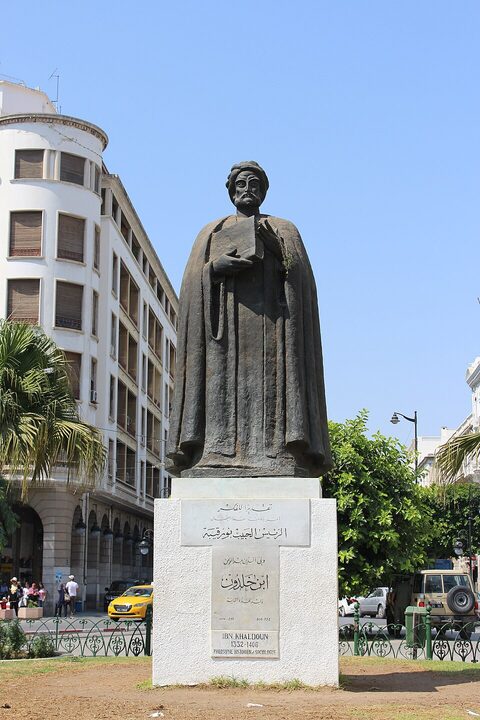
- Ibn Khaldoun (1332-1406), historien né à Tunis, observe dans sa Muqaddima (vers 1377) qu'au début d'une dynastie, des impôts légers sur une grande activité rapportent beaucoup, et qu'à la fin, des impôts lourds sur une activité découragée rapportent peu. Arthur Laffer lui-même le cite comme un précurseur.
- Au XVIIIe siècle, Jonathan Swift écrit que « dans l'arithmétique des douanes, deux et deux ne font pas toujours quatre, mais parfois un ». Adam Smith reprend la phrase en 1776 : des droits trop élevés réduisent la consommation ou encouragent la contrebande, et rapportent parfois moins que des droits modérés.
- En 1844, l'ingénieur Jules Dupuit explique qu'un impôt qui augmente progressivement fait d'abord monter la recette, puis la fait baisser jusqu'à zéro quand il devient prohibitif. La formule « l'impôt tue l'impôt » est souvent attribuée à l'économiste Jean-Baptiste Say.
- En 1974, selon le récit qu'en a fait le journaliste Jude Wanniski, l'économiste américain Arthur Laffer dessine la courbe sur une serviette, lors d'un dîner à Washington avec des conseillers du président Gerald Ford. Wanniski lui donne le nom de « courbe de Laffer » en 1978. Une serviette dédicacée par Laffer est conservée par un musée de la Smithsonian Institution, mais Laffer a dit ne pas se souvenir précisément du dessin.
La courbe devient célèbre parce qu'elle sert d'argument, à la fin des années 1970, aux partisans de fortes baisses d'impôts aux États-Unis. Son succès politique a parfois fait oublier qu'elle ne dit rien, à elle seule, de la position du sommet : c'est ce que les études cherchent à mesurer.
Toute la difficulté est de mesurer $\varepsilon$. On observe ce que font les contribuables quand un taux change, par exemple lors d'une réforme qui touche certains revenus et pas d'autres. Les résultats varient beaucoup :
- en 1995, Martin Feldstein étudie la grande réforme américaine de 1986 et trouve une élasticité du revenu imposable de l'ordre de $1$, ou plus ;
- en 2012, une synthèse de Saez, Slemrod et Giertz estime que les mesures les plus fiables, pour les États-Unis, se situent plutôt entre environ $0{,}12$ et $0{,}40$, et souligne que l'élasticité dépend beaucoup des possibilités d'optimisation offertes par la loi.
Pour la tranche la plus haute de l'impôt sur le revenu, les économistes Peter Diamond et Emmanuel Saez (2011) utilisent une formule de la même famille que $\frac{1}{1 + \varepsilon}$, que l'on admet ici :
$$t^* = \frac{1}{1 + a\,\varepsilon},$$où $a$ décrit la répartition des très hauts revenus (environ $1{,}5$ aux États-Unis). Le taux $t^*$ est ici le taux marginal total, tous prélèvements confondus, qui maximise la recette tirée des plus hauts revenus.
| élasticité $\varepsilon$ | $0{,}12$ | $0{,}25$ | $0{,}40$ | $1$ |
|---|---|---|---|---|
| $t^* = \frac{1}{1 + 1{,}5\,\varepsilon}$ | $84{,}7\,\%$ | $72{,}7\,\%$ | $62{,}5\,\%$ | $40\,\%$ |
Avec $\varepsilon = 0{,}25$, Diamond et Saez obtiennent environ $73\,\%$ ; une étude de 2014 (Piketty, Saez et Stantcheva), qui distingue plusieurs façons de réagir à l'impôt, va jusqu'à environ $83\,\%$. Avec l'élasticité de Feldstein, le sommet descend vers $40\,\%$. Le désaccord entre économistes ne porte donc pas sur les mathématiques, qui sont les mêmes, mais sur la mesure d'un seul nombre.
Le programme suivant cherche le sommet par un balayage des taux de $0{,}1$ en $0{,}1$ point, et le compare à la formule $\frac{1}{1 + \varepsilon}$ ; il calcule ensuite le tableau de Diamond et Saez.
Les économistes ne peuvent pas faire d'expérience contrôlée sur un pays entier. Les réformes réelles mélangent beaucoup d'effets, et chaque camp y lit souvent ce qu'il cherche. Quelques exemples, avec les arguments des deux côtés :
- Les États-Unis de Ronald Reagan. Le taux marginal le plus élevé de l'impôt fédéral sur le revenu passe de $70\,\%$ à $50\,\%$ en 1981, puis à $28\,\%$ avec la réforme de 1986. Les partisans du raisonnement de Laffer soulignent que la part de l'impôt payée par les plus hauts revenus a augmenté. La plupart des études concluent pourtant que ces baisses ne se sont pas financées d'elles-mêmes : les recettes ont baissé par rapport à la richesse produite, le déficit s'est creusé, et des hausses d'impôts ont suivi dès 1982.
- Le Kansas, 2012. L'État baisse fortement son impôt sur le revenu, en espérant un surcroît d'activité. Les recettes chutent, l'État doit couper dans ses dépenses, et le parlement du Kansas annule l'essentiel de la réforme en 2017, malgré le veto du gouverneur. Les défenseurs de la réforme mettent en cause sa mise en œuvre plutôt que son principe.
- La taxe à 75 % en France. Annoncée en 2012 pour les revenus de plus d'un million d'euros, elle est censurée dans sa première forme par le Conseil constitutionnel, puis remplacée par une contribution payée par les entreprises sur les rémunérations de plus d'un million d'euros, pour les années 2013 et 2014. Elle aurait rapporté de l'ordre de 400 millions d'euros en deux ans, et n'a pas été reconduite. Les uns y voient un exemple de taux trop élevé ; les autres rappellent qu'elle était temporaire et visait très peu de personnes, ce qui rend toute conclusion fragile.
- La Russie, 2001. Le pays remplace son barème par un taux unique de $13\,\%$, et les recettes de l'impôt sur le revenu augmentent ensuite. Une étude publiée en 2005 attribue cette hausse surtout à une meilleure déclaration des revenus, et moins à un surcroît de travail.
- L'élasticité n'est pas une constante de la nature. Une grande partie de la réaction à l'impôt vient de l'optimisation : déplacer un revenu vers une forme moins taxée, le reporter, le déclarer ailleurs. Une loi qui ferme ces possibilités diminue $\varepsilon$, donc déplace le sommet vers la droite.
- Court terme et long terme. Les contribuables réagissent peu l'année d'une réforme, davantage au bout de quelques années : l'élasticité, donc le sommet, dépend de l'horizon considéré.
- Les impôts sont reliés. Un revenu qui échappe à l'impôt sur le revenu peut être taxé autrement (impôt sur les sociétés, TVA sur la consommation). Étudier un impôt seul peut tromper.
- La croissance. Le modèle est statique. Les effets d'un impôt sur l'investissement, la formation ou l'innovation, sur de longues durées, sont réels mais très difficiles à mesurer, et restent débattus.
- La forme de la courbe. Rien ne garantit une courbe à un seul sommet, ni qu'un taux de $100\,\%$ ne rapporte rien : le deuxième modèle montre qu'un autre choix de fonction change la réponse.
- Maximiser la recette n'est pas un objectif évident. Le sommet de la courbe est un repère, pas une recommandation : selon les préférences politiques, on peut vouloir une recette plus faible (un État plus léger) ou accepter un taux élevé pour d'autres raisons (réduire les inégalités). Les mathématiques éclairent ce choix, elles ne le font pas.
Ce texte n'est pas un Grand Oral. Il rassemble des connaissances dans lesquelles chacun peut choisir une direction, la creuser et formuler sa propre question. Quelques directions possibles :
- Mathématiques : la dérivée d'un produit comme somme de deux effets ; le maximum de $t\,(1 - t)^{\varepsilon}$ démontré par l'étude du signe ; la puissance réelle définie par l'exponentielle et le logarithme ; la sensibilité du résultat au choix du modèle.
- SES : l'élasticité et sa mesure ; l'effet mécanique et l'effet de comportement ; la fiscalité, la redistribution et les inégalités ; l'évasion et l'optimisation fiscales.
- HGGSP : l'histoire d'une idée, d'Ibn Khaldoun à la révolution conservatrice des années 1980 ; le rôle des économistes dans la décision politique ; la concurrence fiscale entre États.
Le jury peut interroger sur les chapitres de spécialité mobilisés. Avec ce thème, il est utile de connaître parfaitement : la dérivée d'un produit et d'un quotient ; la dérivée de $\mathrm{e}^{u}$ et de $\ln(u)$ ; le lien entre le signe de la dérivée et les variations ; la recherche d'un maximum ; les fonctions exponentielle et logarithme ; les fonctions polynômes du second degré ; les taux d'évolution et les pourcentages ; les boucles en Python.
Pour réviser ces chapitres, l'application Maths FlashBac reprend tout le cours de spécialité en cartes.
- Courbe de Laffer et Ibn Khaldoun (Wikipédia).
- P. Diamond et E. Saez, The Case for a Progressive Tax, Journal of Economic Perspectives, 2011.
- Sur ce site : La microéconomie (taxe, perte sèche et élasticité), Le coefficient de Gini et la courbe de Lorenz (mesurer les inégalités) et La convexité et les inégalités.