← Tous les textes du Grand Oral
MathsSVTHGGSP
Combien y a-t-il de poissons dans un étang, de loups dans les Alpes, de baleines dans l'Atlantique Nord ? On ne peut pas les compter un par un : ils se cachent, ils bougent, et l'on ne sait jamais si l'on n'a pas compté deux fois le même. Les écologues utilisent depuis plus d'un siècle une idée très simple : marquer quelques animaux, les relâcher, puis regarder quelle proportion d'animaux marqués on retrouve dans une seconde capture.
Derrière cette idée de proportionnalité se cachent les probabilités de terminale : loi binomiale, espérance, inégalité de Bienaymé-Tchebychev, et même une étude de fonction par la dérivée. La même méthode a servi à Laplace pour estimer la population de la France en 1802, et sert aujourd'hui à estimer des populations humaines « cachées ».
Ce texte rassemble ces connaissances. Il ne propose pas de Grand Oral tout fait : à chacun d'y choisir une direction et d'y construire sa question.
- L'idée : marquer, relâcher, recapturer
- Un modèle probabiliste : la loi binomiale
- Pourquoi cette estimation ? Le maximum de vraisemblance
- Quelle confiance accorder au résultat ?
- Pêcher mille fois : simulation
- Les hypothèses et les biais
- Laplace et la population de la France
- En écologie aujourd'hui
- Des populations humaines cachées
- Des directions pour construire sa question
Un étang contient un nombre inconnu $N$ de poissons. Un premier jour, on en pêche $M = 200$, on fixe sur chacun une petite marque, et on les relâche. On attend quelques jours qu'ils se mélangent aux autres.
Un second jour, on pêche $n = 150$ poissons, et l'on compte parmi eux $X = 30$ poissons marqués.
Si les poissons marqués sont bien mélangés, la proportion de marqués dans la seconde pêche doit être proche de leur proportion dans l'étang :
$$\frac{30}{150} \approx \frac{200}{N}.$$Or $\frac{30}{150} = 0{,}2$, donc $\frac{200}{N} \approx 0{,}2$, ce qui donne $N \approx \frac{200}{0{,}2} = 1\,000$. Un poisson sur cinq est marqué, donc l'étang contient environ cinq fois plus de poissons qu'on n'en a marqué.
Dans le cas général, on marque $M$ animaux, on en recapture $n$, et l'on trouve $X$ marqués parmi eux. L'égalité des proportions $\frac{X}{n} \approx \frac{M}{N}$ donne l'estimation
$$\widehat{N} = \frac{M \times n}{X}.$$(On note $\widehat{N}$, « $N$ chapeau », pour rappeler que c'est une estimation et non la vraie valeur.) Elle porte le nom de deux biologistes : le Danois Carl Georg Johannes Petersen, qui marquait des plies (des poissons plats) à la fin du XIXe siècle, et l'Américain Frederick Lincoln, qui l'a appliquée en 1930 aux canards bagués dont les chasseurs renvoyaient les bagues.
Trois questions se posent aussitôt, et les mathématiques de terminale permettent d'y répondre :
- pourquoi cette estimation plutôt qu'une autre ?
- avec quelle précision : le vrai $N$ est-il plutôt entre $900$ et $1\,100$, ou entre $500$ et $10\,000$ ?
- à quelles conditions la méthode est-elle valable ?
Pour la seconde pêche, faisons les hypothèses suivantes :
- la population est fermée : entre les deux pêches, aucun poisson ne naît, ne meurt, n'arrive ni ne part, donc $N$ et $M$ ne changent pas ;
- les marques ne se perdent pas, et tous les poissons, marqués ou non, ont la même chance d'être pris ;
- on pêche les poissons un par un : on regarde chaque poisson pris, on note s'il est marqué, et on le relâche aussitôt. Les $n$ prises sont donc des épreuves identiques et indépendantes.
À chaque prise, la probabilité de tomber sur un poisson marqué est alors
$$p = \frac{M}{N}.$$Chaque prise est une épreuve de Bernoulli de paramètre $p$ (succès : « le poisson est marqué »), et l'on en répète $n$ de façon indépendante. Le nombre $X$ de poissons marqués parmi les $n$ prises suit donc la loi binomiale $\mathcal{B}(n ; p)$ :
$$P(X = k) = \binom{n}{k} p^k (1 - p)^{n - k}.$$Si l'on garde les poissons au lieu de les relâcher un par un, les prises ne sont plus indépendantes (la loi exacte s'appelle alors hypergéométrique) ; mais quand $n$ est petit devant $N$, la loi binomiale en reste une très bonne approximation.
Le cours donne $E(X) = np = \frac{nM}{N}$. Avec $N = 1\,000$, $M = 200$ et $n = 150$, on attend en moyenne $150 \times 0{,}2 = 30$ poissons marqués : c'est exactement ce qu'on a observé dans l'exemple. Mais $X$ est aléatoire. Avec ces valeurs, la probabilité d'obtenir exactement $30$ marqués n'est que
$$\begin{aligned} P(X = 30) &= \binom{150}{30} \times 0{,}2^{30} \times 0{,}8^{120} \\ &\approx 0{,}081. \end{aligned}$$Une autre pêche aurait pu donner $25$ ou $36$ marqués, et donc une estimation de $1\,200$ ou d'environ $833$ poissons. Toute la question est de savoir de combien l'estimation risque de s'écarter de la vraie valeur.
La fréquence $F = \frac{X}{n}$ des marqués a pour espérance $p$, et la loi des grands nombres dit que plus $n$ est grand, plus il est probable que la fréquence $F$ soit proche de $p = \frac{M}{N}$. C'est ce qui justifie l'idée de départ : remplacer $\frac{M}{N}$ par la fréquence observée.
Retournons la question. On a observé $X = k$. Parmi toutes les valeurs possibles de $p$ (donc de $N$), laquelle rend cette observation la plus probable ? C'est le principe du maximum de vraisemblance, imaginé par le statisticien Ronald Fisher au début du XXe siècle. On étudie, pour $k$ et $n$ fixés, la fonction
$$f(p) = p^k (1 - p)^{n - k}, \quad p \in [0 ; 1],$$qui est égale à $P(X = k)$ au facteur constant $\binom{n}{k}$ près.
Étape 1 : la dérivée. $f$ est un produit $u \times v$ avec $u(p) = p^k$ et $v(p) = (1 - p)^{n-k}$. On a $u'(p) = k\,p^{k-1}$ et, par la dérivée d'une composée, $v'(p) = -(n - k)(1 - p)^{n-k-1}$. Donc $f' = u'v + uv'$ avec
$$u'(p)\,v(p) = k\,p^{k-1}(1-p)^{n-k}$$et
$$\begin{aligned} &u(p)\,v'(p) \\ &= -(n-k)\,p^k(1-p)^{n-k-1}. \end{aligned}$$Étape 2 : on factorise. Les deux termes contiennent $A = p^{k-1}(1-p)^{n-k-1}$, donc
$$f'(p) = A \times \big(k(1-p) - (n-k)p\big).$$Dans la grande parenthèse,
$$\begin{aligned} & k(1-p) - (n-k)p \\ &= k - kp - np + kp \\ &= k - np. \end{aligned}$$Donc $f'(p) = A \times (k - np)$.
Étape 3 : le signe. Sur $]0 ; 1[$, le facteur $A$ est strictement positif. Le signe de $f'(p)$ est donc celui de $k - np$ : positif si $p < \frac{k}{n}$, négatif si $p > \frac{k}{n}$.
Étape 4 : conclusion. $f$ est croissante sur $\left[0 ; \frac{k}{n}\right]$ et décroissante sur $\left[\frac{k}{n} ; 1\right]$ : elle atteint son maximum en $p = \frac{k}{n}$.
La valeur de $p$ qui rend l'observation la plus probable est donc la fréquence observée $\frac{k}{n}$, et comme $p = \frac{M}{N}$, la valeur de $N$ correspondante est $N = \frac{Mn}{k}$ : on retrouve exactement la formule de Lincoln-Petersen. L'intuition de la proportionnalité est confirmée par une étude de fonction.
La figure ci-dessous trace, pour $M = 200$ et $n = 150$, la probabilité d'observer $k$ poissons marqués en fonction du nombre $N$ de poissons de l'étang. Le curseur règle $k$.
Notons $F = \frac{X}{n}$ la fréquence de marqués dans la seconde pêche. Par linéarité de l'espérance et propriété de la variance, $E(F) = \frac{E(X)}{n} = p$ et
$$\begin{aligned} V(F) &= \frac{V(X)}{n^2} = \frac{np(1-p)}{n^2} \\ &= \frac{p(1-p)}{n}. \end{aligned}$$Étape 1 : l'inégalité de Bienaymé-Tchebychev. Pour tout réel $\delta > 0$,
$$P\big(|F - p| \geqslant \delta\big) \leqslant \frac{V(F)}{\delta^2} = \frac{p(1-p)}{n\,\delta^2}.$$Étape 2 : on majore $p(1-p)$, que l'on ne connaît pas. Pour tout réel $p$,
$$\begin{aligned} \frac{1}{4} - p(1-p) &= p^2 - p + \frac{1}{4} \\ &= \left(p - \frac{1}{2}\right)^2 \geqslant 0, \end{aligned}$$donc $p(1-p) \leqslant \frac{1}{4}$, et $P\big(|F - p| \geqslant \delta\big) \leqslant \frac{1}{4n\delta^2}$.
Étape 3 : on choisit $\delta$. Avec $\delta = \sqrt{\frac{5}{n}}$, on a $\delta^2 = \frac{5}{n}$, donc $\frac{1}{4n\delta^2} = \frac{1}{20} = 0{,}05$. Ainsi $P\big(|F - p| \geqslant \delta\big) \leqslant 0{,}05$, et par l'événement contraire $P\big(|F - p| < \delta\big) \geqslant 0{,}95$.
On passe ensuite de $p$ à $N$ :
Étape 1. L'inégalité $|F - p| < \delta$ équivaut à $F - \delta < p < F + \delta$.
Étape 2. On suppose $F - \delta > 0$. La fonction $x \mapsto \frac{M}{x}$ est strictement décroissante sur $]0 ; +\infty[$ (sa dérivée $-\frac{M}{x^2}$ est négative) : elle inverse l'ordre. Comme $N = \frac{M}{p}$,
$$\frac{M}{F + \delta} < N < \frac{M}{F - \delta}.$$Dans l'exemple, $F = 0{,}2$ et $\delta = \sqrt{\frac{5}{150}} \approx 0{,}183$, donc
$$\frac{200}{0{,}383} < N < \frac{200}{0{,}017},$$c'est-à-dire, en arrondissant, $523 \leqslant N \leqslant 11\,477$. L'encadrement est garanti, mais il est très large : l'inégalité de Bienaymé-Tchebychev vaut pour toutes les lois, elle ne profite pas de ce que l'on sait de la loi binomiale. Remarquons aussi que l'encadrement n'est pas symétrique autour de $1\,000$ : c'est l'effet de la fonction inverse, qui étire les petites valeurs de $p$.
Pour la loi binomiale, on utilise au lycée l'intervalle de confiance au niveau 95 % : $\left[F - \frac{1}{\sqrt{n}} ; F + \frac{1}{\sqrt{n}}\right]$ ; il est admis, et on l'emploie quand $n \geqslant 25$ et que $F$ est entre $0{,}2$ et $0{,}8$ (voir le texte La méthode de Monte-Carlo). Dans l'exemple, $\frac{1}{\sqrt{150}} \approx 0{,}082$ et le même raisonnement donne
$$\frac{200}{0{,}282} \leqslant N \leqslant \frac{200}{0{,}118},$$soit environ $711 \leqslant N \leqslant 1\,689$. Pour resserrer l'encadrement, il faut un plus grand $n$ : la largeur $\frac{2}{\sqrt{n}}$ est divisée par $2$ quand $n$ est multiplié par $4$.
| seconde pêche | marqués | $F$ | $\frac{1}{\sqrt{n}}$ | encadrement de $N$ |
|---|---|---|---|---|
| $n = 150$ | $30$ | $0{,}2$ | $0{,}082$ | $711$ à $1\,689$ |
| $n = 600$ | $120$ | $0{,}2$ | $0{,}041$ | $831$ à $1\,256$ |
Le tableur ci-dessous fait ces calculs pour vos propres valeurs (modifiez les cellules jaunes et validez par Entrée).
Attention : si $F - \frac{1}{\sqrt{n}}$ est négatif, le « N maximum » affiché n'a pas de sens : l'encadrement ne donne alors aucune borne supérieure.
Dans la figure suivante, l'étang contient en réalité $N = 1\,000$ poissons. Réglez le nombre $M$ de poissons marqués et le nombre $n$ de prises, puis pêchez. Chaque pêche donne une estimation (un point) et un intervalle (le segment) : vert s'il contient la vraie valeur, rouge sinon.
Le programme suivant simule $1\,000$ secondes pêches dans un étang de $1\,000$ poissons, calcule à chaque fois l'estimation et l'intervalle, puis compte combien d'intervalles contiennent la vraie valeur, et quelle est la moyenne des estimations.
On observe en général qu'environ $99$ intervalles sur $100$ contiennent la vraie valeur (l'intervalle à $\frac{1}{\sqrt{n}}$ est prudent quand $p$ est loin de $\frac{1}{2}$), et que la moyenne des estimations dépasse $1\,000$, autour de $1\,030$. L'estimation de Lincoln-Petersen surestime légèrement $N$ en moyenne : elle contient $\frac{1}{X}$, et la fonction inverse est convexe, si bien qu'un $X$ trop petit fait monter l'estimation plus qu'un $X$ trop grand ne la fait baisser. Le statisticien Douglas Chapman a proposé en 1951 une formule corrigée, $\frac{(M+1)(n+1)}{X+1} - 1$, qui atténue ce défaut et reste définie quand $X = 0$.
Le calcul suppose que la seconde pêche est un tirage au hasard dans une population qui n'a pas bougé. Sur le terrain, chaque hypothèse peut être fausse, et l'on peut prévoir dans quel sens l'estimation se trompe.
- Des animaux méfiants. Un poisson déjà pris une fois évite parfois l'hameçon. Supposons que les marqués aient deux fois moins de chances d'être pris que les autres. Tout se passe comme si l'étang contenait $100$ marqués « efficaces » pour $800$ non marqués : la proportion de marqués dans les prises devient $\frac{100}{900} \approx 0{,}11$ au lieu de $0{,}2$. On attend alors environ $17$ marqués sur $150$, et l'estimation $\frac{200 \times 150}{17} \approx 1\,765$ surestime fortement la population.
- Des animaux attirés par le piège (par l'appât, par exemple) font l'inverse : on retrouve trop de marqués, et l'on sous-estime $N$.
- Des marques perdues font croire à des non-marqués : $X$ est trop petit et $N$ surestimé.
- Une population qui n'est pas fermée : naissances, morts, migrations entre les deux captures changent $N$ et la proportion de marqués. On choisit donc des captures rapprochées, ou des modèles plus élaborés qui suivent la population sur plusieurs années.
- Un mauvais mélange : si l'on marque près de la rive et que l'on repêche au même endroit, on retrouve trop de marqués.
- Des individus différents : certains animaux sont plus faciles à capturer que d'autres. Les mêmes sont alors pris deux fois, et l'on sous-estime la population. C'est l'un des défauts les plus difficiles à corriger.
La méthode moderne capture souvent les animaux plusieurs fois, et ajuste des modèles probabilistes qui tiennent compte de ces effets. Mais l'idée de départ reste la proportion de Lincoln-Petersen.
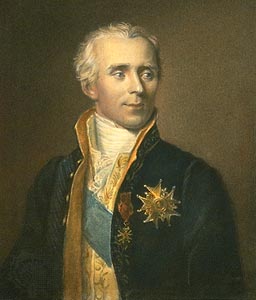
Au XVIIIe siècle, personne ne sait combien la France compte d'habitants : un recensement complet est long, coûteux et peu fiable. Dans un mémoire publié en 1786 par l'Académie des sciences, Pierre-Simon de Laplace propose une autre voie. Les curés enregistrent toutes les naissances du royaume : on connaît donc assez bien le nombre total de naissances annuelles. Si l'on connaît aussi le rapport entre la population et les naissances, une multiplication suffit.
Le Consulat lui donne l'occasion d'appliquer l'idée. Dans trente départements répartis sur tout le territoire, on choisit des communes dont on dénombre soigneusement les habitants : $2\,037\,615$ au 22 septembre 1802. On y relève les naissances de 1800, 1801 et 1802 : $110\,312$ garçons et $105\,287$ filles, soit environ $71\,866$ naissances par an. Le rapport de la population aux naissances annuelles est donc
$$\frac{2\,037\,615}{71\,866} \approx 28{,}35.$$En supposant un million de naissances annuelles en France, Laplace obtient une population d'environ $28{,}35 \times 1\,000\,000$, soit $28\,352\,845$ habitants.
C'est exactement la capture-recapture, en changeant les mots :
| l'étang | la France de Laplace |
|---|---|
| les $M$ poissons marqués | le million de naissances de l'année, toutes enregistrées |
| la seconde pêche | les communes dénombrées |
| les marqués dans la pêche | les naissances dans ces communes |
| $N = \frac{M \times n}{X}$ | $\frac{1\,000\,000 \times 2\,037\,615}{71\,866}$ |
Laplace ne s'arrête pas là. Il se demande quelle est la probabilité que son résultat s'écarte de la vérité de plus d'une certaine quantité, et écrit dans son Essai philosophique sur les probabilités : « il y a près de trois cent mille à parier contre un que l'erreur de ce résultat n'est pas d'un demi-million ». C'est l'un des premiers calculs d'un niveau de confiance pour une estimation statistique. Le calcul suppose bien sûr que les communes choisies sont représentatives de la France entière, ce que Laplace cherchait à garantir en les répartissant sur tout le territoire.
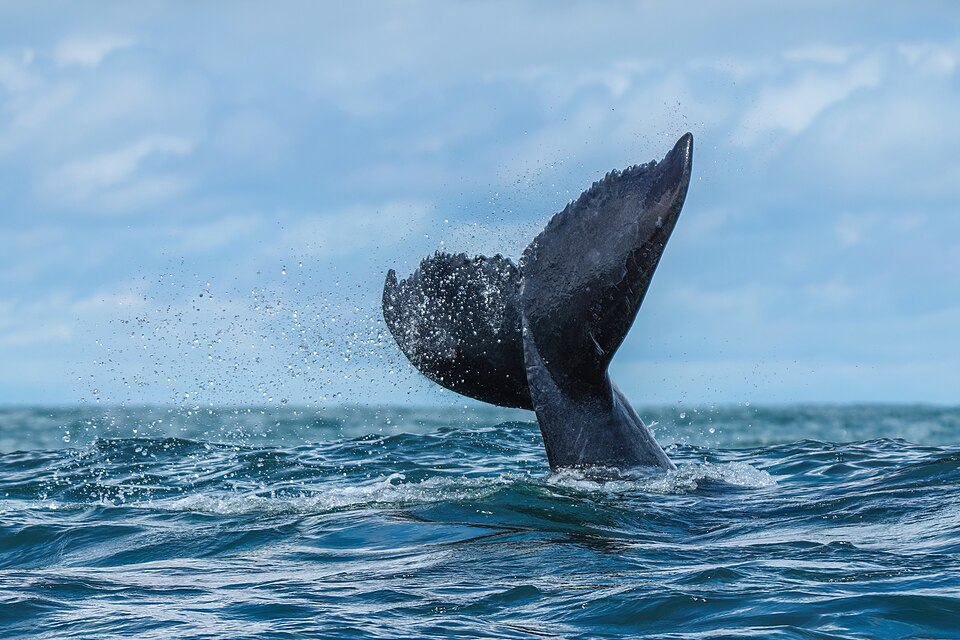
On ne pose pas de bague sur une baleine. Mais la face inférieure de la queue des baleines à bosse porte un motif unique, comme une empreinte digitale. Les chercheurs photographient les queues : une baleine photographiée une première fois est « marquée », et la retrouver sur une autre photo est une « recapture ». En 1992 et 1993, un vaste programme international (YoNAH) a photographié les baleines à bosse de l'Atlantique Nord sur leurs zones d'alimentation et de reproduction. L'étude publiée en 2003 estime la population à environ $11\,570$ baleines, avec un intervalle de confiance à 95 % allant de $10\,290$ à $13\,390$. Les auteurs précisent que l'estimation est peut-être un peu trop basse : certaines baleines sont plus souvent photographiées que d'autres, le dernier biais de la section précédente.
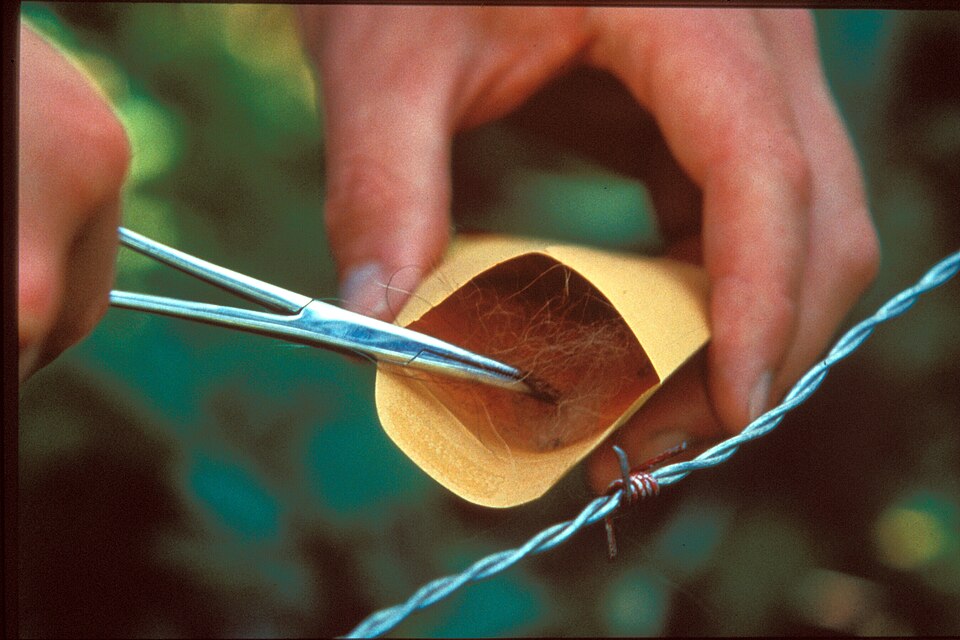
Pour les animaux rares et farouches, on « capture » l'ADN plutôt que l'animal. Dans le nord-ouest du Montana, en 2003 et 2004, une équipe de l'institut géologique américain (USGS) a tendu des fils barbelés autour de postes appâtés et le long des arbres où les ours se frottent. Environ $34\,000$ touffes de poils ont été récoltées, et l'analyse génétique a identifié $563$ grizzlis différents. Les modèles de capture-recapture, qui comparent combien d'ours ont été « pris » une fois, deux fois, ou plus, ont estimé la population totale à environ $765$ ours : plus du double de ce qu'on pensait.
En France, le suivi du loup repose sur la même idée. Les agents de l'Office français de la biodiversité et un réseau de correspondants récoltent des crottes, des poils, de l'urine ; l'ADN identifie les individus, et des modèles de capture-recapture estiment l'effectif. Pour la fin de l'hiver 2023-2024, l'estimation publiée est d'environ $1\,013$ loups, dans une fourchette de $920$ à $1\,125$. Ce chiffre a des conséquences directes : c'est à partir de lui que l'État fixe le nombre de loups qui peuvent être abattus pour protéger les troupeaux. Le débat entre éleveurs et défenseurs du loup porte donc aussi… sur une estimation statistique et son incertitude.
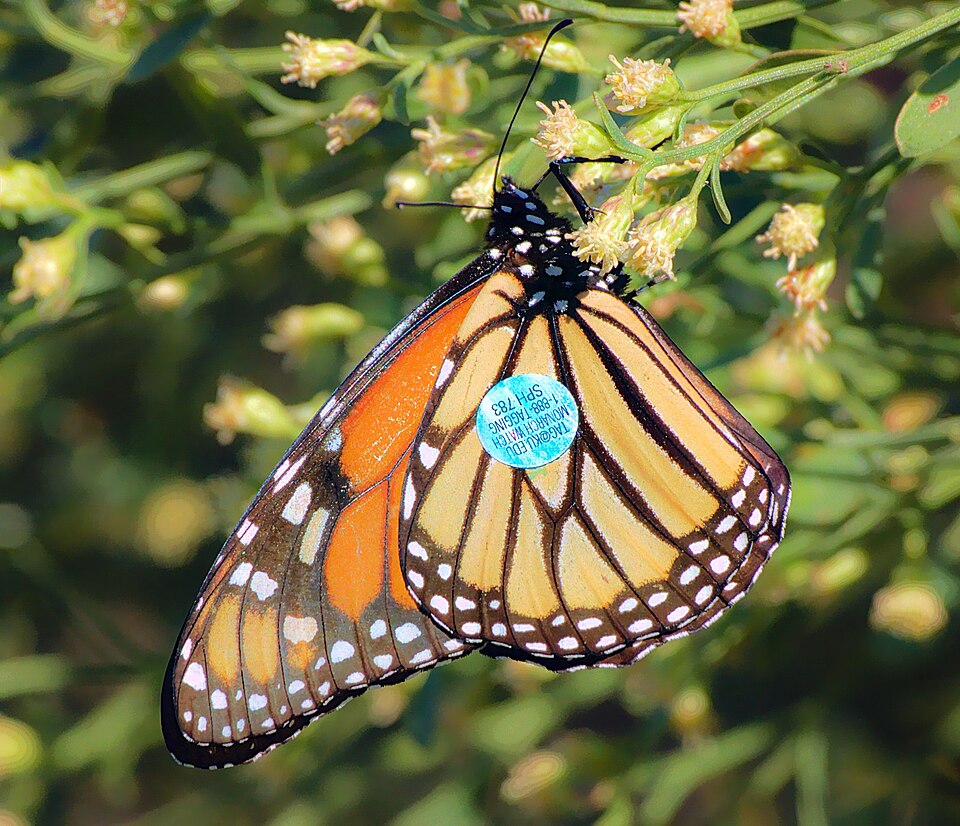
Le baguage des oiseaux, pratiqué depuis la fin du XIXe siècle, est la forme la plus ancienne de marquage : une bague numérotée à la patte, et chaque oiseau repris ou retrouvé renseigne sur les effectifs, les déplacements et la survie. En Amérique du Nord, des milliers de bénévoles collent chaque automne de petites étiquettes sur les ailes des papillons monarques avant leur migration vers le Mexique ; les étiquettes retrouvées servent surtout à reconstituer les routes de migration et la survie. Chez les tortues, on marque souvent la carapace par de petites encoches codées. Dans tous les cas, les mêmes questions reviennent : la marque gêne-t-elle l'animal, se perd-elle, l'échantillon est-il représentatif ?
La méthode s'applique aussi aux humains, quand on veut compter une population que personne ne recense entièrement. Le principe est de croiser deux listes indépendantes : la première joue le rôle des marqués, la seconde celui de la recapture.
Exemple fictif, pour comprendre. Dans une région, les hôpitaux ont soigné $n_1 = 240$ personnes atteintes d'une maladie au cours d'une année, et les médecins de ville en ont suivi $n_2 = 180$. En comparant les deux listes, on trouve $60$ personnes présentes dans les deux. Si les deux sources sont indépendantes, la proportion de patients « vus par l'hôpital » parmi ceux des médecins de ville, $\frac{60}{180} = \frac{1}{3}$, estime la proportion dans la population entière : le nombre total de malades est estimé à $\frac{240 \times 180}{60} = 720$, alors que seulement $240 + 180 - 60 = 360$ personnes figurent sur au moins une liste. La moitié des malades seraient invisibles pour les deux sources.
Cette approche sert en épidémiologie (estimer le nombre réel de cas d'une maladie, ou de personnes qui consomment des drogues) et dans l'étude des violences. Au Pérou, la Commission de la vérité et de la réconciliation a croisé en 2003 plusieurs listes de victimes du conflit armé des années 1980-2000, établies par des associations, par l'État et par la Commission elle-même. Elle a estimé le nombre de morts à environ $69\,000$, bien plus que le nombre de victimes nommément connues. Des travaux plus récents, avec des modèles plus fins, proposent des estimations un peu plus basses : preuve que le résultat dépend des hypothèses, en particulier de l'indépendance des listes. Ici, une estimation statistique devient un enjeu de mémoire et de justice.
Ce texte n'est pas un Grand Oral. Il rassemble des connaissances dans lesquelles chacun peut choisir une direction, la creuser et formuler sa propre question. Quelques directions possibles :
- Mathématiques : le modèle binomial et ses hypothèses ; le maximum de vraisemblance démontré par la dérivée ; l'encadrement par Bienaymé-Tchebychev et le passage de $p$ à $N$ par une fonction décroissante ; la surestimation expliquée par la convexité de la fonction inverse ; la simulation.
- SVT : le suivi des espèces protégées (loup, ours, baleines) ; la génétique comme outil de marquage ; les biais liés au comportement des animaux ; la biodiversité et les sciences participatives.
- HGGSP : compter les hommes avant les recensements, Laplace et l'État napoléonien ; les statistiques au service de la décision publique (le loup) ; compter les victimes d'un conflit.
Le jury peut interroger sur les chapitres de spécialité mobilisés. Avec ce thème, il est utile de connaître parfaitement : le schéma de
Bernoulli et la loi binomiale (formule, espérance, variance) ; la linéarité de l'espérance et la variance de $aX$ ;
l'inégalité de Bienaymé-Tchebychev et la loi des grands nombres ; la dérivation d'un produit et d'une composée, le lien entre signe de la
dérivée et variations ; la fonction inverse et la convexité ; les boucles et la fonction random en Python.
Pour réviser ces chapitres, l'application Maths FlashBac reprend tout le cours de spécialité en cartes.
- Capture-marquage-recapture (Wikipédia).
- Sur ce site : La paléodémographie (estimer une population disparue), La planche de Galton (loi binomiale et loi des grands nombres), La méthode de Monte-Carlo (intervalle de confiance), Prendre des décisions avec les probabilités et La dérive génétique.
- Animation : estimation et loi des grands nombres.