← Tous les textes du Grand Oral
MathsSESSVTHGGSP
Un test médical revient positif : faut-il s'inquiéter ? Un expert affirme qu'une coïncidence n'a qu'une chance sur des millions : faut-il condamner ? Une pièce donne $62$ fois pile sur $100$ : est-elle truquée ? Un sous-marin a disparu : où chercher d'abord ? Dans toutes ces situations, on doit décider sans être sûr, et les probabilités de terminale donnent des outils précis : probabilités conditionnelles, arbres pondérés, formule des probabilités totales, loi binomiale, inégalité de Bienaymé-Tchebychev.
Ce texte présente deux grandes manières de décider. La première, celle de Bayes, transforme ce qu'on croyait avant une observation en ce qu'on doit croire après. La seconde, celle des tests, se demande si une observation est compatible avec une hypothèse. Il rassemble des connaissances ; à chacun d'y choisir une direction et d'y construire sa question.
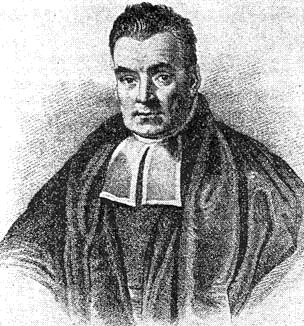
Thomas Bayes ne publie jamais son résultat. C'est son ami Richard Price qui le présente à la Royal Society en 1763, deux ans après sa mort. Pierre-Simon de Laplace le retrouve de son côté et en fait, à partir de 1774, un outil général pour « remonter des effets aux causes ». Le dépistage d'une maladie en est l'exemple le plus parlant.
Un test de dépistage n'est jamais parfait. On le décrit par trois nombres :
- la prévalence : la proportion de malades dans la population testée ;
- la sensibilité : la probabilité qu'un malade ait un test positif ;
- la spécificité : la probabilité qu'une personne saine ait un test négatif.
Prenons, pour l'exemple, une maladie qui touche $1\,\%$ de la population, et un test de sensibilité $99\,\%$ et de spécificité $95\,\%$. Ces nombres ne décrivent pas un test réel : ils sont choisis pour faire le calcul. Le test paraît excellent. Une personne prise au hasard est positive : quelle est la probabilité qu'elle soit malade ?
Beaucoup répondent « $99\,\%$ » ou « $95\,\%$ ». En 2007, le psychologue Gerd Gigerenzer a posé une question de ce type, sur le dépistage du cancer du sein, à environ $160$ gynécologues allemands lors d'une formation : d'après son article, à peine plus d'un sur cinq a choisi la bonne réponse parmi quatre propositions.
Imaginons $10\,000$ personnes testées. Il y a $1\,\%$ de malades, soit $100$ malades et $9\,900$ personnes saines.
- Parmi les $100$ malades, $99\,\%$ sont positifs : $99$ positifs.
- Parmi les $9\,900$ personnes saines, $95\,\%$ sont négatives, donc $5\,\%$ sont positives : $0{,}05 \times 9\,900 = 495$ positifs.
| Positif | Négatif | Total | |
|---|---|---|---|
| Malade | $99$ | $1$ | $100$ |
| Sain | $495$ | $9\,405$ | $9\,900$ |
| Total | $594$ | $9\,406$ | $10\,000$ |
Il y a $594$ positifs, dont seulement $99$ malades. La proportion de malades parmi les positifs est
$$\frac{99}{594} = \frac{1}{6} \approx 0{,}17.$$Un positif n'a donc qu'environ une chance sur six d'être malade. Le paradoxe vient de ce que les personnes saines sont très nombreuses : même un petit taux d'erreur ($5\,\%$) appliqué à $9\,900$ personnes donne beaucoup plus de faux positifs ($495$) qu'il n'y a de vrais positifs ($99$).
On choisit une personne au hasard et on note $M$ l'événement « la personne est malade » et $T$ l'événement « le test est positif ». L'énoncé donne $P(M) = 0{,}01$, $P_M(T) = 0{,}99$ et $P_{\overline{M}}(\overline{T}) = 0{,}95$, donc $P_{\overline{M}}(T) = 0{,}05$.
Étape 1 : les deux chemins qui mènent à $T$. Par la règle du produit sur les branches,
$$\begin{aligned} P(M \cap T) &= P(M) \times P_M(T) \\ &= 0{,}01 \times 0{,}99 = 0{,}0099, \end{aligned}$$ $$\begin{aligned} P(\overline{M} \cap T) &= P(\overline{M}) \times P_{\overline{M}}(T) \\ &= 0{,}99 \times 0{,}05 = 0{,}0495. \end{aligned}$$Étape 2 : la formule des probabilités totales. Les événements $M$ et $\overline{M}$ forment une partition de l'univers, donc
$$\begin{aligned} P(T) &= P(M \cap T) + P(\overline{M} \cap T) \\ &= 0{,}0099 + 0{,}0495 = 0{,}0594. \end{aligned}$$Étape 3 : la probabilité cherchée. Par définition d'une probabilité conditionnelle,
$$P_T(M) = \frac{P(M \cap T)}{P(T)} = \frac{0{,}0099}{0{,}0594} = \frac{1}{6}.$$On retrouve le résultat obtenu avec les effectifs : les deux méthodes sont les mêmes, l'arbre remplace les $10\,000$ personnes par des proportions.
Les trois étapes précédentes, écrites avec des lettres, donnent la formule de Bayes. Pour deux événements $M$ et $T$ de probabilités non nulles, avec $P(M) \neq 1$ :
$$P_T(M) = \frac{P(M) \times P_M(T)}{P(T)},$$où le dénominateur se calcule par la formule des probabilités totales :
$$P(T) = P(M) \, P_M(T) + P(\overline{M}) \, P_{\overline{M}}(T).$$Démonstration. Par définition, $P_T(M) = \dfrac{P(M \cap T)}{P(T)}$. Au numérateur, $P(M \cap T) = P(M) \times P_M(T)$. Au dénominateur, la formule des probabilités totales appliquée à la partition $\{M, \overline{M}\}$ donne $P(T) = P(M \cap T) + P(\overline{M} \cap T)$, et chaque terme s'écrit encore comme un produit. On remplace, et la formule est démontrée.
Cette formule « retourne » les probabilités conditionnelles : elle passe de $P_M(T)$, qu'on connaît (la qualité du test), à $P_T(M)$, qu'on cherche (le diagnostic). Confondre les deux est l'erreur la plus fréquente, et on va la retrouver au tribunal.
Gardons la sensibilité $s$ et la spécificité $c$ et faisons varier la prévalence $x \in [0\,;1]$. La formule de Bayes donne la probabilité d'être malade quand on est positif :
$$f(x) = \frac{s\,x}{s\,x + (1 - c)(1 - x)}.$$Posons $a = s$ et $b = 1 - c$, deux nombres strictement positifs. Le dénominateur $a x + b(1 - x)$ est strictement positif sur $[0\,;1]$. On dérive le quotient $\dfrac{u}{v}$ avec $u(x) = a x$ et $v(x) = (a - b)x + b$ :
$$\begin{aligned} f'(x) &= \frac{a\,\big((a - b)x + b\big) - a x\,(a - b)}{\big((a - b)x + b\big)^2} \\ &= \frac{a b}{\big((a - b)x + b\big)^2}. \end{aligned}$$Comme $ab > 0$, la fonction $f$ est strictement croissante : plus la maladie est fréquente dans la population testée, plus un test positif est fiable. C'est pour cela qu'on ne dépiste pas tout le monde pour une maladie rare, et qu'on réserve certains tests aux personnes qui ont déjà des symptômes ou des facteurs de risque : dans ce groupe, la « prévalence » est plus élevée.
Que faire d'un positif ? On le teste à nouveau, de préférence par un autre examen. Supposons que, pour une personne donnée, les résultats des deux tests soient indépendants sachant qu'elle est malade, et aussi sachant qu'elle est saine. Après le premier test, la probabilité d'être malade n'est plus $0{,}01$ mais $\dfrac{1}{6}$ : elle devient le nouveau point de départ de l'arbre. Si le second test est encore positif,
$$\begin{aligned} P &= \frac{\frac{1}{6} \times 0{,}99}{\frac{1}{6} \times 0{,}99 + \frac{5}{6} \times 0{,}05} \\ &= \frac{0{,}99}{0{,}99 + 0{,}25} \approx 0{,}80. \end{aligned}$$Un troisième positif ferait passer la probabilité à environ $0{,}99$. On voit apparaître l'idée centrale de Bayes : chaque observation met à jour une probabilité, qui sert de point de départ à la suivante. L'hypothèse d'indépendance est importante : refaire deux fois le même test sur le même prélèvement peut reproduire la même erreur, et ne rapporte alors presque rien.
Le programme suivant simule un dépistage sur $100\,000$ personnes et compte la proportion de malades parmi les positifs. On peut modifier la prévalence, la sensibilité et la spécificité.
D'une exécution à l'autre, la proportion change un peu : c'est une fréquence observée, pas une probabilité. La loi des grands nombres dit que plus le nombre de personnes simulées est grand, plus il est probable que cette fréquence soit proche de $\dfrac{1}{6}$.
Au tribunal, on dispose d'un indice $E$ (une trace, une coïncidence) et on veut savoir si l'accusé est coupable ($C$) ou innocent ($I$). Un expert peut souvent calculer $P_I(E)$ : la probabilité d'observer cet indice si l'accusé est innocent. Mais la question du juge est $P_E(I)$ : la probabilité que l'accusé soit innocent sachant qu'on a observé l'indice.
Confondre ces deux nombres s'appelle l'erreur du procureur. C'est exactement l'erreur du test médical : « le test se trompe rarement sur une personne saine » ne veut pas dire « une personne positive est rarement saine ». De même, « un innocent présente rarement cet indice » ne veut pas dire « une personne qui présente cet indice est rarement innocente ».
En Angleterre, Sally Clark, avocate, perd son premier bébé en 1996, puis son second en 1998, tous deux âgés de quelques semaines. Elle est accusée de les avoir tués. À son procès, en 1999, un pédiatre réputé, Roy Meadow, affirme que, dans une famille comme la sienne (aisée, sans fumeur), la probabilité d'une mort subite du nourrisson est d'environ $\dfrac{1}{8\,543}$, et que celle de deux morts subites est donc
$$\frac{1}{8\,543} \times \frac{1}{8\,543} = \frac{1}{72\,982\,849},$$soit « une chance sur $73$ millions ». Sally Clark est condamnée à la prison à perpétuité. Ce raisonnement contient deux erreurs graves.
Première erreur : l'indépendance. Multiplier les deux probabilités suppose que les deux décès sont des événements indépendants. Or des causes génétiques ou liées à l'environnement de la famille peuvent rendre un second décès plus probable quand un premier a eu lieu : la probabilité conditionnelle du second sachant le premier est alors plus grande que $\dfrac{1}{8\,543}$.
Seconde erreur : l'erreur du procureur. Même si le nombre était juste, il donnerait la probabilité de l'indice (deux décès) sachant l'innocence, et non la probabilité de l'innocence sachant l'indice. Il faut le comparer à l'autre explication : un double meurtre de nourrissons par leur mère, qui est lui aussi extrêmement rare. La formule de Bayes impose de comparer les deux hypothèses entre elles, pas l'une d'elles à zéro. En 2004, le statisticien Ray Hill a estimé, à partir des données britanniques, que deux morts subites dans une famille étaient plusieurs fois plus probables (il avançait un rapport de l'ordre de $4{,}5$ à $9$) qu'un double meurtre.
En 2001, la Royal Statistical Society écrit publiquement pour dénoncer l'usage du chiffre de $73$ millions. Sally Clark est libérée en appel en janvier 2003, notamment parce que des analyses médicales qui pouvaient l'innocenter n'avaient pas été transmises à la défense. Elle meurt en 2007. Son affaire a conduit à réexaminer d'autres condamnations fondées sur le même témoignage.
Une trace d'ADN est trouvée sur les lieux d'un crime. L'expert indique que la probabilité qu'une personne prise au hasard ait le même profil est d'une sur un million. On compare la trace à un fichier de $5$ millions de profils, et on trouve une correspondance. Est-ce le coupable ?
Un calcul à la main. Supposons que le coupable soit dans le fichier, et qu'aucun autre indice ne désigne qui que ce soit. Parmi les $5$ millions moins un innocents du fichier, chacun correspond par hasard avec une probabilité de $10^{-6}$. Le nombre d'innocents qui correspondent suit une loi binomiale d'espérance
$$\big(5 \times 10^6 - 1\big) \times 10^{-6} \approx 5.$$On s'attend donc à environ $5$ correspondances innocentes, en plus de celle du coupable : une personne qui correspond n'a qu'environ une chance sur six d'être le coupable. Si en plus le coupable n'est peut-être pas dans le fichier, c'est encore moins. « Une chance sur un million » était la probabilité de l'indice pour un innocent, pas la probabilité d'innocence de la personne trouvée.
La situation change complètement si un autre élément désigne d'abord un suspect (un témoin, un lien avec la victime) et qu'on ne compare la trace qu'à son profil : la probabilité de départ n'est plus $\dfrac{1}{5\,000\,000}$, et la correspondance devient très convaincante. En pratique, les profils utilisés aujourd'hui rendent les coïncidences beaucoup plus rares qu'une sur un million, mais les fichiers nationaux contiennent plusieurs millions de profils. La question s'est posée devant les tribunaux américains, par exemple dans l'affaire Puckett, à San Francisco en 2008 : le suspect avait été trouvé par une recherche dans le fichier californien, et le jury n'avait entendu que le chiffre d'une coïncidence sur environ un million.
On lance $100$ fois une pièce et on obtient $62$ fois pile. Est-elle truquée ? On ne connaît pas de probabilité « avant » que la pièce soit truquée : on ne peut pas utiliser Bayes. On raisonne autrement, par l'absurde « en probabilité ».
L'hypothèse. Supposons que la pièce soit équilibrée. Le nombre $X$ de piles suit alors la loi binomiale de paramètres $n = 100$ et $p = 0{,}5$ : les lancers sont $100$ épreuves de Bernoulli identiques et indépendantes. Son espérance est $E(X) = np = 50$ et sa variance $V(X) = np(1 - p) = 25$.
La zone de décision. On cherche les valeurs de $X$ qui sont « normales » sous cette hypothèse. Avec la calculatrice ou le programme plus bas, on lit dans la loi binomiale :
| $k$ | $38$ | $39$ | $40$ | $59$ | $60$ | $61$ |
|---|---|---|---|---|---|---|
| $P(X \leqslant k)$ | $0{,}010$ | $0{,}018$ | $0{,}028$ | $0{,}972$ | $0{,}982$ | $0{,}990$ |
Le plus petit entier $a$ tel que $P(X \leqslant a) > 0{,}025$ est $a = 40$ ; le plus petit entier $b$ tel que $P(X \leqslant b) \geqslant 0{,}975$ est $b = 60$. On en déduit
$$\begin{aligned} &P(40 \leqslant X \leqslant 60) \\ &= P(X \leqslant 60) - P(X \leqslant 39) \\ &\approx 0{,}982 - 0{,}018 = 0{,}965. \end{aligned}$$Sous l'hypothèse d'une pièce équilibrée, le nombre de piles est dans $[40\,;60]$ avec une probabilité d'au moins $95\,\%$. En fréquence, c'est l'intervalle $[0{,}40\,;0{,}60]$ : c'est un intervalle de fluctuation au seuil de $95\,\%$.
La décision. On a observé $62$, en dehors de l'intervalle. Soit la pièce est équilibrée et on a assisté à un événement de probabilité inférieure à $5\,\%$, soit l'hypothèse est fausse. La règle de décision est de rejeter l'hypothèse : on conclut que la pièce est probablement truquée. Avec $58$ piles, on n'aurait rien conclu : ce n'est pas une preuve que la pièce est équilibrée, seulement l'absence de raison de le contester.
Toute règle de décision fondée sur le hasard peut se tromper, de deux manières :
- rejeter à tort une hypothèse vraie : une pièce équilibrée donne quand même moins de $40$ ou plus de $60$ piles. Cela arrive avec la probabilité $P(X \leqslant 39) + P(X \geqslant 61) \approx 0{,}035$ ;
- ne pas rejeter une hypothèse fausse : la pièce est truquée, mais le résultat tombe dans l'intervalle. Si la probabilité de pile vaut en réalité $0{,}55$, le nombre de piles suit $\mathcal{B}(100\,;0{,}55)$, et le calcul donne $P(40 \leqslant X \leqslant 60) \approx 0{,}86$ : on ne détecte presque jamais une pièce aussi peu truquée avec $100$ lancers.
Pour réduire ce second risque, on augmente le nombre de lancers. Avec $1\,000$ lancers, l'intervalle devient $[469\,;531]$, soit $[0{,}469\,;0{,}531]$ en fréquence, et une pièce à $0{,}55$ n'y tombe plus qu'avec une probabilité d'environ $0{,}12$. C'est la loi des grands nombres : plus le nombre de lancers est grand, plus il est probable que la fréquence observée soit proche de la vraie probabilité, et plus l'intervalle de fluctuation est étroit. Le même équilibre se retrouve au tribunal (condamner un innocent ou relâcher un coupable) et en médecine (faux positifs et faux négatifs) : on ne peut pas faire baisser les deux risques à la fois sans recueillir plus d'informations.
Aux États-Unis, dans le comté d'Hidalgo, au Texas, un homme d'origine mexicaine, Rodrigo Partida, est condamné en 1972. Il conteste la composition des grands jurys du comté : d'après le recensement, $79{,}1\,\%$ de la population est d'origine mexicaine, mais sur onze ans, parmi les $870$ personnes appelées à siéger dans ces jurys, seulement $339$, soit environ $39\,\%$, le sont. En 1977, l'affaire arrive à la Cour suprême des États-Unis (Castaneda contre Partida, du nom du shérif).
Le calcul. Si les jurés étaient tirés au hasard dans la population, le nombre $X$ de jurés d'origine mexicaine suivrait (en première approximation) la loi binomiale de paramètres $n = 870$ et $p = 0{,}791$. Alors
$E(X) = 870 \times 0{,}791 \approx 688{,}2$ et $V(X) = 688{,}17 \times 0{,}209 \approx 143{,}8$, donc l'écart-type vaut $\sigma(X) \approx 12{,}0$.
L'écart observé est $688{,}2 - 339 \approx 349$, soit environ $29$ écarts-types. L'inégalité de Bienaymé-Tchebychev donne, sans aucun calcul de loi binomiale,
$$\begin{aligned} &P\big(|X - E(X)| \geqslant 349\big) \\ &\leqslant \frac{V(X)}{349^2} \approx \frac{143{,}8}{121\,801} \approx 0{,}0012. \end{aligned}$$C'est déjà très faible, et ce n'est qu'une majoration grossière : le calcul exact de $P(X \leqslant 339)$ par la loi binomiale donne une probabilité de l'ordre de $10^{-144}$. Dans sa décision, la Cour suprême indique qu'un écart de plus de deux ou trois écarts-types rend suspecte l'hypothèse d'une sélection au hasard, et elle donne raison à Partida : la sous-représentation constitue une présomption de discrimination que l'État du Texas n'a pas réfutée. C'est l'une des premières fois qu'un raisonnement de ce type est explicitement accepté par la Cour, et il sera repris dans d'autres affaires de discrimination à l'embauche.
Le test ne dit pas pourquoi l'écart existe. Il dit seulement que le hasard seul ne l'explique pas, et c'est au juge de chercher une autre explication.
Pour enchaîner plusieurs mises à jour, on écrit la formule de Bayes sous une autre forme. On appelle cote d'un événement $H$ le quotient $\dfrac{P(H)}{P(\overline{H})}$ : une probabilité de $0{,}8$ correspond à une cote de $4$ (« quatre contre un »).
Propriété. Pour une observation $E$ de probabilité non nulle,
$$\frac{P_E(H)}{P_E(\overline{H})} = \frac{P(H)}{P(\overline{H})} \times \frac{P_H(E)}{P_{\overline{H}}(E)}.$$Démonstration. Par définition, $P_E(H) = \dfrac{P(H \cap E)}{P(E)}$ $= \dfrac{P(H) \times P_H(E)}{P(E)}$, et de même $P_E(\overline{H}) = \dfrac{P(\overline{H}) \times P_{\overline{H}}(E)}{P(E)}$. En divisant la première égalité par la seconde, $P(E)$ se simplifie, ce qui donne la formule.
En mots : la cote après l'observation est la cote avant, multipliée par le rapport de vraisemblance $\dfrac{P_H(E)}{P_{\overline{H}}(E)}$, qui mesure à quel point l'observation est plus fréquente si $H$ est vraie. Pour le test médical, ce rapport vaut $\dfrac{0{,}99}{0{,}05} = 19{,}8$ : la cote passe de $\dfrac{1}{99}$ à $\dfrac{19{,}8}{99} = 0{,}2$, soit une probabilité de $\dfrac{0{,}2}{1{,}2} = \dfrac{1}{6}$. Si les observations sont indépendantes sachant $H$ et sachant $\overline{H}$, on multiplie simplement les rapports les uns après les autres.
En 2002, le programmeur Paul Graham publie un court article, A Plan for Spam, qui popularise les filtres « bayésiens » : le logiciel apprend, sur les messages que l'utilisateur a déjà classés, la fréquence de chaque mot dans les spams et dans les messages normaux. À l'arrivée d'un nouveau message, il part d'une cote de départ et la multiplie par le rapport de vraisemblance de chacun de ses mots.
Un exemple à la main, avec des fréquences choisies pour le calcul. Supposons que la moitié des messages reçus soient des spams : la cote de départ vaut $1$.
| Mot | dans un spam | dans un message normal | rapport |
|---|---|---|---|
| « gratuit » | $0{,}30$ | $0{,}02$ | $15$ |
| « gagnant » | $0{,}20$ | $0{,}01$ | $20$ |
| « réunion » | $0{,}01$ | $0{,}10$ | $0{,}1$ |
Un message contient « gratuit » et « gagnant » : sa cote devient $1 \times 15 \times 20 = 300$, soit une probabilité d'être un spam de $\dfrac{300}{301} \approx 0{,}997$. S'il contient aussi « réunion », la cote tombe à $30$, soit une probabilité de $\dfrac{30}{31} \approx 0{,}97$. L'hypothèse que les mots apparaissent indépendamment les uns des autres est fausse (on dit que le filtre est « naïf »), mais la méthode fonctionne bien en pratique, et elle s'adapte toute seule quand les spams changent de vocabulaire.
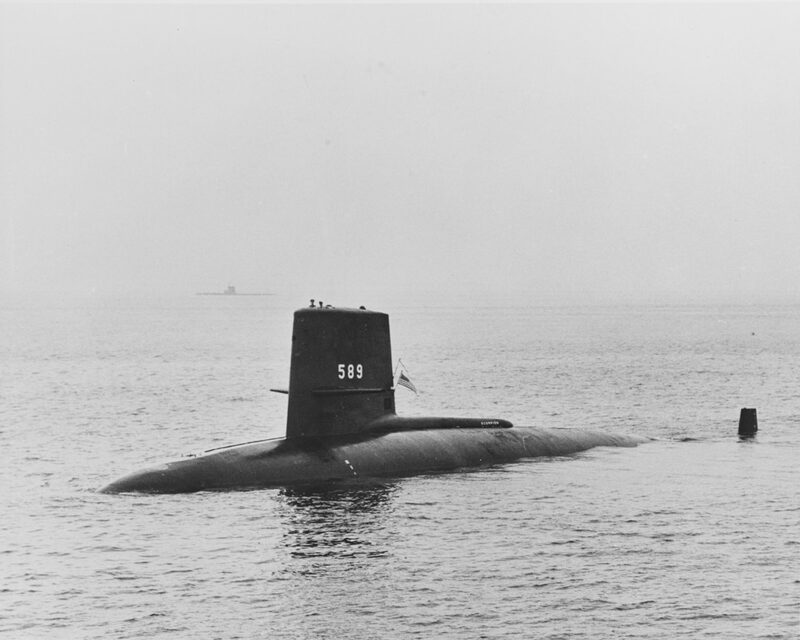
En mai 1968, le sous-marin nucléaire américain Scorpion disparaît dans l'Atlantique, au sud-ouest des Açores, avec $99$ hommes à bord. La zone possible est immense et profonde de plus de $3\,000$ mètres. L'ingénieur John Craven, qui avait déjà participé en 1966 à la recherche d'une bombe à hydrogène perdue au large de Palomares, en Espagne, organise la recherche avec la méthode de Bayes.
Il découpe la zone en cases. Avec des experts, il imagine plusieurs scénarios d'accident et leur demande de parier sur chacun : on obtient pour chaque case une probabilité « avant » que l'épave s'y trouve. On cherche d'abord dans la case la plus probable. Si on n'y trouve rien, on ne met pas sa probabilité à zéro, car on a pu passer à côté : on la diminue avec la formule de Bayes, et les autres cases augmentent. L'épave est localisée fin octobre 1968 par le navire Mizar, à quelques centaines de mètres du point le plus probable de la carte.
Le calcul d'une mise à jour. Deux zones $A$ et $B$ ont les probabilités $0{,}6$ et $0{,}4$ de contenir l'épave. Une recherche dans une zone qui contient l'épave la trouve avec une probabilité $d = 0{,}5$. On cherche dans $A$ et on ne trouve rien (événement $R$). Par les probabilités totales,
$$P(R) = 0{,}6 \times (1 - 0{,}5) + 0{,}4 \times 1 = 0{,}7.$$Par la formule de Bayes, $P_R(A) = \dfrac{0{,}6 \times 0{,}5}{0{,}7} \approx 0{,}43$ et $P_R(B) = \dfrac{0{,}4}{0{,}7} \approx 0{,}57$. Après une recherche vaine, c'est maintenant $B$ la zone la plus probable : la méthode dit d'aller chercher ailleurs, mais pas d'oublier $A$.
Plus généralement, si une case a la probabilité $p$ et qu'une recherche vaine y a eu lieu, sa nouvelle probabilité est $\dfrac{p(1 - d)}{1 - p\,d}$, et toute autre case de probabilité $q$ passe à $\dfrac{q}{1 - p\,d}$. Le programme suivant applique cette règle à une zone de $10$ cases.
Le $1^{\text{er}}$ juin 2009, le vol Air France 447 entre Rio de Janeiro et Paris disparaît au-dessus de l'Atlantique avec $228$ personnes à bord. Des débris flottants sont retrouvés dans les jours qui suivent, mais l'épave, à près de $4\,000$ mètres de profondeur, reste introuvable malgré trois campagnes de recherche.
En 2010, le Bureau d'enquêtes et d'analyses (BEA) confie à une société américaine spécialisée, Metron, une analyse bayésienne : elle combine la dernière position connue de l'avion, les scénarios de chute, la dérive des débris et, surtout, les recherches déjà faites, en tenant compte du fait qu'elles avaient pu échouer (par exemple si les balises acoustiques des enregistreurs ne fonctionnaient pas). La carte obtenue désigne une zone proche de la dernière position connue, que les premières recherches avaient pourtant couverte en partie. La quatrième campagne reprend là et retrouve l'épave le 3 avril 2011, après une semaine environ de recherche sous-marine. Les enregistreurs remontés ont permis de comprendre l'accident.
- La formule de Bayes demande une probabilité de départ. En médecine, elle vient de données (la prévalence) ; au tribunal ou dans une recherche d'épave, elle est souvent une estimation d'experts, et le résultat en dépend.
- Multiplier des probabilités suppose l'indépendance. L'affaire Sally Clark montre ce que coûte une indépendance supposée sans justification.
- Un test qui ne rejette pas l'hypothèse ne la prouve pas : il dit seulement que les données sont compatibles avec elle.
- Le seuil de $5\,\%$ est une convention. Si on fait vingt tests sur des hypothèses toutes vraies, on peut s'attendre à en rejeter une à tort. Choisir après coup le test qui « marche » fausse la conclusion, une dérive connue dans les publications scientifiques.
- Un calcul de probabilité éclaire une décision mais ne la prend pas : le juge, le médecin, le patient restent responsables, et la gravité des deux erreurs possibles (opérer pour rien, ne pas soigner) entre aussi en compte.
Ce texte n'est pas un Grand Oral. Il rassemble des connaissances dans lesquelles chacun peut choisir une direction, la creuser et formuler sa propre question. Quelques directions possibles :
- Mathématiques : la formule des probabilités totales et la formule de Bayes ; l'étude de la fonction qui donne la fiabilité d'un test selon la prévalence ; la loi binomiale et l'intervalle de fluctuation ; l'inégalité de Bienaymé-Tchebychev et la loi des grands nombres.
- SVT : le dépistage d'une maladie, les faux positifs et les faux négatifs, l'intérêt des tests répétés ; l'ADN comme indice et ses limites.
- SES : la discrimination mesurée par un écart à ce que donnerait le hasard ; la décision en situation d'incertitude ; l'apprentissage des filtres et des algorithmes.
- HGGSP : la preuve devant la justice, l'affaire Sally Clark, l'affaire Castaneda et les droits civiques aux États-Unis ; la recherche d'épaves pendant la guerre froide.
Le jury peut interroger sur les chapitres de spécialité mobilisés. Avec ce thème, il est utile de connaître parfaitement : les probabilités conditionnelles, les arbres pondérés et la formule des probabilités totales ; l'indépendance de deux événements ; la loi binomiale, son espérance et sa variance ; l'inégalité de Bienaymé-Tchebychev et la loi faible des grands nombres ; la dérivée d'un quotient et le sens de variation d'une fonction.
Pour réviser ces chapitres, l'application Maths FlashBac reprend tout le cours de spécialité en cartes.
- Théorème de Bayes, paradoxe du procureur et Sally Clark (Wikipédia).
- Bayesian search theory (Wikipédia, en anglais), sur la recherche du Scorpion et du vol AF447.
- Sur ce site : La paléodémographie (la formule de Bayes pour estimer l'âge d'un squelette), La méthode de Warner (un autre arbre pondéré), La planche de Galton (loi binomiale et loi des grands nombres) et La méthode de Monte-Carlo (intervalle de confiance).