← Tous les textes du Grand Oral
MathsSVTNSI
Pourquoi presque tous les Amérindiens d'Amérique du Sud sont-ils du groupe sanguin O ? Pourquoi une maladie de la vision presque inconnue ailleurs touche-t-elle un habitant sur vingt d'un atoll du Pacifique ? Pas forcément parce que ces caractères donnent un avantage : la composition génétique d'une population peut changer par le seul effet du hasard, d'une génération à l'autre. C'est la dérive génétique. Elle se décrit avec la loi binomiale, l'espérance, la variance, les suites géométriques et le logarithme, et se simule très bien sur ordinateur. Ce texte rassemble ces connaissances ; à chacun d'y choisir une direction et d'y construire sa question.
- Allèles, fréquences et équilibre de Hardy-Weinberg
- Le modèle de Wright-Fisher : une loi binomiale à chaque génération
- Un cas calculable à la main
- La diversité qui s'efface : une suite géométrique
- Qui finit par l'emporter ?
- Dérive et sélection
- Dans les populations réelles
- Simuler en Python
- Des directions pour construire sa question
Un gène peut exister sous plusieurs versions, les allèles. Pour le groupe sanguin du système ABO, par exemple, il y a trois allèles principaux, A, B et O. Chaque individu porte deux exemplaires du gène, l'un venu de sa mère, l'autre de son père : une population de $N$ individus contient donc $2N$ exemplaires du gène. La fréquence d'un allèle est la proportion de ces $2N$ exemplaires qui sont de cet allèle.
Considérons un gène à deux allèles $A$ et $a$, de fréquences $p$ et $q = 1 - p$. On suppose que les couples se forment au hasard et que chaque parent transmet l'un de ses deux exemplaires au hasard. Alors l'allèle reçu de la mère est $A$ avec la probabilité $p$, l'allèle reçu du père aussi, et ces deux événements sont indépendants. Le tableau de croisement donne les probabilités de chaque cas :
| allèle de la mère / du père | $A$ (probabilité $p$) | $a$ (probabilité $q$) |
|---|---|---|
| $A$ (probabilité $p$) | $AA$ : $p^2$ | $Aa$ : $pq$ |
| $a$ (probabilité $q$) | $aA$ : $qp$ | $aa$ : $q^2$ |
Les génotypes $Aa$ et $aA$ sont les mêmes : il y a deux façons d'obtenir un hétérozygote. D'où
$$\begin{gathered} P(AA) = p^2, \quad P(aa) = q^2, \\ P(Aa) = 2pq. \end{gathered}$$On vérifie que la somme vaut $p^2 + 2pq + q^2 = (p + q)^2 = 1$.
Un enfant $AA$ porte deux exemplaires $A$ sur deux, un enfant $Aa$ en porte un sur deux, un enfant $aa$ aucun. La fréquence de $A$ chez les enfants est donc
car $p + q = 1$.
Par exemple, si $p = 0{,}7$, les génotypes $AA$, $Aa$ et $aa$ ont pour fréquences $0{,}49$, $0{,}42$ et $0{,}09$, et la fréquence de $A$ reste $0{,}49 + 0{,}21 = 0{,}7$. C'est l'équilibre de Hardy-Weinberg, établi indépendamment en 1908 par le mathématicien britannique Godfrey Harold Hardy et le médecin allemand Wilhelm Weinberg, et étudié en enseignement scientifique en terminale, avec la dérive génétique.
Cet équilibre suppose une population infiniment grande, sans sélection, sans mutation et sans migration. La dérive génétique est ce qui se passe quand on renonce à la première hypothèse : dans une population de taille finie, les fréquences observées ne sont pas égales aux probabilités, et l'écart entre les deux change la population.
Dans les années 1930, le Britannique Ronald Fisher et l'Américain Sewall Wright proposent le modèle le plus simple d'une population finie. Ses hypothèses sont les suivantes.
- La population compte toujours $N$ individus, donc $2N$ exemplaires du gène.
- Les générations ne se chevauchent pas : les parents disparaissent quand naissent les enfants.
- Chacun des $2N$ exemplaires de la génération suivante est une copie d'un exemplaire de la génération actuelle choisi au hasard, indépendamment des autres.
Justification de la loi binomiale. Supposons qu'à une génération l'allèle $A$ ait la fréquence $p$. Pour fabriquer un exemplaire de la génération suivante, on tire au hasard un exemplaire de la génération actuelle : c'est une épreuve de Bernoulli, dont le succès « l'exemplaire tiré est un $A$ » a la probabilité $p$. On répète cette épreuve $2N$ fois, de façon indépendante : c'est un schéma de Bernoulli. Le nombre $X$ de succès, c'est-à-dire le nombre d'exemplaires $A$ de la génération suivante, suit donc la loi binomiale de paramètres $2N$ et $p$.
$X$ suit la loi binomiale de paramètres $2N$ et $p$ : pour tout entier $k$ de $0$ à $2N$,
$$P(X = k) = \tbinom{2N}{k}\,p^k(1-p)^{2N-k}.$$Ce que l'on cherche. La question qui intéresse le biologiste n'est pas le nombre d'exemplaires $A$, mais la fréquence de l'allèle $A$ à la génération suivante : a-t-elle changé par rapport à $p$, et de combien ? Cette fréquence s'obtient en divisant le nombre d'exemplaires $A$ par le nombre total d'exemplaires, $2N$. Notons-la $P'$ (le prime rappelle qu'il s'agit de la génération suivante) :
$$P' = \frac{X}{2N}.$$Par exemple, avec $N = 10$ individus, donc $20$ exemplaires, et $p = 0{,}5$ : si le hasard donne $X = 13$ exemplaires $A$ à la génération suivante, la nouvelle fréquence vaut $P' = \dfrac{13}{20} = 0{,}65$ ; l'allèle $A$ est passé de $50\,\%$ à $65\,\%$ sans aucun avantage, par le seul effet du hasard. Avant de faire le tirage, on ne connaît pas $X$, donc on ne connaît pas non plus $P'$ : comme $X$, la nouvelle fréquence est une variable aléatoire. Pour savoir comment elle se comporte, on calcule son espérance (autour de quelle valeur elle se place en moyenne) et sa variance (à quel point elle peut s'en écarter).
D'après le cours, une variable de loi binomiale de paramètres $n$ et $p$ a pour espérance $np$ et pour variance $np(1-p)$ : ici, $E(X) = 2Np$ et $V(X) = 2Np(1-p)$. On utilise ensuite les propriétés $E(aX) = aE(X)$ et $V(aX) = a^2V(X)$, avec $a = \dfrac{1}{2N}$ :
Ces deux résultats disent l'essentiel.
- L'espérance ne change pas : le hasard ne favorise aucun allèle. La dérive n'a pas de direction.
- La variance est inversement proportionnelle à la taille de la population : plus la population est petite, plus la fréquence risque de beaucoup varier d'une génération à la suivante.
Un calcul pour une petite population. Prenons $N = 10$ individus, donc $20$ exemplaires, et $p = 0{,}5$. La probabilité que la génération suivante ait exactement autant de $A$ que de $a$ est
La fréquence varie d'au moins $0{,}1$ si $|P' - 0{,}5| \geqslant 0{,}1$, c'est-à-dire si $X \leqslant 8$ ou $X \geqslant 12$. À la calculatrice, $P(9 \leqslant X \leqslant 11) \approx 0{,}497$, donc la probabilité cherchée vaut environ $1 - 0{,}497 = 0{,}503$ : une génération sur deux, la fréquence bouge d'au moins $0{,}1$. Le même calcul donne environ $0{,}006$ pour $N = 100$, et environ $4 \times 10^{-19}$ pour $N = 1\,000$.
Une majoration valable pour toute fréquence. L'inégalité de Bienaymé-Tchebychev appliquée à $P'$ donne, pour tout réel $\varepsilon > 0$,
$$P\big(|P' - p| \geqslant \varepsilon\big) \leqslant \frac{V(P')}{\varepsilon^2} = \frac{p(1-p)}{2N\varepsilon^2}.$$Or $p(1-p) \leqslant \dfrac{1}{4}$, car
Donc, quelle que soit la fréquence $p$,
$$P\big(|P' - p| \geqslant \varepsilon\big) \leqslant \frac{1}{8N\varepsilon^2}.$$Question de type bac : quelle taille de population garantit qu'en une génération, la fréquence varie d'au moins $0{,}05$ avec une probabilité au plus égale à $0{,}01$ ? Il suffit que $\dfrac{1}{8N \times 0{,}05^2} \leqslant 0{,}01$, c'est-à-dire $N \geqslant \dfrac{1}{8 \times 0{,}0025 \times 0{,}01} = 5\,000$ individus. Dans une grande population, la dérive est lente ; dans une petite, elle est rapide.
La figure montre aussi ce qui arrive à la longue : dans une petite population, chaque courbe finit par toucher $0$ ou $1$. Une fois à $0$, l'allèle a disparu, et il ne peut plus revenir sans mutation ; à $1$, il est fixé : tous les individus le portent. Ces deux états sont définitifs. La dérive, à elle seule, fait donc disparaître la diversité génétique.
Prenons le cas d'école le plus petit possible : une « population » de deux exemplaires du gène, l'un $A$ et l'autre $a$. Il y a trois états possibles, selon le nombre d'exemplaires $A$ : $0$, $1$ ou $2$. Depuis l'état $1$ (fréquence $\dfrac{1}{2}$), le nombre de $A$ à la génération suivante suit la loi binomiale de paramètres $2$ et $\dfrac{1}{2}$ :
$$P(0) = \frac{1}{4}, \quad P(1) = \frac{1}{2}, \quad P(2) = \frac{1}{4}.$$Depuis les états $0$ et $2$, on ne bouge plus.
Pour tout entier naturel $t$, notons $u_t$ la probabilité d'être dans l'état $1$ (encore mélangé) à la génération $t$, et $a_t$ la probabilité d'être dans l'état $2$ ($A$ fixé). Au départ, $u_0 = 1$ et $a_0 = 0$.
D'après la formule des probabilités totales, en distinguant l'état de la génération $t$ :
- on est dans l'état $1$ à la génération $t + 1$ seulement si l'on y était à la génération $t$, et qu'on y reste (probabilité $\dfrac{1}{2}$) : $u_{t+1} = \dfrac{1}{2}\,u_t$ ;
- on est dans l'état $2$ à la génération $t + 1$ si l'on y était déjà (on y reste avec la probabilité $1$), ou si l'on était dans l'état $1$ et qu'on passe à l'état $2$ (probabilité $\dfrac{1}{4}$) : $a_{t+1} = a_t + \dfrac{1}{4}\,u_t$.
La suite $(u_t)$ est géométrique de raison $\dfrac{1}{2}$ et de premier terme $1$, donc $u_t = \left(\dfrac{1}{2}\right)^t$.
Initialisation. Pour $t = 0$, $\dfrac{1}{2}(1 - 1) = 0 = a_0$.
Hérédité. Supposons la formule vraie pour un entier $t$, et notons $r = \left(\dfrac{1}{2}\right)^t$, de sorte que $u_t = r$ et $a_t = \dfrac{1}{2} - \dfrac{1}{2}r$. Alors
Comme $\dfrac{1}{2}r = \left(\dfrac{1}{2}\right)^{t+1}$, on obtient $a_{t+1} = \dfrac{1}{2}\left(1 - \left(\dfrac{1}{2}\right)^{t+1}\right)$.
et la formule est vraie au rang $t + 1$.
Conclusion. Elle est vraie pour tout entier naturel $t$.
Comme $0 < \dfrac{1}{2} < 1$, la suite $\left(\dfrac{1}{2}\right)^t$ tend vers $0$ : $u_t$ tend vers $0$ et $a_t$ tend vers $\dfrac{1}{2}$. Par symétrie entre $A$ et $a$, la probabilité que $A$ soit perdu tend aussi vers $\dfrac{1}{2}$. Par exemple, après $5$ générations, la population reste mélangée avec la probabilité $\dfrac{1}{32} \approx 0{,}03$. Ce petit calcul contient déjà les deux grands résultats de la suite : la diversité finit par disparaître, et chaque allèle l'emporte avec une probabilité égale à sa fréquence de départ.
Pour mesurer la diversité génétique d'une population, on utilise l'hétérozygotie $H = 2p(1-p)$ : c'est la probabilité que deux exemplaires du gène tirés au hasard soient différents (l'un $A$ et l'autre $a$, ou l'inverse). La fonction $p \mapsto 2p - 2p^2$ est un polynôme du second degré dont le maximum est atteint en $p = \dfrac{1}{2}$ : $H$ vaut au plus $\dfrac{1}{2}$, et $0$ quand un allèle est fixé.
Notons $K = E\big(P'(1-P')\big)$. Par linéarité de l'espérance, $K = E(P') - E(P'^2)$. La formule $V(P') = E(P'^2) - E(P')^2$ donne
Donc
En multipliant par $2$, l'espérance de l'hétérozygotie à la génération suivante vaut $\left(1 - \dfrac{1}{2N}\right)H$.
Notons $h_t$ l'espérance de l'hétérozygotie à la génération $t$. En admettant que l'on peut enchaîner ce calcul d'une génération à l'autre, la suite $(h_t)$ est géométrique de raison $1 - \dfrac{1}{2N}$ :
$$h_t = h_0\left(1 - \frac{1}{2N}\right)^t.$$Comme $0 < 1 - \dfrac{1}{2N} < 1$, elle tend vers $0$. Il faut bien lire ce résultat : il porte sur une espérance. Une population donnée peut perdre sa diversité plus vite ou plus lentement ; ce sont les moyennes sur un grand nombre de populations semblables qui suivent cette loi, comme le montre la figure.
On cherche le plus petit entier $t$ tel que $h_t \leqslant \dfrac{h_0}{2}$, c'est-à-dire $\left(1 - \dfrac{1}{2N}\right)^t \leqslant \dfrac{1}{2}$. La fonction $\ln$ est strictement croissante, donc cette inégalité équivaut à
$$t\,\ln\left(1 - \frac{1}{2N}\right) \leqslant \ln\frac{1}{2}.$$Comme $1 - \dfrac{1}{2N} < 1$, son logarithme est négatif : en divisant par ce nombre, on change le sens de l'inégalité,
$$t \geqslant \frac{\ln\frac{1}{2}}{\ln\left(1 - \frac{1}{2N}\right)}.$$Pour $N = 50$, $\ln(0{,}99) \approx -0{,}010\,05$ et l'on trouve $t \geqslant 68{,}97$ : il faut $69$ générations.
| $N$ (individus) | $10$ | $50$ | $1\,000$ | $10\,000$ |
|---|---|---|---|---|
| générations | $14$ | $69$ | $1\,386$ | $13\,863$ |
Le nombre de générations est à peu près proportionnel à $N$ : comme $\ln(1 + x) \approx x$ pour $x$ proche de $0$, on obtient $t \approx 2N\ln 2 \approx 1{,}4\,N$. Pour $10\,000$ individus, c'est plusieurs centaines de milliers d'années chez une espèce dont les générations durent vingt ou trente ans. La dérive est un phénomène des petites populations.
La probabilité de fixation. L'espérance de la fréquence ne change pas d'une génération à l'autre. On admet que cela reste vrai sur plusieurs générations : si $P_t$ désigne la fréquence de $A$ à la génération $t$, alors $E(P_t) = p_0$ pour tout $t$. On admet aussi qu'avec une probabilité qui tend vers $1$, la population finit par être fixée, à $0$ ou à $1$. Pour $t$ très grand, $P_t$ vaut donc $0$ ou $1$ avec une probabilité proche de $1$, et son espérance est à peu près la probabilité qu'elle vaille $1$. On en déduit
$$P(\text{l'allèle } A \text{ est fixé}) = p_0.$$Un allèle présent au départ chez $30\,\%$ des exemplaires a $30\,\%$ de chances de finir par être le seul. C'est ce que donnait le cas calculable à la main, avec $p_0 = \dfrac{1}{2}$. Une mutation qui vient d'apparaître est portée par un seul exemplaire sur $2N$ : si elle est neutre, elle a une probabilité $\dfrac{1}{2N}$ de finir par se répandre dans toute la population.
Disparaître dès la première génération. Un allèle porté par un seul exemplaire disparaît dès la génération suivante si aucun des $2N$ tirages ne le choisit. Chaque tirage l'évite avec la probabilité $1 - \dfrac{1}{2N}$, et les tirages sont indépendants : la probabilité cherchée est $\left(1 - \dfrac{1}{2N}\right)^{2N}$. Elle vaut environ $0{,}349$ pour $5$ individus, $0{,}366$ pour $50$ et $0{,}368$ pour $500$.
Pour $n \geqslant 2$, posons $v_n = \left(1 - \dfrac{1}{n}\right)^n$ et $h = -\dfrac{1}{n}$. Alors
Quand $n$ tend vers $+\infty$, $h$ tend vers $0$, et le quotient tend vers le nombre dérivé de la fonction $\ln$ en $1$, qui vaut $\dfrac{1}{1} = 1$. Donc $\ln v_n$ tend vers $-1$, et, par continuité de la fonction exponentielle, $v_n$ tend vers $\mathrm{e}^{-1} \approx 0{,}368$.
Plus d'un tiers des mutations nouvelles disparaissent donc dès la première génération, quelle que soit la taille de la population.
Darwin a expliqué l'évolution par la sélection naturelle : un allèle qui donne un avantage de survie ou de reproduction se répand. Ajoutons-la au modèle. Si les porteurs de $A$ laissent en moyenne $1 + s$ fois plus de descendants que les autres (avec $s = 0{,}01$ pour un avantage de $1\,\%$), la probabilité de tirer un $A$ n'est plus $p$ mais $f(p)$, où
$$f(x) = \frac{x(1+s)}{1 + sx} \quad\text{pour } x \in [0\,;1].$$Dans une très grande population, la variance est presque nulle et la fréquence suit la suite définie par $p_0$ et $p_{t+1} = f(p_t)$. Étudions-la comme dans un sujet de bac, avec $s > 0$ et $0 < p_0 < 1$.
1. Variations de $f$. On dérive le quotient $\dfrac{u}{v}$ avec $u(x) = (1+s)x$ et $v(x) = 1 + sx$, donc $u'(x) = 1 + s$ et $v'(x) = s$. Le numérateur de la dérivée est $u'v - uv'$, avec $u'v = (1+s)(1+sx)$ et $uv' = (1+s)\,sx$ :
En mettant $1 + s$ en facteur, $u'v - uv' = (1+s)(1 + sx - sx)$, soit $u'v - uv' = 1 + s$.
donc $f'(x) = \dfrac{1+s}{(1+sx)^2} > 0$ : $f$ est strictement croissante sur $[0\,;1]$, avec $f(0) = 0$ et $f(1) = 1$.
2. Encadrement. Par récurrence, $0 < p_t < 1$ pour tout $t$ : c'est vrai pour $p_0$, et si $0 < p_t < 1$, la stricte croissance de $f$ donne $f(0) < f(p_t) < f(1)$, soit $0 < p_{t+1} < 1$.
3. Sens de variation. Pour $x$ dans $[0\,;1]$, notons $d(x) = f(x) - x$. En réduisant au même dénominateur,
donc $p_{t+1} - p_t = d(p_t) \geqslant 0$ : la suite est croissante.
4. Limite. Croissante et majorée par $1$, la suite converge vers un réel $\ell$, avec $p_0 \leqslant \ell \leqslant 1$. Comme $f$ est continue, $f(\ell) = \ell$, donc $\dfrac{s\,\ell(1-\ell)}{1+s\ell} = 0$, c'est-à-dire $\ell = 0$ ou $\ell = 1$. Comme $\ell \geqslant p_0 > 0$, on obtient $\ell = 1$ : dans une très grande population, l'allèle avantagé finit par s'imposer.
Combien de temps ? On a $1 - f(x) = \dfrac{1 - x}{1 + sx}$, donc
$$\frac{f(x)}{1 - f(x)} = (1 + s)\,\frac{x}{1 - x}.$$Le rapport $r_t = \dfrac{p_t}{1 - p_t}$ est donc une suite géométrique de raison $1 + s$ : $r_t = r_0(1+s)^t$. Pour passer d'une fréquence de $1\,\%$ ($r_0 = \frac{1}{99}$) à une fréquence de $99\,\%$ ($r_t = 99$) avec un avantage de $1\,\%$, il faut $(1{,}01)^t \geqslant 99^2 = 9\,801$, soit $t \geqslant \dfrac{\ln 9\,801}{\ln 1{,}01} \approx 923{,}6$ : environ $924$ générations.
Quand la dérive s'en mêle. Dans une population finie, la dérive se superpose à la sélection, et une mutation avantageuse peut très bien disparaître par malchance, surtout tant qu'elle est rare. En 1927, le généticien britannique John Haldane a montré que la probabilité de fixation d'une mutation nouvelle avantageuse est d'environ $2s$ : une mutation qui donne $1\,\%$ d'avantage a seulement environ $2\,\%$ de chances de s'imposer. Inversement, dans une petite population, un allèle légèrement défavorable peut se fixer. La première figure le montre : avec un avantage $s = 5\,\%$, une grande population fixe presque toujours l'allèle avantagé, une petite beaucoup moins sûrement.
C'est l'idée de la théorie neutre de l'évolution moléculaire, proposée en 1968 par le généticien japonais Motoo Kimura : une grande partie des différences entre les ADN de deux espèces ne vient pas de la sélection, mais de mutations sans effet qui se sont fixées par dérive. Comme les mutations neutres se fixent à un rythme à peu près régulier, elles servent d'« horloge moléculaire » pour dater la séparation de deux espèces.
L'effet fondateur. Quand quelques individus fondent une nouvelle population, ils n'emportent qu'un petit échantillon des allèles de la population d'origine, avec des fréquences qui peuvent en être très éloignées : c'est une seule génération de dérive, mais avec un tout petit effectif. La nouvelle population hérite ensuite durablement de ce hasard.
- Le groupe O en Amérique du Sud : dans le système ABO, l'allèle O est très majoritaire chez les Amérindiens, et de nombreuses populations d'Amérique du Sud sont presque entièrement du groupe O, alors que les allèles A et B sont répandus partout ailleurs. L'explication la plus admise est un effet fondateur : l'Amérique a été peuplée il y a plus de $15\,000$ ans, par la Béringie, à partir d'un petit nombre d'individus, puis les populations se sont dispersées en petits groupes, où la dérive a pu éliminer les allèles A et B. Aucun avantage du groupe O n'a été établi, même si quelques hypothèses de sélection ont été proposées.
- Le rhésus négatif chez les Basques : le facteur rhésus est un autre système de groupes sanguins. Les Basques ont l'une des plus fortes proportions de personnes de rhésus négatif au monde, ce que l'on rattache à l'histoire d'une population longtemps relativement isolée.
- L'atoll de Pingelap : vers 1775, un typhon et la famine qui suivit ne laissèrent qu'une vingtaine de survivants sur cet atoll de Micronésie. L'un d'eux portait un allèle d'une maladie héréditaire de la vision, l'achromatopsie (une vision sans couleurs). Elle touche aujourd'hui environ un habitant sur vingt de l'île, contre environ une personne sur $30\,000$ dans le monde.
- Les Amish et le Québec : les communautés amish de Pennsylvanie, issues de quelques centaines de fondateurs et mariées entre elles, présentent des fréquences élevées de maladies génétiques rares, comme le syndrome d'Ellis-van Creveld. Au Québec, plusieurs maladies héréditaires sont beaucoup plus fréquentes qu'en France, en particulier dans la région du Saguenay-Lac-Saint-Jean, peuplée par un petit nombre de familles.
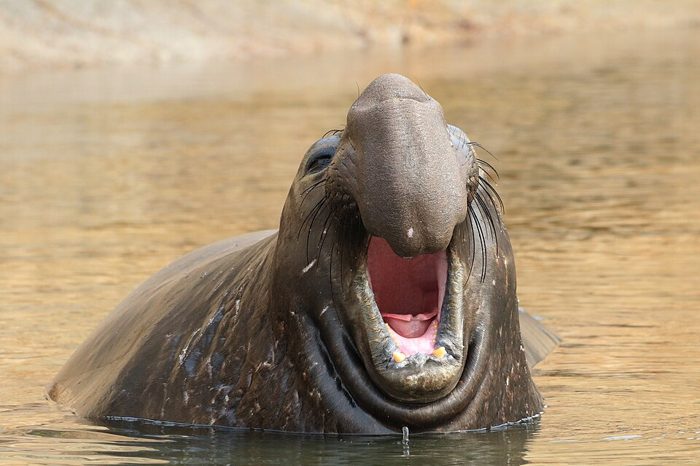
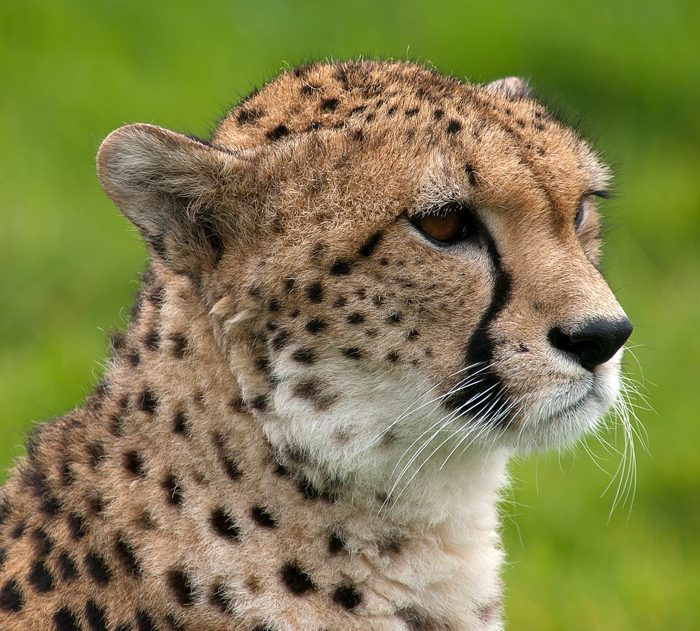
Les goulots d'étranglement. Une population qui a été réduite à quelques individus garde la trace de cet épisode, même si elle redevient nombreuse. Chassé pour son huile, l'éléphant de mer du Nord a été réduit à une vingtaine ou une centaine d'individus à la fin du XIXe siècle ; protégé, il compte aujourd'hui plus de $200\,000$ individus, mais sa diversité génétique est extrêmement faible. Le guépard a connu un goulot d'étranglement il y a une dizaine de milliers d'années ; les individus sont si semblables génétiquement que, dans des expériences des années 1980, des greffes de peau entre guépards non apparentés n'ont pas été rejetées. Une faible diversité rend une espèce plus vulnérable aux maladies et aux changements de son milieu : c'est un enjeu majeur de la biologie de la conservation, qui cherche à maintenir des populations assez grandes et reliées entre elles.
Le programme simule $1\,000$ populations de $N$ individus et compte celles où l'allèle $A$ a fini par être fixé. On peut changer $N$ et $p_0$ et exécuter (dans le navigateur, mieux vaut garder $N$ petit).
Il faut lire le résultat avec la rigueur de la loi des grands nombres : sur $1\,000$ populations, il est très probable que la fréquence de fixation soit proche de $p_0$, mais elle n'est pas égale à $p_0$, et elle change d'une exécution à l'autre.
- Coût : chaque génération demande $2N$ tirages ; pour de grandes populations, on tire directement un nombre selon la loi binomiale, avec des algorithmes plus rapides.
- Terminaison : la boucle
whilede la fonctiondestins'arrête avec une probabilité égale à $1$, mais on ne peut pas borner à l'avance le nombre de tours : c'est un exemple d'algorithme dont la durée est aléatoire. - Reproductibilité : fixer la graine du générateur avec
random.seedpermet de refaire exactement la même simulation.
Ce texte n'est pas un Grand Oral. Il rassemble des connaissances dans lesquelles chacun peut choisir une direction, la creuser et formuler sa propre question. Quelques directions possibles :
- Mathématiques : la loi binomiale à chaque génération, l'espérance et la variance de la fréquence, la perte de diversité comme suite géométrique, la probabilité de fixation, le cas calculable à la main.
- SVT : Hardy-Weinberg et ses hypothèses, dérive et sélection, effet fondateur, groupes sanguins, goulots d'étranglement et conservation des espèces, théorie neutre et horloge moléculaire.
- NSI : simuler une population, coût et terminaison d'un algorithme aléatoire.
Le jury peut interroger sur les chapitres de spécialité mobilisés. Avec ce thème, il est utile de connaître parfaitement : les probabilités conditionnelles, les arbres et l'indépendance ; le schéma de Bernoulli et la loi binomiale, son espérance et sa variance ; l'espérance et la variance d'une variable aléatoire, l'inégalité de Bienaymé-Tchebychev ; les suites géométriques, la somme de leurs termes et leur limite ; la fonction logarithme népérien.
Pour réviser ces chapitres, l'application Maths FlashBac reprend tout le cours de spécialité en cartes.
- Dérive génétique, modèle de Wright-Fisher et effet fondateur (Wikipédia).
- O. Sacks, L'Île en noir et blanc, Seuil, 1997 (le récit d'un séjour à Pingelap).
- M. Kimura, Théorie neutraliste de l'évolution, Flammarion, 1990.
- Sur ce site : l'animation Dérive génétique, les textes La planche de Galton (loi binomiale, loi des grands nombres) et Les mutations et leurs probabilités (Haldane, Kimura, horloge moléculaire).