← Tous les textes du Grand Oral
MathsMaths expertesNSISES
Pour aller de la gare de Lyon à la gare de l'Est, faut-il changer à Châtelet ou à Bastille ? Une application de transport répond en une fraction de seconde, parmi des milliards de trajets possibles. Elle ne « voit » pas le plan : elle travaille sur un objet mathématique très simple, un graphe, fait de points et de liaisons.
Ce texte relève surtout du programme de maths expertes (graphes, matrices, marches aléatoires), avec des outils de spécialité (récurrence, dénombrement, suites). Il part d'un petit morceau réel du métro parisien, sur lequel tout est calculé à la main. Il rassemble des connaissances ; à chacun d'y choisir une direction et d'y construire sa question.
- Le plan du métro est un graphe
- La matrice d'adjacence et le nombre de chemins
- Le plus court trajet : l'algorithme de Dijkstra
- Toutes les liaisons ou toutes les stations : Euler et Hamilton
- Du métro au GPS, du voyageur de commerce à Google
- Les limites du modèle
- Des directions pour construire sa question
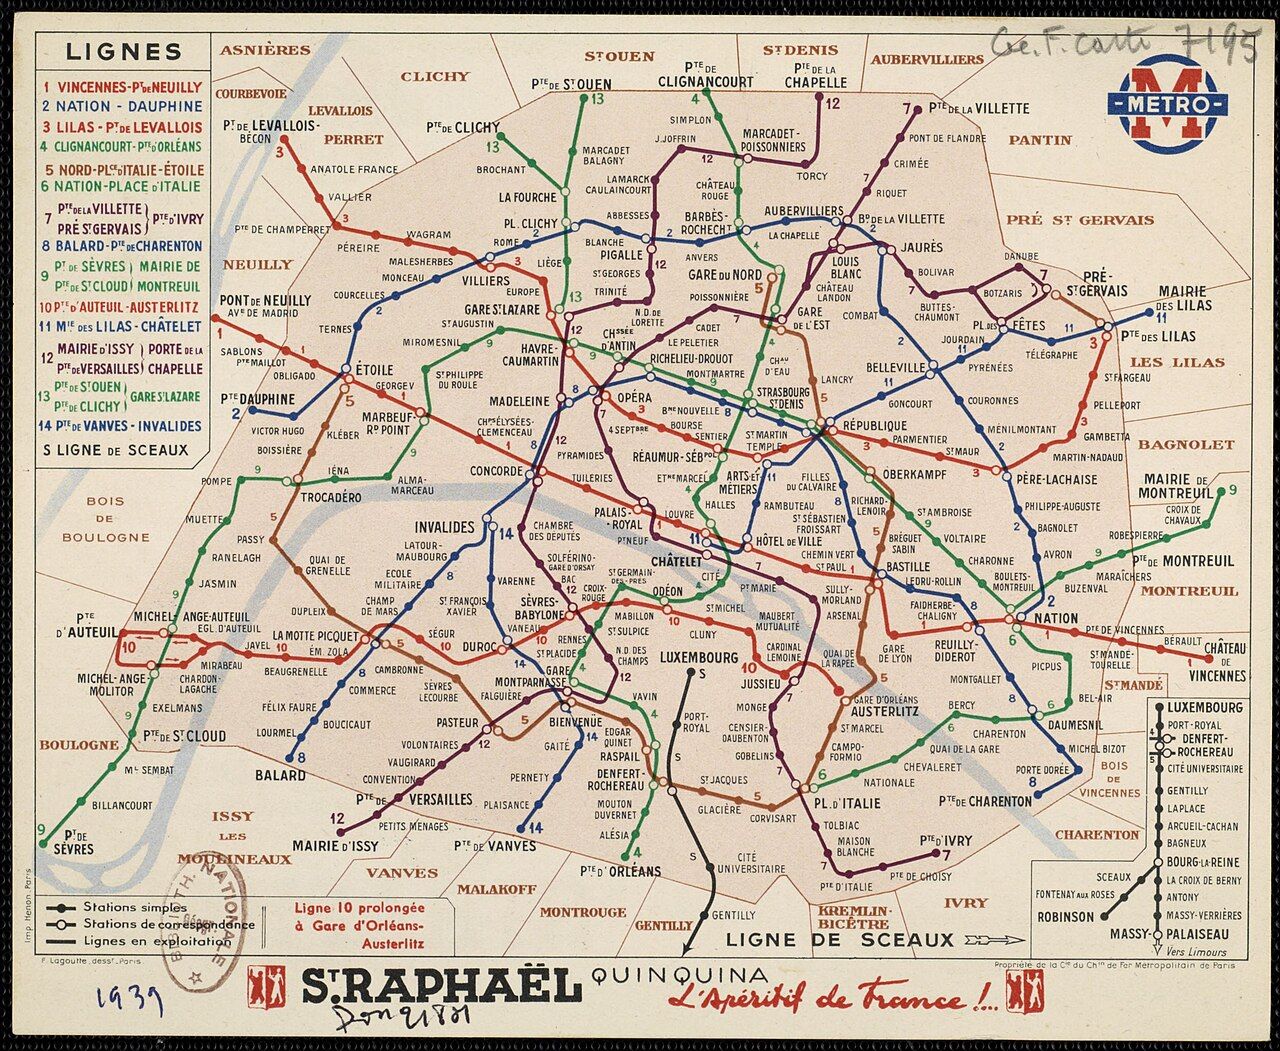
Un plan de métro déforme volontairement la ville. Les distances y sont fausses, les lignes y deviennent droites, les quartiers du centre y sont agrandis. Ce qui est conservé, c'est l'essentiel pour le voyageur : quelle station est reliée à quelle autre. L'idée vient de Londres : en 1933, le dessinateur Harry Beck propose un plan du métro londonien fait seulement de traits horizontaux, verticaux et à 45°, sans aucun souci des distances. Il est adopté, puis imité dans le monde entier.
Ce revers a un coût : une étude sur le métro de Londres (Zhan Guo, 2011) a montré que des voyageurs choisissent parfois un trajet plus long parce qu'il paraît plus court sur le plan. D'où l'intérêt de laisser le calcul à une machine.
Un graphe est formé de sommets et d'arêtes ; chaque arête relie deux sommets, qui sont alors dits adjacents. Le degré d'un sommet est le nombre d'arêtes qui en partent. Un graphe est pondéré lorsque chaque arête porte un nombre positif, son poids (une distance, une durée, un prix).
Prenons six grandes stations de correspondance du centre et de l'est de Paris, et relions deux d'entre elles lorsqu'une ligne va de l'une à l'autre sans passer par une autre de ces six stations. Les poids sont des durées de trajet en minutes, arrondies et choisies pour l'exemple (de l'ordre d'une minute et demie par intervalle entre deux stations).
| Liaison | Ligne | Arrêts intermédiaires | Durée |
|---|---|---|---|
| Châtelet – Gare de Lyon | 14 | aucun | 3 min |
| Châtelet – Bastille | 1 | Hôtel de Ville, Saint-Paul | 5 min |
| Bastille – Gare de Lyon | 1 | aucun | 2 min |
| Bastille – République | 5 ou 8 | 3 | 6 min |
| Châtelet – République | 11 | 3 | 6 min |
| Châtelet – Strasbourg-Saint-Denis | 4 | 3 | 6 min |
| République – Strasbourg-Saint-Denis | 8 ou 9 | aucun | 2 min |
| République – Gare de l'Est | 5 | Jacques Bonsergent | 3 min |
| Strasbourg-Saint-Denis – Gare de l'Est | 4 | Château d'Eau | 3 min |
On note les sommets par une lettre : $C$ (Châtelet), $L$ (gare de Lyon), $B$ (Bastille), $R$ (République), $E$ (gare de l'Est), $S$ (Strasbourg-Saint-Denis). Le graphe a $6$ sommets et $9$ arêtes. La figure de la partie suivante le dessine.
| Sommet | $C$ | $L$ | $B$ | $R$ | $E$ | $S$ |
|---|---|---|---|---|---|---|
| Degré | 4 | 2 | 3 | 4 | 2 | 3 |
La somme des degrés vaut $4+2+3+4+2+3 = 18$, soit le double du nombre d'arêtes. Ce n'est pas un hasard.
Chaque arête a deux extrémités. Quand on additionne les degrés de tous les sommets, chaque arête est donc comptée exactement deux fois : une fois à chacune de ses extrémités. La somme des degrés vaut donc $2a$, où $a$ est le nombre d'arêtes.
Conséquence : la somme des degrés est paire, donc le nombre de sommets de degré impair est pair (une somme qui contient un nombre impair de termes impairs est impaire). Ici, $B$ et $S$ sont les deux seuls sommets de degré impair.
Pour qu'une machine travaille sur un graphe, on le range dans un tableau de nombres. On numérote les sommets dans l'ordre $C, L, B, R, E, S$, et on écrit $1$ à la ligne $i$ et à la colonne $j$ si les sommets $i$ et $j$ sont adjacents, $0$ sinon.
La matrice d'adjacence d'un graphe à $n$ sommets est la matrice carrée $A$ de taille $n$ dont le coefficient $a_{ij}$ vaut $1$ si les sommets $i$ et $j$ sont reliés par une arête, et $0$ sinon. Pour un graphe non orienté, elle est symétrique : $a_{ij} = a_{ji}$.
| $C$ | $L$ | $B$ | $R$ | $E$ | $S$ | |
|---|---|---|---|---|---|---|
| $C$ | 0 | 1 | 1 | 1 | 0 | 1 |
| $L$ | 1 | 0 | 1 | 0 | 0 | 0 |
| $B$ | 1 | 1 | 0 | 1 | 0 | 0 |
| $R$ | 1 | 0 | 1 | 0 | 1 | 1 |
| $E$ | 0 | 0 | 0 | 1 | 0 | 1 |
| $S$ | 1 | 0 | 0 | 1 | 1 | 0 |
La somme des coefficients d'une ligne est le degré du sommet.
Un chemin (on dit aussi une chaîne) de longueur $n$ est une suite de $n$ arêtes qui se suivent ; on a le droit de repasser par un sommet. Cherchons les chemins de longueur $2$ de $L$ à $E$ : il faudrait un sommet adjacent à la fois à $L$ et à $E$. Les voisins de $L$ sont $C$ et $B$, ceux de $E$ sont $R$ et $S$ : aucun sommet commun, donc aucun chemin de longueur $2$.
Pour la longueur $3$, on part de $L$, on va en $C$ ou en $B$, puis en un voisin de $E$ (donc $R$ ou $S$), puis en $E$. On trouve trois chemins :
- $L \to C \to R \to E$ ;
- $L \to C \to S \to E$ ;
- $L \to B \to R \to E$ (il n'y a pas d'arête de $B$ à $S$).
Calculons maintenant les puissances de la matrice. Le produit de $A$ par elle-même donne
$$A^2 = \begin{pmatrix} 4&1&2&2&2&1\\ 1&2&1&2&0&1\\ 2&1&3&1&1&2\\ 2&2&1&4&1&2\\ 2&0&1&1&2&1\\ 1&1&2&2&1&3 \end{pmatrix}$$et
$$A^3 = \begin{pmatrix} 6&6&7&9&3&8\\ 6&2&5&3&3&3\\ 7&5&4&8&3&4\\ 9&3&8&6&6&7\\ 3&3&3&6&2&5\\ 8&3&4&7&5&4 \end{pmatrix}.$$Le coefficient de $A^2$ à la ligne $L$ (la 2e) et à la colonne $E$ (la 5e) vaut $0$, celui de $A^3$ vaut $3$ : ce sont exactement les nombres de chemins trouvés à la main. Sur la diagonale de $A^2$, on lit les degrés : un chemin de longueur $2$ qui revient à son départ est un aller-retour vers un voisin.
Pour tout entier $n \geqslant 1$, le coefficient de la ligne $i$ et de la colonne $j$ de $A^n$ est le nombre de chemins de longueur $n$ qui vont du sommet $i$ au sommet $j$.
On note $c_n(i,j)$ le nombre de chemins de longueur $n$ de $i$ à $j$, et $\big(A^n\big)_{ij}$ le coefficient de $A^n$ en ligne $i$, colonne $j$. On démontre par récurrence la propriété $P(n)$ : « pour tous les sommets $i$ et $j$, $\big(A^n\big)_{ij} = c_n(i,j)$ ».
Initialisation. Un chemin de longueur $1$ de $i$ à $j$ est une arête de $i$ à $j$ : il y en a une si $i$ et $j$ sont adjacents, aucune sinon. C'est la définition de $a_{ij}$, donc $P(1)$ est vraie.
Hérédité. On suppose $P(n)$ vraie pour un entier $n \geqslant 1$. Un chemin de longueur $n+1$ de $i$ à $j$ se décompose en un chemin de longueur $n$ de $i$ à un sommet $k$, suivi d'une arête de $k$ à $j$. On classe ces chemins selon l'avant-dernier sommet $k$ :
- si $k$ est adjacent à $j$, il y a $c_n(i,k)$ chemins qui passent par $k$ juste avant $j$, c'est-à-dire $c_n(i,k) \times a_{kj}$, puisque $a_{kj} = 1$ ;
- si $k$ n'est pas adjacent à $j$, il n'y en a aucun, ce qui vaut encore $c_n(i,k) \times a_{kj}$, puisque $a_{kj} = 0$.
En additionnant sur tous les sommets $k$, puis en utilisant l'hypothèse de récurrence :
$$\begin{aligned} c_{n+1}(i,j) &= \sum_{k=1}^{6} c_n(i,k)\, a_{kj} \\ &= \sum_{k=1}^{6} \big(A^n\big)_{ik}\, a_{kj}. \end{aligned}$$La dernière somme est exactement la règle du produit des matrices $A^n$ et $A$ : c'est le coefficient $(i,j)$ de $A^n \times A = A^{n+1}$. Donc $P(n+1)$ est vraie.
Conclusion. Par récurrence, $P(n)$ est vraie pour tout entier $n \geqslant 1$.
Ce résultat donne aussi la distance en nombre d'arêtes entre deux sommets : c'est le plus petit $n$ tel que le coefficient $(i,j)$ de $A^n$ soit non nul. Ici, $L$ et $E$ sont à distance $3$. Le programme suivant calcule les puissances de $A$ sans aucune bibliothèque.
Le nombre de chemins grandit très vite avec la longueur : c'est pourquoi on ne cherche jamais le meilleur trajet en les essayant tous.
En 1956, le jeune Néerlandais Edsger Dijkstra doit montrer ce que sait faire un nouvel ordinateur, l'ARMAC. Il choisit un problème que tout le monde comprend : le plus court trajet entre deux villes des Pays-Bas. Il racontera avoir trouvé la méthode en une vingtaine de minutes, à la terrasse d'un café d'Amsterdam, sans papier ni crayon. Il la publie en 1959, en trois pages. Elle reste, avec ses variantes, au cœur des calculs d'itinéraires.
On cherche les plus courts trajets depuis un sommet de départ vers tous les autres. Chaque sommet reçoit une étiquette : la durée du meilleur trajet trouvé jusqu'ici ($0$ pour le départ, $\infty$ pour les autres au début). Puis on répète :
- parmi les sommets non encore choisis, on choisit celui qui a la plus petite étiquette : son étiquette est définitive ;
- pour chacun de ses voisins non choisis, on calcule l'étiquette du sommet choisi plus le poids de l'arête ; si c'est plus petit que l'étiquette du voisin, on la remplace et on retient d'où l'on vient.
On s'arrête quand tous les sommets sont choisis. On retrouve le trajet en remontant les « d'où l'on vient ».
Dans le tableau, chaque ligne est une étape. Le nombre indique l'étiquette, la lettre en indice le sommet d'où l'on vient. La case orange est le sommet choisi à cette étape ; les cases grises sont des sommets déjà choisis.
| $L$ | $B$ | $C$ | $R$ | $S$ | $E$ | Choix |
|---|---|---|---|---|---|---|
| $0$ | $\infty$ | $\infty$ | $\infty$ | $\infty$ | $\infty$ | $L$ |
| $2_L$ | $3_L$ | $\infty$ | $\infty$ | $\infty$ | $B$ | |
| $3_L$ | $8_B$ | $\infty$ | $\infty$ | $C$ | ||
| $8_B$ | $9_C$ | $\infty$ | $R$ | |||
| $9_C$ | $11_R$ | $S$ | ||||
| $11_R$ | $E$ |
Détaillons les étapes.
- Étape 1. On choisit $L$ (étiquette $0$). Ses voisins sont $B$ et $C$ : ils reçoivent $0+2 = 2$ et $0+3 = 3$.
- Étape 2. La plus petite étiquette est celle de $B$ ($2$). Depuis $B$ : vers $C$, $2+5 = 7$ n'améliore pas $3$, on garde $3$ ; vers $R$, $2+6 = 8$ remplace $\infty$.
- Étape 3. On choisit $C$ ($3$). Vers $R$, $3+6 = 9$ n'améliore pas $8$ ; vers $S$, $3+6 = 9$ remplace $\infty$.
- Étape 4. On choisit $R$ ($8$). Vers $S$, $8+2 = 10$ n'améliore pas $9$ ; vers $E$, $8+3 = 11$ remplace $\infty$.
- Étape 5. On choisit $S$ ($9$). Vers $E$, $9+3 = 12$ n'améliore pas $11$.
- Étape 6. On choisit $E$ : son étiquette définitive est $11$.
On remonte : $E$ vient de $R$, $R$ vient de $B$, $B$ vient de $L$. Le meilleur trajet est $L \to B \to R \to E$ : ligne 1 jusqu'à Bastille, puis ligne 5 jusqu'à la gare de l'Est, en $11$ minutes. Le trajet par Châtelet et la ligne 4 en demande $12$. L'algorithme a donné en prime les meilleurs temps vers toutes les autres stations.
Le point délicat est l'étape 1 : pourquoi l'étiquette du sommet choisi serait-elle définitive ? Ne pourrait-on pas trouver plus tard un détour plus rapide ?
On raisonne par l'absurde. Supposons qu'au moment où l'on choisit un sommet $X$ d'étiquette $d$, il existe un trajet du départ à $X$ de durée $t$ strictement inférieure à $d$. On admet que tous les sommets choisis avant $X$ avaient une étiquette exacte (c'est le raisonnement fait aux étapes précédentes).
- Ce trajet part du départ, qui est déjà choisi, et arrive en $X$, qui ne l'est pas encore. Il quitte donc à un moment l'ensemble des sommets choisis : notons $Y$ le premier sommet non choisi du trajet, et $Z$ le sommet choisi qui le précède.
- Quand $Z$ a été choisi, on a mis à jour l'étiquette de son voisin $Y$ : elle est au plus égale à la durée du trajet jusqu'à $Z$, plus l'arête $Z \to Y$, donc au plus égale à la durée $t_Y$ de la portion de trajet jusqu'à $Y$.
- Les poids sont positifs, donc la suite du trajet de $Y$ à $X$ ne fait pas diminuer la durée : $t_Y \leqslant t$.
- Donc l'étiquette de $Y$ est au plus $t$, elle-même strictement inférieure à $d$. Mais l'algorithme a choisi $X$ parce que son étiquette $d$ était la plus petite parmi les sommets non choisis, dont $Y$ : contradiction.
Il n'existe donc pas de trajet plus court que $d$ : l'étiquette de $X$ est définitive. Comme cela vaut à chaque étape, l'algorithme est correct.
La démonstration utilise une hypothèse essentielle : les poids sont positifs. Avec des poids négatifs (un trajet qui ferait « gagner du temps »), un détour pourrait tout changer, et il faut d'autres algorithmes.
Le même calcul en Python. On ne trie rien : à chaque étape on cherche le minimum en parcourant les sommets, comme sur le tableau.
En changeant la ligne dijkstra(1), on obtient les trajets depuis une autre station. Pour un graphe de $n$ sommets, cette
version fait de l'ordre de $n^2$ opérations : pour les quelque $300$ stations du métro, c'est instantané.
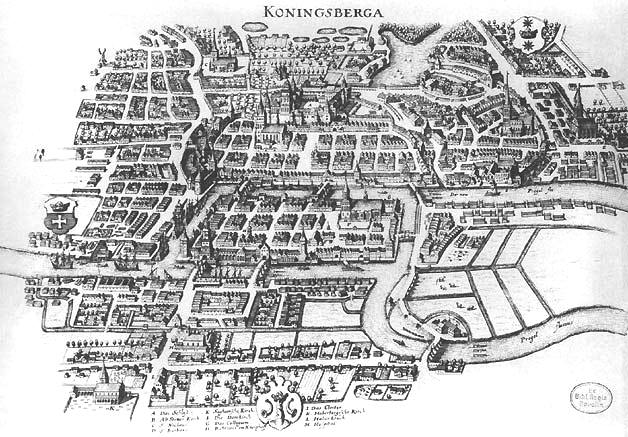
Les habitants de Königsberg (aujourd'hui Kaliningrad, en Russie) se demandaient s'il était possible de se promener en traversant chacun des sept ponts une fois et une seule. En 1735, Leonhard Euler présente à l'Académie de Saint-Pétersbourg un mémoire qui règle la question, et bien d'autres avec elle : on y voit l'acte de naissance de la théorie des graphes.
Chaque quartier devient un sommet, chaque pont une arête (deux quartiers peuvent être reliés par deux ponts). L'île centrale touche $5$ ponts, les trois autres quartiers $3$ chacun : les quatre sommets sont de degré impair.
Dans un graphe, une chaîne eulérienne emprunte chaque arête une fois et une seule ; un cycle eulérien est une chaîne eulérienne qui revient à son point de départ.
Un graphe connexe (d'un seul tenant) possède un cycle eulérien si et seulement si tous ses sommets sont de degré pair. Il possède une chaîne eulérienne non fermée si et seulement s'il a exactement deux sommets de degré impair ; elle va alors de l'un à l'autre.
Suivons une chaîne eulérienne et regardons un sommet $X$ qui n'est ni le départ ni l'arrivée.
- Chaque fois que la promenade passe par $X$, elle y arrive par une arête et en repart par une autre : elle utilise deux arêtes issues de $X$.
- Toutes les arêtes sont empruntées une fois et une seule : les arêtes issues de $X$ sont donc groupées par paires, et le degré de $X$ est pair.
- Pour le départ et l'arrivée, il faut ajouter l'arête de départ et l'arête d'arrivée. S'ils sont confondus (cycle), cela fait une paire de plus et le degré reste pair ; sinon, ces deux sommets ont un degré impair.
À Königsberg, quatre sommets sont de degré impair : la promenade est impossible.
La réciproque (si les degrés conviennent, la promenade existe) est vraie aussi ; sa démonstration, qui construit la promenade en recollant des boucles, est admise ici.
Dans notre morceau de métro, seuls $B$ et $S$ sont de degré impair. Il existe donc une chaîne qui emprunte les $9$ liaisons une fois chacune, de Bastille à Strasbourg-Saint-Denis : par exemple
$$\begin{aligned} &B \to L \to C \to B \to R \\ &\to C \to S \to R \to E \to S. \end{aligned}$$Sur le réseau entier, en revanche, c'est impossible : la plupart des terminus sont de degré $1$, donc impair, et il y en a bien plus que deux.
La question voisine semble plus simple : passer par chaque sommet une fois et une seule, en revenant au départ (un cycle hamiltonien). Elle porte le nom de William Rowan Hamilton, qui vendit en 1857 un jeu, l'« icosian », où il fallait faire le tour des $20$ sommets d'un dodécaèdre.
Dans notre graphe, le cycle $C \to L \to B \to R \to E \to S \to C$ passe par les six stations, en $3+2+6+3+3+6 = 23$ minutes.
Le réseau entier, lui, n'a pas de cycle hamiltonien. Prenons un terminus de degré $1$, par exemple Créteil-Pointe du Lac, au bout de la ligne 8 : on ne peut y entrer et en ressortir que par Créteil-Préfecture, qu'il faut donc traverser deux fois.
Mais contrairement au cas d'Euler, il n'existe aucun critère simple sur les degrés qui dise si un graphe est hamiltonien. Le problème fait partie des problèmes dits « NP-complets » : on ne connaît aucune méthode qui le résolve rapidement pour tous les grands graphes, et l'on ne sait pas s'il en existe une (c'est l'une des grandes questions ouvertes de l'informatique).
Il existe enfin un défi bien réel : visiter toutes les stations d'un métro le plus vite possible, en ayant le droit de repasser par certaines. À Londres, ce « Tube Challenge » est suivi par le Guinness des records ; le record homologué en 2015 était de l'ordre de 15 heures 45 minutes pour plus de 270 stations. Des passionnés ont relevé le même défi à Paris. Préparer un tel parcours, c'est résoudre à la main un problème de graphe très difficile.
Un GPS de voiture travaille sur un graphe dont les sommets sont des carrefours et les arêtes des tronçons de route : des dizaines de millions de sommets pour l'Europe. Même un algorithme en $n^2$ serait alors trop lent. On utilise des variantes de Dijkstra :
- l'algorithme A* (1968) explore d'abord les sommets qui se rapprochent de l'arrivée à vol d'oiseau, au lieu de s'étendre en cercle dans toutes les directions ;
- des calculs faits à l'avance (raccourcis entre grandes villes, autoroutes) évitent de refaire le travail à chaque requête ;
- les poids changent avec le trafic, mesuré en temps réel, et le calcul est relancé en cours de route.
Pour le métro et les bus, les applications tiennent compte des horaires : la durée d'une arête dépend de l'heure à laquelle on arrive au quai. Ce ne sont plus tout à fait des graphes à poids fixes, mais l'idée de Dijkstra (fixer d'abord ce qui est sûr, du plus proche au plus lointain) reste au centre.
Un livreur doit passer par $n$ adresses et revenir au dépôt, en un temps minimal : c'est le problème du voyageur de commerce, un cycle hamiltonien de poids minimal. Pourquoi ne pas essayer tous les circuits ?
Comptons-les. On fixe le point de départ. Il reste $n-1$ choix pour la première étape, $n-2$ pour la deuxième, et ainsi de suite : $(n-1)!$ ordres de passage. Chaque circuit est compté deux fois (une fois dans chaque sens), d'où
$$\frac{(n-1)!}{2} \ \text{circuits.}$$| Nombre d'adresses $n$ | Nombre de circuits |
|---|---|
| $6$ | $60$ |
| $10$ | $181\,440$ |
| $20$ | environ $6 \times 10^{16}$ |
| $30$ | environ $4{,}4 \times 10^{30}$ |
Pour nos six stations, les $60$ circuits se vérifient en un instant. Pour $30$ adresses, un ordinateur qui examinerait un milliard de circuits par seconde mettrait environ $10^{14}$ années, soit des milliers de fois l'âge de l'Univers. Pour les $300$ stations du métro, le nombre de circuits a plus de $600$ chiffres. Les entreprises de livraison utilisent donc des méthodes qui donnent de bonnes solutions, sans garantie qu'elles soient les meilleures (aller à l'adresse la plus proche, puis améliorer le circuit en échangeant des étapes). C'est un enjeu économique : quelques pour cent de kilomètres en moins, sur des milliers de camions, représentent beaucoup de carburant et de temps de travail.
Imaginons un voyageur qui, à chaque station, prend au hasard l'une des liaisons possibles, toutes avec la même probabilité. Depuis Châtelet, de degré $4$, il va donc vers chacun des quatre voisins avec la probabilité $\frac{1}{4}$. C'est une chaîne de Markov : la suite du trajet ne dépend que de la station où il se trouve.
On range ces probabilités dans la matrice de transition $P$, dont le coefficient $p_{ij}$ est la probabilité d'aller de $i$ à $j$ : $p_{ij} = \dfrac{a_{ij}}{d_i}$, où $d_i$ est le degré de $i$. Si $\pi_n$ est la matrice ligne des probabilités d'être dans chaque station après $n$ trajets, la formule des probabilités totales donne $\pi_{n+1} = \pi_n P$.
Où le voyageur passe-t-il le plus de temps, à long terme ? On cherche une distribution invariante, une matrice ligne $\pi$ de somme $1$ telle que $\pi P = \pi$.
Vérification sur un exemple. On veut la probabilité d'être en $E$ après un trajet, si l'on part selon $\pi$. On n'arrive en $E$ que depuis $R$ (probabilité $\frac14$) ou depuis $S$ (probabilité $\frac13$) :
$$\frac{4}{18} \times \frac{1}{4} + \frac{3}{18} \times \frac{1}{3} = \frac{1}{18} + \frac{1}{18} = \frac{2}{18},$$ce qui est bien $\pi_E = \frac{d_E}{18}$.
Cas général. Le coefficient $j$ de $\pi P$ vaut
$$\begin{aligned} \sum_{i} \pi_i\, p_{ij} &= \sum_{i} \frac{d_i}{18} \times \frac{a_{ij}}{d_i} \\ &= \frac{1}{18} \sum_{i} a_{ij} = \frac{d_j}{18}, \end{aligned}$$car la somme des coefficients de la colonne $j$ de $A$ est le degré de $j$. Et la somme des $\pi_i$ vaut $\frac{18}{18} = 1$. Donc $\pi P = \pi$.
À long terme, le voyageur passe donc $\frac{4}{18}$ de son temps, environ $22\,\%$, à Châtelet comme à République, et deux fois moins à la gare de l'Est. Une station très reliée est une station souvent visitée. La simulation suivante le vérifie ; d'après la loi des grands nombres, plus le nombre de trajets est grand, plus il est probable que les fréquences soient proches de ces valeurs.
C'est l'idée de départ de PageRank, publiée en 1998 par Sergey Brin et Larry Page, les fondateurs de Google : les sommets sont des pages web, les arêtes des liens (orientés cette fois), et un internaute imaginaire clique au hasard. Une page importante est une page où il passe souvent. Pour qu'il ne reste pas bloqué dans un coin du web, on ajoute une règle : à chaque clic, avec la probabilité $0{,}15$, il saute sur une page tirée au hasard. La matrice de transition devient
$$G = 0{,}85\,P + 0{,}15\,\frac{1}{N}\,J,$$où $N$ est le nombre de pages et $J$ la matrice remplie de $1$. Le classement des pages est la distribution invariante de $G$, calculée en multipliant un grand nombre de fois une matrice ligne par $G$ : la suite $\pi_{n+1} = \pi_n G$ converge vers elle (un résultat admis, qui repose sur le fait que tous les coefficients de $G$ sont strictement positifs).
Notre graphe ne connaît pas les correspondances. Or changer de ligne prend du temps : marcher dans les couloirs, attendre la rame suivante. À Châtelet, certains changements sont réputés pour la longueur de leurs couloirs.
Pour en tenir compte, on modifie le graphe : chaque station est dédoublée en autant de sommets que de lignes qui la desservent (un sommet « Châtelet, ligne 14 », un sommet « Châtelet, ligne 4 »…), reliés par des arêtes de correspondance qui portent le temps de changement. Dans notre exemple, les deux meilleurs trajets comportent chacun un changement (à Bastille de la ligne 1 à la ligne 5, ou à Châtelet de la ligne 14 à la ligne 4) : si les deux correspondances durent autant, le classement ne change pas ; si celle de Châtelet est plus longue, l'écart se creuse. Avec plus de stations, il arrive qu'un trajet plus long en rame mais sans changement l'emporte.
Restent les incertitudes du réel : attente sur le quai, rames bondées, incidents. Deux applications qui utilisent des données ou des réglages différents peuvent donc proposer deux itinéraires différents pour le même trajet, à la même heure.
Ce texte n'est pas un Grand Oral. Il rassemble des connaissances dans lesquelles chacun peut choisir une direction, la creuser et formuler sa propre question. Quelques directions possibles :
- Mathématiques : les puissances de la matrice d'adjacence et la récurrence ; la démonstration de l'algorithme de Dijkstra ; le théorème d'Euler ; le dénombrement des circuits ; la distribution invariante d'une marche aléatoire.
- NSI : la représentation d'un graphe (matrice ou listes de voisins) ; l'algorithme de Dijkstra et son coût ; les problèmes difficiles et les méthodes approchées.
- SES : les réseaux de transport et l'aménagement du territoire ; le coût des tournées de livraison ; le classement des pages web et le pouvoir des moteurs de recherche.
Le jury peut interroger sur les chapitres mobilisés. Avec ce thème, il est utile de connaître parfaitement : en maths expertes, le vocabulaire des graphes, la matrice d'adjacence, le produit et les puissances de matrices, les chaînes de Markov, la matrice de transition et la distribution invariante ; en spécialité, le raisonnement par récurrence, le dénombrement et les factorielles, les probabilités conditionnelles et la formule des probabilités totales, la loi des grands nombres.
Pour réviser ces chapitres, l'application Maths FlashBac reprend tout le cours de spécialité en cartes.
- Algorithme de Dijkstra, problème des sept ponts de Königsberg, problème du voyageur de commerce et PageRank (Wikipédia).
- Sur ce site : La recherche opérationnelle (optimiser sous contraintes), Construire des cartes (ce qu'une carte conserve et ce qu'elle déforme) et Le triangle de Pascal (dénombrer des chemins).