← Tous les textes du Grand Oral
MathsSVTHGGSP
Chacun a deux parents, quatre grands-parents, huit arrière-grands-parents… Un arbre généalogique semble très simple. Pourtant, il pose des questions surprenantes : comment pouvons-nous avoir plus d'ancêtres au Moyen Âge qu'il n'y avait d'habitants sur Terre ? Pourquoi la plupart des noms de famille finissent-ils par disparaître ? Pourquoi les mariages entre cousins augmentent-ils le risque de certaines maladies ? Et que veut dire « nous descendons tous d'une même femme » ?
Pour répondre, on utilise des mathématiques de terminale : suites géométriques et logarithme, suites récurrentes et point fixe, probabilités conditionnelles, limites. Ce texte rassemble des connaissances ; à chacun d'y choisir une direction et d'y construire sa question.
Numérotons les générations en remontant le temps : la génération $1$ est celle des parents, la génération $2$ celle des grands-parents, et ainsi de suite. Chaque personne a deux parents, donc le nombre de places dans l'arbre double à chaque génération :
| génération $n$ | $1$ | $2$ | $3$ | $4$ | $10$ | $20$ |
|---|---|---|---|---|---|---|
| places | $2$ | $4$ | $8$ | $16$ | $1\,024$ | $1\,048\,576$ |
À la génération $n$, il y a $a_n = 2^n$ places : la suite $(a_n)$ est géométrique de raison $2$. Combien de places au total, des parents jusqu'à la génération $n$ ?
Exemple à la main. Jusqu'aux arrière-grands-parents ($n = 3$) : $S_3 = 2 + 4 + 8 = 14$, et $2^4 - 2 = 16 - 2 = 14$.
Cas général. On factorise par $2$ :
$$S_n = 2 + 2^2 + \cdots + 2^n$$donc
$$S_n = 2\left(1 + 2 + \cdots + 2^{n-1}\right).$$La parenthèse est la somme des $n$ premiers termes de la suite géométrique de premier terme $1$ et de raison $2$. D'après le cours, pour $q \neq 1$ :
$$1 + q + \cdots + q^{n-1} = \dfrac{1 - q^n}{1 - q}.$$Avec $q = 2$, la parenthèse vaut $\dfrac{1 - 2^n}{1 - 2} = 2^n - 1$, donc $S_n = 2\left(2^n - 1\right) = 2^{n+1} - 2$.
Comptons environ $25$ ans par génération (c'est un ordre de grandeur : l'âge des parents à la naissance varie). L'an $1000$ est donc à environ $40$ générations de nous, et
$$2^{40} = \left(2^{10}\right)^4 \approx \left(10^3\right)^4 = 10^{12}.$$Mille milliards de places dans notre arbre, alors que les historiens estiment la population mondiale de l'an $1000$ entre $250$ et $320$ millions d'habitants. À partir de quelle génération le nombre de places dépasse-t-il $300$ millions ? On résout $2^n > 3 \times 10^8$ avec le logarithme népérien, qui est strictement croissant :
$$2^n > 3 \times 10^8 \iff n \ln 2 > \ln\left(3 \times 10^8\right)$$ $$\iff n > \dfrac{\ln\left(3 \times 10^8\right)}{\ln 2} \approx 28{,}2.$$Dès la génération $29$, il y a plus de places dans l'arbre que d'humains vivant vers l'an $1000$, et donc a fortiori que d'humains vivant $29$ générations avant nous, vers le XIIIe siècle. C'est le paradoxe des ancêtres.
Le paradoxe disparaît quand on comprend qu'une même personne peut occuper plusieurs places dans l'arbre. Il suffit que deux de nos ancêtres soient cousins pour que certains de leurs ancêtres apparaissent deux fois. Les généalogistes appellent cela l'implexe.
Prenons un enfant dont les parents sont cousins germains : un grand-père paternel $B$ et une grand-mère maternelle $C$ sont frère et sœur, enfants du même couple $A_1$, $A_2$. Sur les $8$ places d'arrière-grands-parents, $A_1$ et $A_2$ en occupent chacun deux : l'enfant n'a que $6$ arrière-grands-parents différents.
Pour cet enfant, le taux d'implexe à la génération $3$ vaut $1 - \dfrac{6}{8} = 25\,\%$. Plus on remonte, plus le taux augmente : autrefois, on se mariait le plus souvent dans son village ou sa paroisse, si bien que des cousinages éloignés étaient très fréquents. Au-delà de quelques siècles, le nombre de personnes différentes dans un arbre cesse de doubler, puis diminue en remontant. La suite $2^n$ compte des places, pas des personnes.
On entend souvent dire que « tous les Européens descendent de Charlemagne ». Ce n'est pas une légende de généalogiste : c'est une conséquence probable d'un résultat de probabilités publié en 1999 par le statisticien Joseph Chang.
Chang étudie un modèle très simplifié : une population de taille constante $N$, où chaque enfant a deux parents choisis au hasard dans la génération précédente. Il démontre que, lorsque $N$ est grand :
- l'ancêtre commun le plus récent de toute la population vivait il y a environ $\log_2 N = \dfrac{\ln N}{\ln 2}$ générations ;
- vers $1{,}77 \log_2 N$ générations en arrière, chaque individu de l'époque est soit l'ancêtre de tous les vivants, soit l'ancêtre de personne ; et environ $80\,\%$ sont ancêtres de tous.
Le $\log_2 N$ se comprend avec le paradoxe des ancêtres : les places de l'arbre doublent à chaque génération, et elles dépassent la taille $N$ de la population quand $2^n \geqslant N$, c'est-à-dire $n \geqslant \dfrac{\ln N}{\ln 2}$. À partir de là, les arbres de tous les vivants se recouvrent forcément.
Pour une Europe d'environ $30$ millions d'habitants à l'époque de Charlemagne (un ordre de grandeur), $\log_2\left(3 \times 10^7\right) \approx 24{,}8$ et $1{,}77 \times 24{,}8 \approx 44$ générations, soit environ $1\,100$ ans. Dans ce modèle, tout Européen du IXe siècle qui a des descendants aujourd'hui est l'ancêtre de tous les Européens actuels. Or Charlemagne a des descendants bien documentés. Il faut rester prudent : les gens ne se marient pas au hasard dans toute l'Europe. Mais des études génétiques (Ralph et Coop, 2013) confirment que les Européens partagent un très grand nombre d'ancêtres communs sur le dernier millénaire.
Le programme suivant simule le modèle de Chang avec $N = 300$ individus. Chaque individu porte la liste de ses ancêtres parmi les
$300$ fondateurs, codée par les chiffres d'un nombre en binaire (le chiffre numéro $i$ vaut $1$ si le fondateur $i$ est un ancêtre).
Un enfant hérite des ancêtres de ses deux parents : c'est le « ou » bit à bit |. On s'arrête quand tout le
monde a exactement les mêmes ancêtres.
On obtient en général un ancêtre commun vers la génération $8$ ou $9$, proche de $\log_2 300 \approx 8{,}2$, et une part de fondateurs « ancêtres de tous » proche de $0{,}8$. Les autres n'ont plus aucun descendant. Ce nombre $0{,}8$ n'est pas un hasard : on le retrouve dans la partie suivante, avec l'extinction des familles.
En 1873, Francis Galton (le cousin de Darwin, voir le texte sur la planche de Galton) s'inquiète de la disparition des familles de l'aristocratie anglaise. Il pose une question dans une revue : si chaque homme a $0$, $1$, $2$… fils avec des probabilités connues, quelle est la probabilité que son nom finisse par s'éteindre ? Le pasteur et mathématicien Henry Watson lui répond avec une suite récurrente, et ils publient ensemble en 1875. Watson se trompe pourtant dans sa conclusion : il croit que tous les noms finissent par disparaître. La bonne réponse avait été énoncée dès 1845 par le Français Irénée-Jules Bienaymé, et elle ne fut vraiment démontrée qu'au XXe siècle. Le modèle porte aujourd'hui le nom de processus de Galton-Watson.
Dans une société où le nom passe du père aux enfants, seuls les fils transmettent le nom. On suppose que chaque homme, indépendamment des autres, a :
- $0$ fils avec la probabilité $p_0 = \dfrac{1}{4}$ ;
- $1$ fils avec la probabilité $p_1 = \dfrac{1}{4}$ ;
- $2$ fils avec la probabilité $p_2 = \dfrac{1}{2}$.
Le nombre moyen de fils est l'espérance $m = 0 \times \dfrac{1}{4} + 1 \times \dfrac{1}{4} + 2 \times \dfrac{1}{2} = 1{,}25$. En moyenne, la famille grandit. Le nom peut-il pourtant disparaître ?
Notons $u_n$ la probabilité que le nom d'un homme (le fondateur) ait disparu à la génération $n$, c'est-à-dire qu'il n'ait plus aucun descendant masculin en ligne masculine à la génération $n$. On a $u_0 = 0$ (le fondateur existe), et $u_1 = p_0 = \dfrac{1}{4}$.
Pour passer de $n$ à $n + 1$, on regarde les fils du fondateur. Chaque fils est lui-même le fondateur d'une branche, qui se comporte comme la famille entière, avec une génération de moins. La famille a disparu à la génération $n + 1$ si et seulement si la branche de chaque fils a disparu en $n$ générations. Avec la formule des probabilités totales et l'indépendance des branches :
- $0$ fils (probabilité $p_0$) : le nom a disparu, avec la probabilité $1$ ;
- $1$ fils (probabilité $p_1$) : sa branche a disparu avec la probabilité $u_n$ ;
- $2$ fils (probabilité $p_2$) : les deux branches ont disparu avec la probabilité $u_n \times u_n = u_n^2$.
c'est-à-dire $u_{n+1} = f(u_n)$ avec
$$f(x) = \dfrac{1}{4} + \dfrac{1}{4}x + \dfrac{1}{2}x^2.$$À la main. $u_1 = f(0) = \dfrac{1}{4}$, puis
$$u_2 = f\left(\dfrac{1}{4}\right) = \dfrac{1}{4} + \dfrac{1}{16} + \dfrac{1}{32}$$ $$u_2 = \dfrac{11}{32} \approx 0{,}344,$$puis $u_3 \approx 0{,}395$, $u_4 \approx 0{,}427$, $u_5 \approx 0{,}448$. La suite croît, de plus en plus lentement. Vers quoi ?
Étape 1 : les points fixes. Si la suite converge vers une limite $\ell$, comme $f$ est continue (c'est un polynôme), on peut passer à la limite dans $u_{n+1} = f(u_n)$ : $\ell = f(\ell)$. On résout $x = f(x)$ :
$$x = \dfrac{1}{4} + \dfrac{1}{4}x + \dfrac{1}{2}x^2$$ $$\iff 4x = 1 + x + 2x^2$$ $$\iff 2x^2 - 3x + 1 = 0.$$Le discriminant vaut $9 - 8 = 1$, d'où deux solutions : $x = \dfrac{3 - 1}{4} = \dfrac{1}{2}$ et $x = \dfrac{3 + 1}{4} = 1$. Les seules limites possibles sont $\dfrac{1}{2}$ et $1$.
Étape 2 : le sens de variation de $f$. Pour tout réel $x$, $f'(x) = \dfrac{1}{4} + x$, donc $f'(x) > 0$ pour $x \geqslant 0$ : $f$ est strictement croissante sur $\left[0\,;\,\dfrac{1}{2}\right]$.
Étape 3 : une récurrence. Montrons que pour tout entier naturel $n$, la propriété $\mathcal{P}(n)$ : « $0 \leqslant u_n \leqslant u_{n+1} \leqslant \dfrac{1}{2}$ » est vraie.
- Initialisation. $u_0 = 0$ et $u_1 = \dfrac{1}{4}$, donc $0 \leqslant u_0 \leqslant u_1 \leqslant \dfrac{1}{2}$ : $\mathcal{P}(0)$ est vraie.
- Hérédité. Supposons $\mathcal{P}(n)$ vraie pour un entier $n$ : $0 \leqslant u_n \leqslant u_{n+1} \leqslant \dfrac{1}{2}$. Comme $f$ est croissante sur $\left[0\,;\,\dfrac{1}{2}\right]$, on peut appliquer $f$ sans changer le sens des inégalités : $$f(0) \leqslant f(u_n) \leqslant f(u_{n+1})$$ $$\text{et} \quad f(u_{n+1}) \leqslant f\left(\dfrac{1}{2}\right).$$ Or $f(0) = \dfrac{1}{4} \geqslant 0$ et $f\left(\dfrac{1}{2}\right) = \dfrac{1}{4} + \dfrac{1}{8} + \dfrac{1}{8} = \dfrac{1}{2}$, donc $0 \leqslant u_{n+1} \leqslant u_{n+2} \leqslant \dfrac{1}{2}$ : $\mathcal{P}(n+1)$ est vraie.
- Conclusion. Par récurrence, $\mathcal{P}(n)$ est vraie pour tout entier naturel $n$.
Étape 4 : conclusion. La suite $(u_n)$ est croissante et majorée par $\dfrac{1}{2}$ : d'après le théorème de convergence monotone, elle converge vers une limite $\ell \leqslant \dfrac{1}{2}$. D'après l'étape 1, $\ell = \dfrac{1}{2}$ ou $\ell = 1$ ; donc $\ell = \dfrac{1}{2}$.
Ainsi, même si chaque homme a en moyenne $1{,}25$ fils, un nom sur deux finit par disparaître ! Et quand le nom survit, la famille finit par devenir très nombreuse. La figure suivante montre la construction en « escalier » de la suite pour d'autres valeurs de $p_0$ et $p_2$.
Ce que suggère la figure est un théorème (admis ici) : si le nombre moyen de fils $m$ est inférieur ou égal à $1$, le nom disparaît presque sûrement (sauf dans le cas trivial où chaque homme a exactement un fils) ; si $m > 1$, la probabilité de disparition est la plus petite solution de $f(x) = x$ dans $[0\,;\,1]$, et elle est strictement inférieure à $1$.
Le $0{,}8$ de la simulation de Chang s'explique ainsi : dans ce modèle, un individu a en moyenne $2$ enfants (chacun des $N$ enfants a deux parents choisis parmi $N$). Avec une loi de Poisson (hors programme), l'équation du point fixe devient $x = \mathrm{e}^{2(x - 1)}$, dont la plus petite solution vaut environ $0{,}20$. Une lignée sur cinq s'éteint ; les quatre autres finissent par atteindre tout le monde.
Le programme suivant simule $2\,000$ familles pendant $30$ générations avec la loi $\left(\dfrac{1}{4}\,;\,\dfrac{1}{4}\,;\,\dfrac{1}{2}\right)$ et compte la fréquence des noms disparus. Dès qu'une famille dépasse $200$ hommes, on la considère comme sauvée : sa probabilité de disparaître est alors inférieure à $\left(\dfrac{1}{2}\right)^{200}$.
La fréquence obtenue est proche de $0{,}5$. Avec $2\,000$ familles, l'intervalle de fluctuation au seuil de $95\,\%$ a une demi-largeur d'environ $\dfrac{1}{\sqrt{2\,000}} \approx 0{,}022$ : on obtient le plus souvent une valeur entre $0{,}48$ et $0{,}52$.
Le modèle explique une observation frappante. En Corée, où les noms de famille se transmettent par les pères depuis de nombreux siècles, il reste peu de noms : au recensement sud-coréen de 2015, environ $21\,\%$ de la population s'appelle Kim, $15\,\%$ Lee et $8\,\%$ Park. En Chine aussi, quelques noms (Wang, Li, Zhang…) sont portés chacun par des dizaines de millions de personnes. Génération après génération, des noms disparaissent et aucun nom nouveau n'apparaît : les noms survivants se partagent toute la population.
Au Japon, au contraire, les gens ordinaires n'ont reçu un nom de famille obligatoire qu'en 1875. Le « processus d'extinction » n'a eu que quelques générations pour agir, et il existe encore plus de $100\,000$ noms différents. En France, la loi permet depuis 2005 de transmettre le nom de la mère ou les deux noms accolés : le modèle de Galton-Watson, fondé sur les seuls fils, ne s'applique plus tel quel.
Le même modèle sert bien au-delà des noms : la survie d'une mutation nouvelle (voir le texte sur les mutations et leurs probabilités), une réaction nucléaire en chaîne, la propagation d'une épidémie au début, ou la survie des lignées maternelles de l'ADN mitochondrial, que l'on retrouve plus loin.
Pour chaque gène (sauf ceux des chromosomes sexuels), nous avons deux exemplaires, appelés allèles : l'un vient du père, l'autre de la mère. Lors de la reproduction, chaque parent transmet l'un de ses deux allèles, choisi au hasard avec la probabilité $\dfrac{1}{2}$, indépendamment de l'autre parent. C'est la loi de Mendel.
Conséquence : un allèle donné d'un grand-parent a la probabilité $\dfrac{1}{2} \times \dfrac{1}{2} = \dfrac{1}{4}$ d'arriver jusqu'à un petit-enfant donné, et plus généralement la probabilité $\left(\dfrac{1}{2}\right)^k$ de descendre $k$ générations.
Quand les parents ont un ancêtre commun, l'enfant peut recevoir, par son père et par sa mère, deux copies du même allèle de cet ancêtre. On dit que ses deux allèles sont identiques par ascendance. La probabilité de cet événement est le coefficient de consanguinité, noté $F$.
Reprenons l'arbre de l'implexe ci-dessus. On suppose que les arrière-grands-parents $A_1$ et $A_2$ ne sont pas eux-mêmes consanguins et n'ont pas d'ancêtre commun.
Étape 1 : par le père. L'allèle que l'enfant reçoit de son père $P$ vient de $B$ avec la probabilité $\dfrac{1}{2}$ (sinon il vient de $B'$) ; et l'allèle que $B$ avait transmis vient de $A_1$ avec la probabilité $\dfrac{1}{2}$. La probabilité que l'allèle paternel de l'enfant soit une copie d'un allèle de $A_1$ vaut donc $\dfrac{1}{2} \times \dfrac{1}{2} = \dfrac{1}{4}$.
Étape 2 : par la mère. De même, en passant par $M$ puis $C$, l'allèle maternel est une copie d'un allèle de $A_1$ avec la probabilité $\dfrac{1}{4}$, indépendamment de ce qui se passe du côté du père.
Étape 3 : le même allèle. Si les deux allèles de l'enfant viennent de $A_1$, ce sont des copies du même allèle de $A_1$ avec la probabilité $\dfrac{1}{2}$ ($A_1$ a deux allèles, transmis chacun avec la probabilité $\dfrac{1}{2}$, indépendamment à $B$ et à $C$). La probabilité que l'enfant ait deux copies du même allèle de $A_1$ vaut donc :
$$\dfrac{1}{4} \times \dfrac{1}{4} \times \dfrac{1}{2} = \dfrac{1}{32}.$$Étape 4 : les deux ancêtres communs. Le même raisonnement donne $\dfrac{1}{32}$ pour $A_2$. Les deux événements sont incompatibles (l'allèle paternel ne peut pas venir à la fois de $A_1$ et de $A_2$), donc
$$F = \dfrac{1}{32} + \dfrac{1}{32} = \dfrac{1}{16}.$$On remarque que $\dfrac{1}{32} = \left(\dfrac{1}{2}\right)^5$, où $5$ est le nombre de personnes sur la boucle rouge qui va du père à la mère en passant par l'ancêtre commun : $P$, $B$, $A_1$, $C$, $M$. C'est la règle générale, due au généticien Sewall Wright (1922) : chaque ancêtre commun apporte $\left(\dfrac{1}{2}\right)^{n}$, où $n$ est le nombre de personnes de la boucle.
| parents | ancêtres communs | personnes par boucle | $F$ |
|---|---|---|---|
| frère et sœur | $2$ | $3$ | $\dfrac{1}{4}$ |
| oncle et nièce | $2$ | $4$ | $\dfrac{1}{8}$ |
| cousins germains | $2$ | $5$ | $\dfrac{1}{16}$ |
| cousins issus de germains | $2$ | $7$ | $\dfrac{1}{64}$ |
Certaines maladies génétiques, comme la mucoviscidose, sont récessives : on n'est malade que si l'on porte deux allèles défectueux $a$. Notons $q$ la fréquence de l'allèle $a$ dans la population. Pour un enfant de parents sans lien de parenté, les deux allèles sont indépendants, et la probabilité d'être malade vaut $q^2$ (on l'admet : c'est la loi de Hardy-Weinberg, vue en SVT).
Pour un enfant de coefficient de consanguinité $F$, on note $I$ l'événement « les deux allèles sont identiques par ascendance » et $D$ l'événement « l'enfant est malade ». Si $I$ est réalisé, les deux allèles sont deux copies d'un même allèle, qui est $a$ avec la probabilité $q$ ; sinon ils sont indépendants.
D'après la formule des probabilités totales :
$$P(D) = P(I)\,P_I(D) + P\left(\overline{I}\right) P_{\overline{I}}(D)$$donc
$$P(D) = F q + (1 - F)\,q^2.$$Exemple. Prenons $q = \dfrac{1}{100}$ (une personne sur cinquante environ est alors porteuse saine). Pour des parents sans lien de parenté, $P(D) = q^2 = 0{,}0001$, soit $1$ naissance sur $10\,000$. Pour des cousins germains, $F = \dfrac{1}{16}$ :
$$P(D) = \dfrac{1}{16} \times 0{,}01 + \dfrac{15}{16} \times 0{,}0001$$ $$P(D) \approx 0{,}000\,72.$$Le risque est environ $7$ fois plus grand. Et plus l'allèle est rare, plus le rapport augmente : il vaut à peu près $\dfrac{F q}{q^2} = \dfrac{F}{q}$ quand $q$ est petit. C'est pourquoi les maladies récessives très rares se rencontrent surtout dans les familles ou les petites communautés où l'on se marie entre apparentés.
Ces calculs éclairent aussi l'histoire : depuis le IVe concile du Latran (1215), l'Église catholique interdisait le mariage jusqu'au quatrième degré de parenté, sauf dispense. Les familles royales, qui ne pouvaient épouser que des familles de même rang, demandaient ces dispenses sans cesse.
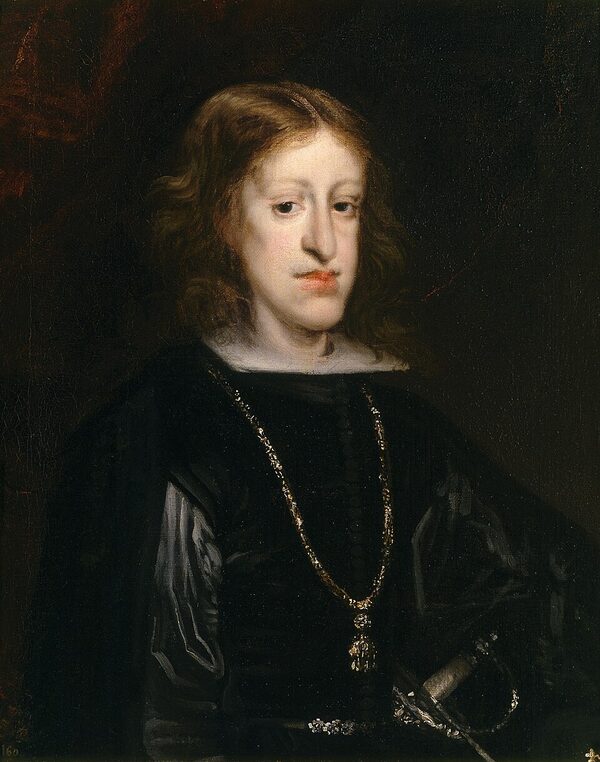
Pour garder leurs territoires dans la famille, les Habsbourg d'Espagne ont multiplié les mariages entre proches pendant près de deux siècles. Le roi Philippe IV a ainsi épousé en secondes noces sa propre nièce, Marie-Anne d'Autriche. Leur fils, Charles II, né en 1661, est devenu roi à quatre ans.
Un simple mariage oncle-nièce donne $F = \dfrac{1}{8} = 0{,}125$. Mais l'arbre de Charles II contient bien d'autres boucles, accumulées sur seize générations : en additionnant leurs contributions, une étude publiée en 2009 (Alvarez, Ceballos et Quinteiro) a estimé son coefficient de consanguinité à environ $0{,}25$, autant qu'un enfant de frère et sœur. Le même travail montre que la mortalité des enfants de la dynastie augmentait avec leur coefficient de consanguinité. Charles II, de santé très fragile, est mort en 1700 sans enfant. Sa succession a provoqué la guerre de Succession d'Espagne (1701-1714), qui a placé sur le trône un petit-fils de Louis XIV, Philippe V : la consanguinité a changé la carte politique de l'Europe.
Une étude de 2019 a aussi relié le degré de prognathisme visible sur les portraits de la famille à son coefficient de consanguinité. Ces travaux restent des estimations : ils reposent sur les arbres connus et sur des portraits, et la mâchoire des Habsbourg n'est pas forcément due à un seul gène.
Nous recevons la moitié de notre ADN de chaque parent. Un grand-parent nous transmet en moyenne un quart de notre ADN, et un ancêtre de la génération $n$ en moyenne $\left(\dfrac{1}{2}\right)^n$. Pour $n = 10$, environ trois siècles en arrière, cela fait moins de $0{,}1\,\%$.
Mais l'ADN ne se transmet pas en poussière : il passe en morceaux de chromosomes. Lors de la formation des ovules et des spermatozoïdes, chaque paire de chromosomes échange des segments (les crossing-over, environ $33$ en tout par génération chez l'humain). En remontant d'une génération, le nombre de segments augmente de façon linéaire, alors que le nombre d'ancêtres double. Il ne peut pas y avoir un segment pour chaque ancêtre.
Dans un modèle simplifié (Donnelly, 1983), le nombre moyen de segments d'ADN qu'un ancêtre de la génération $k$ nous a transmis vaut, pour $k \geqslant 1$ :
$$a_k = \dfrac{22 + 33(k-1)}{2^{k-1}} = \dfrac{33k - 11}{2^{k-1}}.$$À la main. $a_1 = 22$ (un parent nous donne $22$ chromosomes entiers, hors chromosomes sexuels), $a_2 = \dfrac{55}{2} = 27{,}5$, $a_3 = \dfrac{88}{4} = 22$, $a_8 = \dfrac{253}{128} \approx 1{,}98$, $a_{10} = \dfrac{319}{512} \approx 0{,}62$.
Décroissance. Pour tout entier $k \geqslant 1$, on met au même dénominateur $2^k$ :
$$a_{k+1} = \dfrac{33(k+1) - 11}{2^k}$$et
$$a_k = \dfrac{2(33k - 11)}{2^k},$$donc
$$a_{k+1} - a_k = \dfrac{33k + 22 - 66k + 22}{2^k}$$ $$a_{k+1} - a_k = \dfrac{44 - 33k}{2^k}.$$Pour $k \geqslant 2$, $44 - 33k \leqslant 44 - 66 < 0$, donc $a_{k+1} < a_k$ : la suite est strictement décroissante à partir du rang $2$.
Limite. On écrit $a_k = 2 \times \dfrac{33k - 11}{2^k} = 66 \times \dfrac{k}{2^k} - \dfrac{22}{2^k}$. Or
$$\dfrac{k}{2^k} = k\,\mathrm{e}^{-k \ln 2}$$ $$\dfrac{k}{2^k} = \dfrac{1}{\ln 2} \times \left(k \ln 2\right) \mathrm{e}^{-k \ln 2}.$$Quand $k$ tend vers $+\infty$, $X = k \ln 2$ tend vers $+\infty$ et, par croissances comparées, $X \mathrm{e}^{-X} \to 0$. Donc $\dfrac{k}{2^k} \to 0$. Comme $\dfrac{22}{2^k} \to 0$ (suite géométrique de raison $\dfrac{1}{2}$), on obtient $\displaystyle\lim_{k \to +\infty} a_k = 0$.
À partir de la génération $10$, un ancêtre nous a transmis en moyenne moins d'un segment d'ADN : beaucoup de nos ancêtres ne nous ont rien laissé du tout. Dans ce modèle, environ la moitié de nos ancêtres de la génération $10$ ne nous ont transmis aucun segment, et à la génération $15$ presque tous. Nous avons environ $1\,000$ ancêtres « généalogiques » à la génération $10$, mais quelques centaines seulement d'ancêtres « génétiques ». C'est une limite des tests ADN récréatifs : ne pas retrouver l'ADN d'un ancêtre ne prouve pas qu'il n'en est pas un.
Deux morceaux de notre ADN échappent au mélange :
- l'ADN mitochondrial, contenu dans les mitochondries, est transmis uniquement par la mère, sans mélange : nous avons celui de notre mère, qui avait celui de sa mère, et ainsi de suite ;
- le chromosome Y est transmis uniquement de père en fils, presque sans échange avec le chromosome X.
Chacun de ces ADN suit une seule lignée de l'arbre : la lignée des mères pour le premier, celle des pères pour le second, exactement comme un nom de famille. Le processus de Galton-Watson s'applique donc : au fil des générations, des lignées s'éteignent (une femme qui n'a que des fils, ou pas d'enfants, interrompt sa lignée mitochondriale), et toutes les lignées actuelles finissent, en remontant, par se rejoindre en une seule.
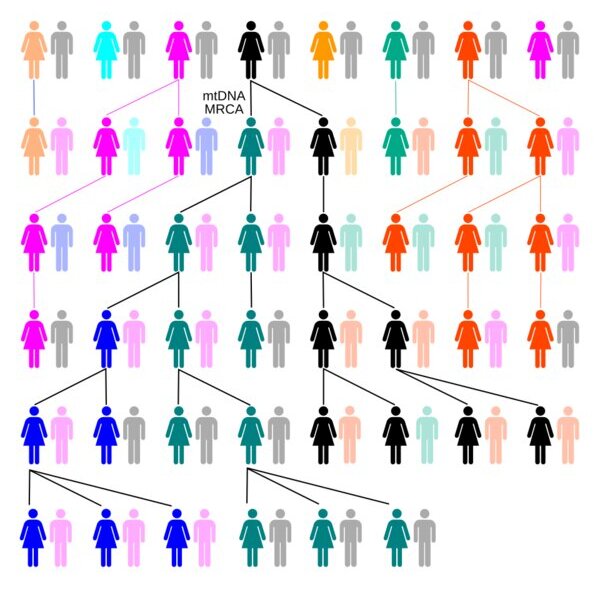
L'Ève mitochondriale est la femme dont descendent, de mère en fille, tous les humains vivants. En comparant les ADN mitochondriaux de personnes du monde entier et en estimant la vitesse des mutations (voir l'horloge moléculaire), les généticiens la situent en Afrique, il y a de l'ordre de $150\,000$ à $200\,000$ ans (les estimations varient selon les études).
Trois contresens sont fréquents :
- elle n'était pas la seule femme de son époque : d'autres femmes vivaient avec elle et sont aussi nos ancêtres, mais par des chemins qui passent au moins une fois par un homme ;
- elle n'est pas fixée pour toujours : si une lignée issue d'elle s'éteint, l'Ève de demain peut être l'une de ses descendantes, plus récente (c'est ce que montre le schéma) ;
- elle n'est pas notre ancêtre commun le plus récent : d'après le modèle de Chang, l'ancêtre commun généalogique de tous les humains vivait il y a seulement quelques milliers d'années (Rohde, Olson et Chang, 2004). En imposant de ne suivre que les mères, on remonte beaucoup plus loin.
De la même façon, l'Adam chromosomique Y est l'homme dont descendent, de père en fils, tous les hommes vivants. Les estimations de son âge varient beaucoup selon les méthodes, de l'ordre de $100\,000$ à plus de $200\,000$ ans. Rien n'oblige Adam et Ève à avoir vécu à la même époque, ni à s'être connus : chacun est simplement le point où se rejoignent les lignées d'un seul type, et ces lignées s'éteignent au hasard, à des rythmes différents. C'est aussi un effet de la dérive génétique : dans une population finie, une seule lignée finit toujours par l'emporter.
Ce texte n'est pas un Grand Oral. Il rassemble des connaissances dans lesquelles chacun peut choisir une direction, la creuser et formuler sa propre question. Quelques directions possibles :
- Mathématiques : la suite géométrique des ancêtres et le logarithme ; la suite récurrente de Galton-Watson, son point fixe et sa démonstration par récurrence ; le coefficient de consanguinité par les probabilités conditionnelles ; une suite qui tend vers $0$ par croissances comparées.
- SVT : la transmission des allèles et les maladies récessives ; la consanguinité ; l'ADN mitochondrial, le chromosome Y et l'histoire du peuplement humain ; ce que peuvent dire les tests ADN.
- HGGSP : les mariages dynastiques et la guerre de Succession d'Espagne ; la disparition des noms et les règles de transmission selon les pays ; la généalogie comme source historique.
Le jury peut interroger sur les chapitres de spécialité mobilisés. Avec ce thème, il est utile de connaître parfaitement : les suites géométriques et la somme de leurs termes ; la fonction logarithme et la résolution d'inéquations $q^n > a$ ; le raisonnement par récurrence, le théorème de convergence monotone et les suites $u_{n+1} = f(u_n)$ ; la dérivation et les variations d'une fonction ; les probabilités conditionnelles, les arbres pondérés et la formule des probabilités totales ; l'espérance d'une variable aléatoire ; les croissances comparées.
Pour réviser ces chapitres, l'application Maths FlashBac reprend tout le cours de spécialité en cartes.
- Implexe, processus de Galton-Watson, coefficient de consanguinité et Ève mitochondriale (Wikipédia).
- Sur ce site : La dérive génétique, Les mutations et leurs probabilités et La planche de Galton.