← Tous les textes du Grand Oral
MathsPC
Aucune mesure n'est exacte. Le chronomètre est déclenché un peu trop tôt ou trop tard, la règle est lue de travers, le thermomètre réagit avec retard. Si l'on refait la même mesure plusieurs fois, on n'obtient presque jamais le même nombre. Que faut-il alors annoncer comme résultat ? Avec quelle confiance ? Et comment une petite erreur sur une longueur se répercute-t-elle sur une aire ou sur une constante physique calculée à partir d'elle ?
La théorie des erreurs répond à ces questions. Elle est née au tournant des XVIIIe et XIXe siècles, chez les astronomes et les géomètres qui voulaient tirer le meilleur de mesures imparfaites. Ce texte la présente avec les outils de terminale : variables aléatoires, espérance et variance, dérivée et approximation affine, fonctions du second degré, inégalité de Bienaymé-Tchebychev. Il rassemble des connaissances ; à chacun d'y choisir une direction et d'y construire sa question.
- Mesurer plusieurs fois : moyenne et écart type
- Pourquoi l'incertitude d'une moyenne est divisée par $\sqrt{n}$
- Répéter les mesures : la loi des grands nombres
- La propagation des erreurs
- Un exemple complet : mesurer $g$ avec un pendule
- Legendre, Gauss et la méthode des moindres carrés
- Simuler des mesures en Python
- Ce que la théorie ne corrige pas
- Des directions pour construire sa question
Un élève mesure au chronomètre la durée de $10$ oscillations d'un pendule. Il recommence six fois et obtient, en secondes (ces mesures sont inventées pour l'exemple) :
| mesure | $1$ | $2$ | $3$ | $4$ | $5$ | $6$ |
|---|---|---|---|---|---|---|
| durée (s) | $20{,}1$ | $19{,}8$ | $20{,}3$ | $20{,}0$ | $19{,}9$ | $20{,}2$ |
- La moyenne : la somme des six durées vaut $120{,}3$, donc $\overline{x} = \dfrac{120{,}3}{6} = 20{,}05$ s.
- Les écarts à la moyenne : $0{,}05$ ; $-0{,}25$ ; $0{,}25$ ; $-0{,}05$ ; $-0{,}15$ ; $0{,}15$. Leur somme est nulle, comme toujours.
- Leurs carrés : $0{,}0025$ ; $0{,}0625$ ; $0{,}0625$ ; $0{,}0025$ ; $0{,}0225$ ; $0{,}0225$, de somme $0{,}175$.
En physique-chimie, on calcule l'écart type expérimental en divisant cette somme par $n - 1 = 5$ (et non par $n$ ; on admet ici que ce choix corrige une petite sous-estimation) :
$$s = \sqrt{\frac{0{,}175}{5}} = \sqrt{0{,}035} \approx 0{,}19 \text{ s}.$$L'écart type mesure la dispersion des mesures : une mesure isolée s'écarte typiquement de $0{,}2$ s de la moyenne. Mais la moyenne de six mesures est plus fiable qu'une mesure seule. En physique-chimie, on lui associe l'incertitude-type
$$u(\overline{x}) = \frac{s}{\sqrt{n}} = \frac{0{,}19}{\sqrt{6}} \approx 0{,}08 \text{ s},$$et l'on écrit le résultat $20{,}05$ s avec une incertitude-type de $0{,}08$ s. D'où vient ce $\sqrt{n}$ ?
Modélisons. Chaque mesure est une variable aléatoire $X_i$ : la vraie valeur $\mu$ plus une erreur due au hasard. On suppose que les $n$ mesures sont indépendantes (une erreur ne dépend pas des précédentes) et qu'elles suivent la même loi, d'espérance $\mu$ (pas d'erreur systématique) et de variance $\sigma^2$. La moyenne des mesures est la variable aléatoire
$$M_n = \frac{X_1 + X_2 + \cdots + X_n}{n}.$$Étape 1 : l'espérance. Par linéarité de l'espérance, $E(X_1 + \cdots + X_n) = n\mu$, donc $E(M_n) = \dfrac{n\mu}{n} = \mu$. En moyenne, la moyenne des mesures ne se trompe pas.
Étape 2 : la variance de la somme. Les mesures étant indépendantes, la variance de leur somme est la somme de leurs variances :
$$V\Big(\sum_{i=1}^{n} X_i\Big) = \sum_{i=1}^{n} V(X_i) = n\sigma^2.$$Étape 3 : la variance de la moyenne. Pour un réel $a$, $V(aX) = a^2 V(X)$. Avec $a = \dfrac{1}{n}$ :
$$V(M_n) = \frac{1}{n^2} \times n\sigma^2 = \frac{\sigma^2}{n}.$$Étape 4 : l'écart type. C'est la racine carrée de la variance : $\sigma(M_n) = \dfrac{\sigma}{\sqrt{n}}$.
C'est exactement la formule de l'incertitude-type, où l'écart type inconnu $\sigma$ est remplacé par son estimation $s$.
Une conséquence pratique, et un peu décevante. Pour diviser l'incertitude par $2$, il faut $4$ fois plus de mesures ; pour la diviser par $10$, il en faut $100$ fois plus. Répéter les mesures améliore la précision, mais de plus en plus lentement. On retrouve cette lenteur dans la méthode de Monte-Carlo (voir le texte La méthode de Monte-Carlo).
L'inégalité de Bienaymé-Tchebychev, appliquée à $M_n$, d'espérance $\mu$ et de variance $\dfrac{\sigma^2}{n}$, donne, pour tout $\delta > 0$ :
$$P\big(|M_n - \mu| \geqslant \delta\big) \leqslant \frac{\sigma^2}{n\,\delta^2}.$$Un exemple. Prenons $\sigma = 0{,}2$ s comme pour le chronomètre. Combien faut-il de mesures pour que la moyenne soit à moins de $\delta = 0{,}1$ s de la vraie valeur avec une probabilité d'au moins $0{,}95$ ?
- Il suffit que $\dfrac{\sigma^2}{n\,\delta^2} \leqslant 0{,}05$, c'est-à-dire $\dfrac{0{,}04}{n \times 0{,}01} \leqslant 0{,}05$.
- Soit $\dfrac{4}{n} \leqslant 0{,}05$, c'est-à-dire $n \geqslant 80$.
Quand $n$ tend vers $+\infty$, le majorant tend vers $0$ : c'est la loi des grands nombres. Plus le nombre de mesures est grand, plus il est probable que la moyenne des mesures soit proche de la vraie valeur. L'inégalité est prudente : en pratique, beaucoup moins de $80$ mesures suffisent souvent, mais elle a l'avantage d'être démontrée sans rien supposer d'autre sur la loi des erreurs.
On mesure le côté d'un carré : $10{,}0$ cm, avec une erreur possible de $0{,}1$ cm. L'aire annoncée est $100$ cm². Si le côté vaut en réalité $10{,}1$ cm, l'aire vaut $10{,}1^2 = 102{,}01$ cm² : l'erreur sur l'aire est d'environ $2$ cm², soit $2\,\%$, alors que l'erreur sur le côté n'était que de $1\,\%$.
Si $f$ est dérivable en $x_0$, la tangente à sa courbe en $x_0$ approche la courbe au voisinage de $x_0$ : pour $h$ petit,
$$f(x_0 + h) \approx f(x_0) + f'(x_0)\,h.$$Une erreur $h$ sur la mesure de $x$ entraîne donc une erreur d'environ $f'(x_0)\,h$ sur le résultat. Pour le carré, $f(x) = x^2$, $f'(10) = 20$, et $f'(10) \times 0{,}1 = 2$ : on retrouve l'erreur de $2$ cm² (la valeur exacte est $2{,}01$ ; l'écart, $h^2 = 0{,}01$, est négligeable).
Ici $f'(x) = k\,x^{k-1}$. L'erreur sur $f$ vaut environ $k\,x_0^{\,k-1}\,h$. En la divisant par $f(x_0) = x_0^{\,k}$ :
$$\frac{\text{erreur sur } f}{f(x_0)} \approx \frac{k\,x_0^{\,k-1}\,h}{x_0^{\,k}} = k \times \frac{h}{x_0}.$$- Pour une aire ($k = 2$), l'erreur relative est doublée ; pour un volume ($k = 3$), elle est triplée : $1\,\%$ d'erreur sur l'arête d'un cube donne environ $3\,\%$ d'erreur sur son volume.
- Pour un quotient du type $\dfrac{1}{x}$ ($k = -1$), l'erreur relative est la même, au signe près.
- Pour une racine carrée ($k = \dfrac{1}{2}$), elle est divisée par $2$ : prendre la racine « arrange » la précision.
Souvent, le résultat dépend de plusieurs mesures. Si $G = \dfrac{A}{B^2}$, on passe au logarithme : $\ln G = \ln A - 2\ln B$. La dérivée de $\ln$ étant $\dfrac{1}{x}$, l'approximation affine donne, pour les erreurs relatives,
$$\frac{\Delta G}{G} \approx \frac{\Delta A}{A} - 2\,\frac{\Delta B}{B}.$$Si les erreurs sur $A$ et $B$ sont des variables aléatoires indépendantes, la variance de cette combinaison est, comme plus haut, la somme des variances : $V(aX + bY) = a^2V(X) + b^2V(Y)$. C'est pourquoi, en physique-chimie, les incertitudes-types relatives se composent « au carré » :
$$\left(\frac{u(G)}{G}\right)^2 = \left(\frac{u(A)}{A}\right)^2 + 4\left(\frac{u(B)}{B}\right)^2.$$Les erreurs ont des chances de se compenser en partie : c'est moins pessimiste que d'additionner les pires erreurs.
Pour de petites oscillations, la période d'un pendule simple de longueur $L$ vaut $T = 2\pi\sqrt{\dfrac{L}{g}}$ (formule admise, vue en physique). En l'élevant au carré et en isolant $g$ :
$$g = \frac{4\pi^2 L}{T^2}.$$- Les mesures. La longueur est $L = 1{,}000$ m, d'incertitude-type $0{,}002$ m. Avec les mesures de la première partie, dix périodes durent en moyenne $20{,}05$ s, donc $T = 2{,}005$ s, d'incertitude-type $\dfrac{0{,}076}{10} \approx 0{,}0076$ s. Mesurer dix périodes d'un coup divise l'incertitude par $10$ !
- Le résultat. $g = \dfrac{4\pi^2 \times 1{,}000}{2{,}005^2}$, soit $g \approx \dfrac{39{,}48}{4{,}020} \approx 9{,}82$ m/s².
- Les incertitudes relatives. $\dfrac{u(L)}{L} = 0{,}002$ et $2\,\dfrac{u(T)}{T} = 2 \times \dfrac{0{,}0076}{2{,}005} \approx 0{,}0076$.
La composition.
$$\frac{u(g)}{g} = \sqrt{0{,}002^2 + 0{,}0076^2} \approx 0{,}0079,$$soit $u(g) \approx 0{,}08$ m/s².
Le résultat s'écrit $g = 9{,}82$ m/s² avec une incertitude-type de $0{,}08$ m/s², compatible avec la valeur de référence à Paris, environ $9{,}81$ m/s². Le calcul montre aussi où faire des efforts : l'erreur sur la période, comptée deux fois à cause du carré, pèse bien plus que celle sur la longueur. Il vaut mieux chronométrer plus d'oscillations que mesurer le fil plus soigneusement.
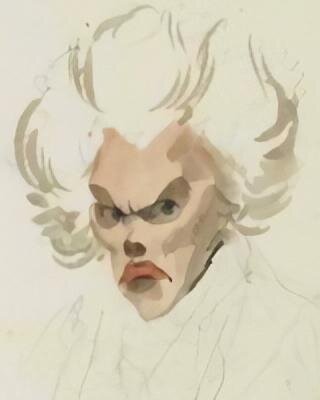
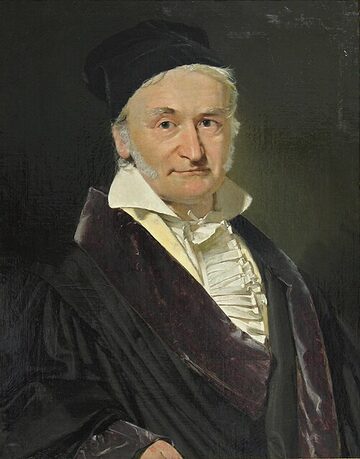
Le 1er janvier 1801, l'astronome italien Giuseppe Piazzi découvre un nouvel astre, Cérès. Il ne peut l'observer que quelques semaines avant que l'astre se perde dans l'éclat du Soleil. Comment le retrouver, à partir d'une poignée de positions entachées d'erreurs ? Le jeune mathématicien allemand Carl Friedrich Gauss calcule son orbite, et c'est grâce à ses prédictions que d'autres astronomes le retrouvent à la fin de 1801. Gauss expliquera plus tard avoir utilisé une méthode qui consiste à rendre minimale la somme des carrés des écarts.
Mais c'est le Français Adrien-Marie Legendre qui publie le premier cette méthode, en 1805, dans un ouvrage sur les orbites des comètes, sous le nom de méthode des moindres carrés. Quand Gauss la publie à son tour en 1809, en affirmant l'utiliser depuis 1795, Legendre proteste : c'est l'une des querelles de priorité célèbres de l'histoire des mathématiques. Gauss relie de plus la méthode à une loi des erreurs « en cloche », qu'on appelle aujourd'hui loi normale ou loi de Gauss, hors du programme de terminale.
Un élève mesure la tension $U$ aux bornes d'une résistance pour plusieurs intensités $I$ (mesures inventées pour l'exemple) :
| $I$ (A) | $0{,}1$ | $0{,}2$ | $0{,}3$ | $0{,}4$ | $0{,}5$ | $0{,}6$ |
|---|---|---|---|---|---|---|
| $U$ (V) | $1{,}1$ | $1{,}9$ | $3{,}2$ | $3{,}9$ | $5{,}1$ | $6{,}0$ |
D'après la loi d'Ohm, $U = R\,I$ : les points devraient être alignés avec l'origine, mais les erreurs de mesure les dispersent un peu. Quelle droite choisir ? L'idée de Legendre : pour une droite donnée, on calcule pour chaque point l'écart vertical entre la mesure et la droite, on élève ces écarts au carré (pour que les écarts positifs et négatifs ne se compensent pas), on les additionne, et l'on choisit la droite qui rend cette somme la plus petite possible.
Notons $(x_1\,;y_1), \ldots, (x_n\,;y_n)$ les points. Pour la droite d'équation $y = ax$, la somme des carrés des écarts est
$$S(a) = (y_1 - a x_1)^2 + \cdots + (y_n - a x_n)^2.$$Étape 1 : développer. Chaque terme vaut $y_i^2 - 2a\,x_i y_i + a^2 x_i^2$. En additionnant :
$$S(a) = A\,a^2 - 2B\,a + C,$$avec $A = \sum x_i^2$, $B = \sum x_i y_i$ et $C = \sum y_i^2$.
Étape 2 : étudier. $S$ est une fonction polynôme du second degré en $a$, de coefficient $A > 0$ (les $x_i$ ne sont pas tous nuls). Sa dérivée $S'(a) = 2A\,a - 2B$ est négative puis positive, et s'annule pour $a = \dfrac{B}{A}$ : c'est le minimum.
Pour nos mesures. Les six produits $x_i y_i$ valent $0{,}11$ ; $0{,}38$ ; $0{,}96$ ; $1{,}56$ ; $2{,}55$ ; $3{,}6$, donc $\sum x_i y_i = 9{,}16$, et $\sum x_i^2 = 0{,}91$, donc $R \approx \dfrac{9{,}16}{0{,}91} \approx 10{,}1$ Ω.
Pour la droite d'équation $y = ax + b$, la somme des carrés dépend de deux nombres. On procède en deux temps, en ne faisant varier qu'un nombre à la fois.
- À pente $a$ fixée, la somme $\sum (y_i - a x_i - b)^2$ est un polynôme du second degré en $b$, de coefficient $n > 0$. Sa dérivée par rapport à $b$ vaut $-2\sum (y_i - a x_i - b)$, qui s'annule pour $b = \overline{y} - a\,\overline{x}$, où $\overline{x}$ et $\overline{y}$ sont les moyennes. Autrement dit, la meilleure droite passe par le point moyen $(\overline{x}\,;\overline{y})$.
- En remplaçant $b$ par cette valeur, chaque écart devient $(y_i - \overline{y}) - a\,(x_i - \overline{x})$ : on est ramené au cas précédent, avec les données « centrées » sur le point moyen. La pente optimale est donc
Pour nos mesures, le point moyen est $(0{,}35\,;3{,}53)$, la pente vaut environ $9{,}94$ et l'ordonnée à l'origine environ $0{,}05$, très proche de $0$, comme le prévoit la loi d'Ohm. C'est le calcul que font la calculatrice ou le tableur quand on leur demande une « régression linéaire ». La figure permet de faire varier la pente d'une droite passant par le point moyen et de chercher à la main la plus petite somme des carrés.
Le programme suivant simule un chronométrage. La vraie période vaut $2$ s ; chaque mesure lui ajoute une erreur tirée au hasard entre $-0{,}3$ et $0{,}3$ s. Pour $n = 5$, $50$ puis $500$ mesures, il recommence $400$ fois l'expérience et compte la fréquence des cas où la moyenne s'écarte de plus de $0{,}05$ s de la vraie valeur. Plus $n$ est grand, plus cette fréquence est petite : plus il est probable que la moyenne soit proche de la vraie valeur. La dernière ligne ajoute une erreur systématique de $0{,}1$ s (un chronomètre toujours déclenché en retard) : la moyenne se rapproche alors de $2{,}1$, et non de $2$.
Ici, une erreur tirée uniformément entre $-0{,}3$ et $0{,}3$ a pour écart type environ $0{,}17$ (valeur admise). Pour $n = 500$, l'écart type de la moyenne est donc d'environ $\dfrac{0{,}17}{\sqrt{500}} \approx 0{,}008$ : il devient très rare de s'écarter de $0{,}05$.
- Les erreurs systématiques. Répéter les mesures diminue l'effet du hasard, pas celui d'un défaut qui agit toujours dans le même sens : un instrument mal étalonné, une règle dilatée, un réflexe toujours en retard. En 2011, l'expérience OPERA a cru mesurer des neutrinos plus rapides que la lumière ; l'anomalie venait notamment d'un câble de fibre optique mal branché. Aucune répétition des mesures ne pouvait la faire disparaître.
- L'indépendance. Les calculs de variance supposent les erreurs indépendantes. Si les erreurs sont liées (même opérateur fatigué, même instrument qui dérive), l'incertitude est sous-estimée.
- Les petites erreurs. L'approximation affine ne vaut que pour des erreurs petites devant la grandeur mesurée.
- Les valeurs aberrantes. La méthode des moindres carrés est très sensible à un point faux : en élevant au carré, un grand écart pèse énormément. Il faut regarder les données avant de calculer.
Ce texte n'est pas un Grand Oral. Il rassemble des connaissances dans lesquelles chacun peut choisir une direction, la creuser et formuler sa propre question. Quelques directions possibles :
- Mathématiques : la variance d'une moyenne et le facteur $\dfrac{1}{\sqrt{n}}$ ; l'inégalité de Bienaymé-Tchebychev et le nombre de mesures nécessaire ; l'approximation affine et la propagation des erreurs ; la méthode des moindres carrés par l'étude d'une fonction du second degré.
- Physique-chimie : l'incertitude-type, la composition des incertitudes, la mesure de $g$ avec un pendule, la régression linéaire en travaux pratiques, les erreurs systématiques.
Le jury peut interroger sur les chapitres de spécialité mobilisés. Avec ce thème, il est utile de connaître parfaitement : les variables aléatoires, l'espérance et la variance, leurs propriétés (linéarité de l'espérance, variance d'une somme de variables indépendantes, $V(aX) = a^2V(X)$) ; l'inégalité de Bienaymé-Tchebychev et la loi des grands nombres ; la dérivation, l'équation de la tangente et l'approximation affine ; la fonction logarithme et sa dérivée ; les fonctions du second degré et leur extremum.
Pour réviser ces chapitres, l'application Maths FlashBac reprend tout le cours de spécialité en cartes.
- Méthode des moindres carrés, incertitude de mesure et inégalité de Bienaymé-Tchebychev (Wikipédia).
- Sur ce site : La méthode de Monte-Carlo, La linguistique quantitative (droites obtenues par le logarithme) et La planche de Galton (la courbe en cloche).