← Tous les textes du Grand Oral
MathsSVTSES
Mille personnes à dépister, une maladie rare, des tests coûteux. La solution évidente consiste à faire mille tests. En 1943, un jeune statisticien américain, Robert Dorfman, propose une idée plus astucieuse : mélanger les prélèvements par petits groupes et tester chaque mélange. Si le mélange est négatif, tout le groupe est sain, et un seul test a suffi pour plusieurs personnes. S'il est positif, on reteste chacun. Quand la maladie est rare, la plupart des groupes sont négatifs, et l'on économise une grande partie des tests.
Combien de personnes faut-il mettre dans un groupe ? Jusqu'à quelle fréquence de la maladie l'idée reste-t-elle intéressante ? Combien de tests faudra-t-il vraiment ? Ces questions se traitent entièrement avec les mathématiques de terminale : variables aléatoires et espérance, loi binomiale, étude de fonctions avec l'exponentielle et le logarithme, raisonnement par récurrence, inégalité de Bienaymé-Tchebychev, algorithmique. L'idée a été redécouverte à grande échelle en 2020, pendant l'épidémie de Covid-19.
Ce texte rassemble ces connaissances. Il ne propose pas de Grand Oral tout fait : à chacun d'y choisir une direction et d'y construire sa question.
- 1943 : la syphilis et les recrues américaines
- Un exemple à la main : 1 000 recrues, groupes de 5
- Le nombre de tests : une variable aléatoire
- Quelle taille de groupe choisir ?
- Quand le groupement ne sert plus à rien
- Combien de tests faudra-t-il vraiment ?
- 2020 : la Covid-19 et le problème de la dilution
- Des méthodes plus fines : matrices et dichotomie
- Les dons de sang et les limites du modèle
- Des directions pour construire sa question
Pendant la Seconde Guerre mondiale, les États-Unis appellent sous les drapeaux des millions de jeunes hommes. La syphilis est alors une maladie fréquente et grave : la pénicilline commence à peine à être produite, et l'armée veut écarter ou soigner les recrues infectées. Chaque appelé subit une prise de sang, analysée par le test de Wassermann, qui détecte dans le sang des anticorps liés à la maladie. Des millions de tests, c'est beaucoup de temps de laboratoire et beaucoup d'argent.
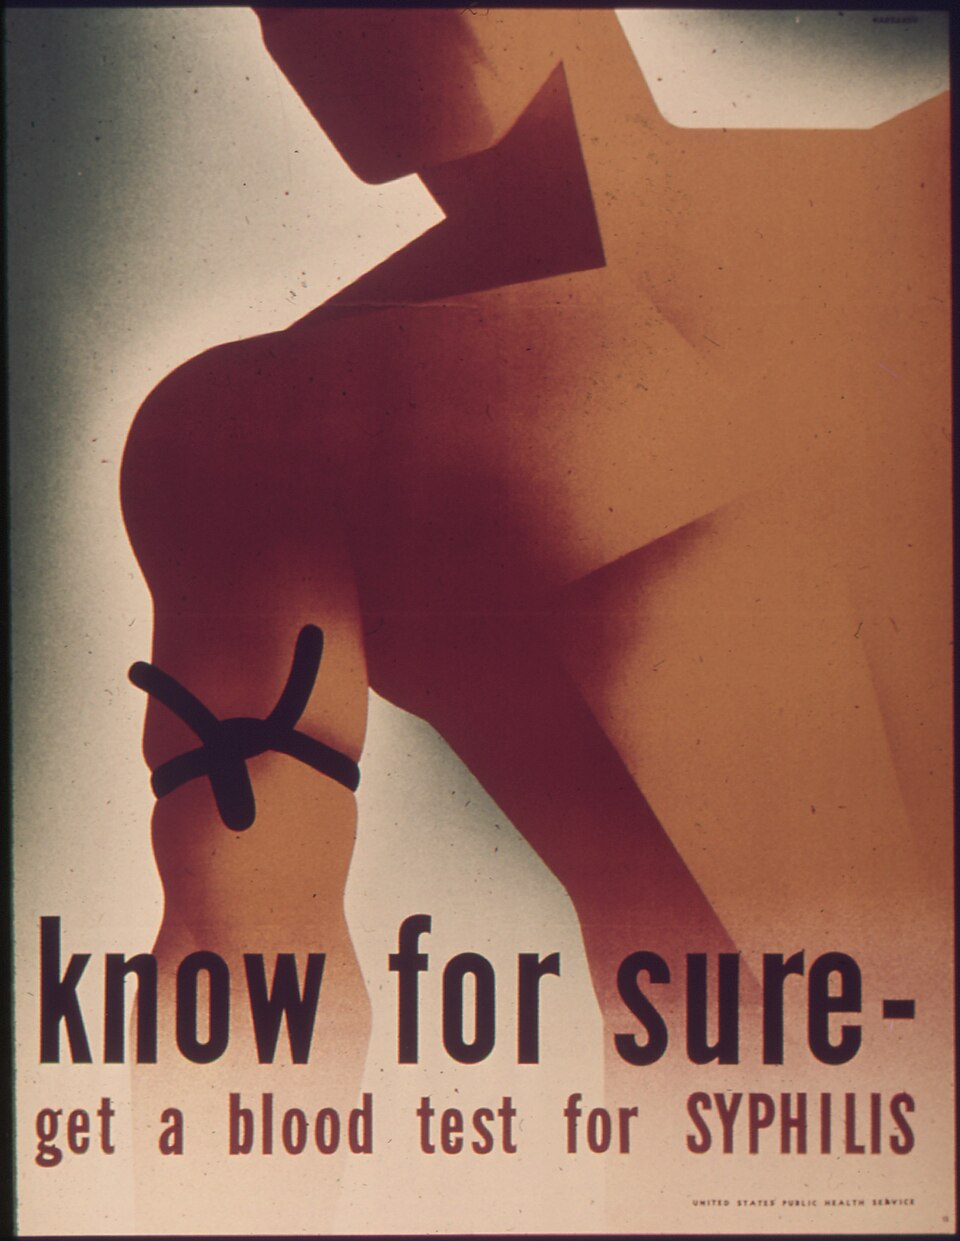
Robert Dorfman (1916-2002), alors statisticien au service du gouvernement fédéral, publie en 1943 un article de quatre pages dans The Annals of Mathematical Statistics, intitulé « La détection des membres défectueux de grandes populations ». L'idée y tient en une phrase : on mélange le sang de $k$ personnes, on teste le mélange, et l'on ne teste individuellement que les membres des groupes positifs. L'idée aurait mûri lors d'une discussion avec un collègue, David Rosenblatt. Il semble qu'elle n'ait pas été appliquée à grande échelle à l'époque, notamment parce qu'un sang dilué dans d'autres devient plus difficile à détecter (on y reviendra). Dorfman deviendra ensuite un économiste connu, en particulier pour ses travaux sur la programmation linéaire.
Ce petit article a pourtant fondé tout un domaine, appelé en anglais group testing : les mathématiques de la recherche d'éléments « défectueux » par des tests portant sur des groupes. On le retrouve en médecine, en contrôle de qualité industriel, en informatique et en biologie moléculaire.
Prenons $1\,000$ recrues et supposons, pour l'exemple, que chacune est infectée avec la probabilité $p = 0{,}02$ (soit $2\,\%$), indépendamment des autres. C'est une valeur choisie pour faire le calcul, pas une statistique de 1943. On forme $200$ groupes de $5$ personnes.
Étape 1 : la probabilité qu'un groupe soit négatif. Le mélange est négatif si et seulement si les $5$ personnes sont saines. Chacune est saine avec la probabilité $1 - 0{,}02 = 0{,}98$, et les personnes sont indépendantes, donc on multiplie :
$$P(\text{groupe négatif}) = 0{,}98^5 \approx 0{,}904.$$Un groupe est donc positif avec la probabilité $1 - 0{,}98^5 \approx 0{,}096$ : environ un groupe sur dix.
Étape 2 : le nombre moyen de groupes positifs. Sur $200$ groupes, on attend en moyenne $200 \times 0{,}096 \approx 19{,}2$ groupes positifs.
Étape 3 : le nombre moyen de tests. On fait $200$ tests de mélanges, puis $5$ tests individuels pour chaque groupe positif :
$$200 + 19{,}2 \times 5 = 296.$$En moyenne, environ $296$ tests au lieu de $1\,000$ : on économise à peu près $70\,\%$ des tests, et l'on trouve quand même toutes les personnes infectées (si le test ne se trompe jamais, hypothèse que l'on discutera).
Généralisons. Chaque personne est infectée avec la probabilité $p$, indépendamment des autres, et l'on note $q = 1 - p$. On forme un groupe de $k$ personnes ($k \geqslant 2$) et l'on appelle $T$ le nombre de tests utilisés pour ce groupe.
Étape 1 : les valeurs de $T$. Si le mélange est négatif, $T = 1$. S'il est positif, on fait en plus $k$ tests individuels, donc $T = 1 + k$.
Étape 2 : la loi de $T$. Notons $X_1$, …, $X_k$ les variables de Bernoulli qui valent $1$ si la personne est infectée. Le mélange est négatif quand $X_1 = 0$, …, $X_k = 0$, événements indépendants de probabilité $q$ chacun, donc $P(T = 1) = q^k$.
| valeur $t$ | $1$ | $1 + k$ |
|---|---|---|
| $P(T = t)$ | $q^k$ | $1 - q^k$ |
Étape 3 : l'espérance. Par définition,
$$E(T) = 1 \times q^k + (1 + k)\left(1 - q^k\right),$$et, en développant,
$$E(T) = 1 + k\left(1 - q^k\right).$$Étape 4 : le coût par personne. Le groupe compte $k$ personnes, donc le nombre moyen de tests par personne est
$$f(k) = \frac{E(T)}{k} = \frac{1}{k} + 1 - q^k.$$On vérifie sur l'exemple : $f(5) = 0{,}2 + 1 - 0{,}98^5 \approx 0{,}296$, soit $296$ tests pour $1\,000$ personnes. Le groupement est intéressant lorsque $f(k) < 1$, c'est-à-dire lorsqu'il coûte en moyenne moins d'un test par personne.
La formule se lit facilement : $\frac{1}{k}$ est la part du test de mélange qui revient à chaque personne, et $1 - q^k$ est la probabilité qu'elle doive être retestée. Un grand groupe partage mieux le premier test, mais il est plus souvent positif : les deux termes tirent en sens contraire, et il existe une taille idéale.
Le tableur ci-dessous calcule $f(k)$ pour $k$ allant de $2$ à $30$. La puissance $q^k$ y est
obtenue de proche en proche, comme une suite géométrique : chaque ligne multiplie la précédente par $q$. On peut
changer la prévalence dans la case jaune B1 (avec un point décimal, par exemple 0.01).
Pour $p = 0{,}02$, la colonne C est minimale pour $k = 8$ : environ $0{,}274$ test par personne, soit $73\,\%$ d'économie. Mais la courbe est très plate autour du minimum : des groupes de $6$ à $10$ donnent presque le même résultat. Avec $p = 0{,}01$, on trouve $k = 11$ et environ $0{,}196$ test par personne : on retrouve l'économie d'environ $80\,\%$ annoncée par Dorfman pour une maladie touchant une personne sur cent.
Le tableur donne le meilleur $k$ pour chaque $p$, mais on aimerait une formule. Elle vient d'une inégalité classique.
Inégalité de Bernoulli. Pour tout réel $p \in [0 ; 1]$ et tout entier $k \geqslant 1$, $(1 - p)^k \geqslant 1 - kp$.
Initialisation. Pour $k = 1$, les deux membres valent $1 - p$ : l'inégalité est vraie.
Hérédité. Supposons $(1 - p)^k \geqslant 1 - kp$ pour un entier $k \geqslant 1$. Comme $1 - p \geqslant 0$, on peut multiplier les deux membres par $1 - p$ sans changer le sens :
$$(1 - p)^{k+1} \geqslant (1 - kp)(1 - p).$$On développe le membre de droite :
$$\begin{aligned} &(1 - kp)(1 - p) \\ &= 1 - p - kp + kp^2 \\ &= 1 - (k+1)p + kp^2. \end{aligned}$$Or $kp^2 \geqslant 0$, donc $(1 - p)^{k+1} \geqslant 1 - (k+1)p$ : la propriété est vraie au rang $k + 1$.
Conclusion. Par récurrence, l'inégalité est vraie pour tout entier $k \geqslant 1$.
On en déduit $1 - q^k \leqslant kp$, donc une majoration du coût par personne :
$$f(k) \leqslant \frac{1}{k} + kp.$$Étudions la fonction $g(x) = \dfrac{1}{x} + px$ sur $]0 ; +\infty[$. Sa dérivée est
$$g'(x) = -\frac{1}{x^2} + p = \frac{px^2 - 1}{x^2}.$$Elle est négative pour $x < \frac{1}{\sqrt{p}}$ et positive ensuite : $g$ atteint son minimum en $x = \frac{1}{\sqrt{p}}$, et ce minimum vaut
$$g\left(\frac{1}{\sqrt{p}}\right) = \sqrt{p} + \sqrt{p} = 2\sqrt{p}.$$Conclusion pratique. En choisissant des groupes d'environ $\frac{1}{\sqrt{p}}$ personnes, on fait au plus environ $2\sqrt{p}$ test par personne. Pour $p = 0{,}01$ : des groupes de $10$ et au plus $0{,}2$ test par personne (le tableur donne $k = 11$ et $0{,}196$). Pour une maladie touchant une personne sur mille, des groupes d'environ $32$ et au plus $0{,}063$ test par personne : plus de $93\,\%$ d'économie. Plus la maladie est rare, plus le groupement est rentable.
Si la maladie est fréquente, presque tous les mélanges sont positifs et le premier test est gaspillé. Cherchons le seuil exact.
Étape 1 : traduire la condition. Un groupe de $k$ est rentable si $f(k) < 1$, c'est-à-dire
$$\frac{1}{k} + 1 - q^k < 1 \iff q^k > \frac{1}{k}.$$Étape 2 : passer au logarithme. La fonction $\ln$ est strictement croissante, donc
$$\begin{aligned} q^k > \frac{1}{k} &\iff k \ln q > -\ln k \\ &\iff \ln q > -\frac{\ln k}{k}. \end{aligned}$$Étape 3 : le meilleur $k$ pour ce critère. Il existe un groupe rentable dès que la condition est vraie pour au moins un entier $k \geqslant 2$. La condition est la plus facile à satisfaire quand $\frac{\ln k}{k}$ est le plus grand possible. On étudie donc $h(x) = \dfrac{\ln x}{x}$ sur $[1 ; +\infty[$ :
$$h'(x) = \frac{\frac{1}{x} \times x - \ln x \times 1}{x^2} = \frac{1 - \ln x}{x^2}.$$La dérivée est positive pour $x < \mathrm{e}$ et négative pour $x > \mathrm{e}$ : $h$ est maximale en $x = \mathrm{e} \approx 2{,}718$. Pour les entiers, il suffit de comparer les deux voisins : $h(2) = \frac{\ln 2}{2} \approx 0{,}347$ et $h(3) = \frac{\ln 3}{3} \approx 0{,}366$. Le meilleur entier est donc $k = 3$.
Étape 4 : le seuil. Le groupement est rentable pour au moins une taille de groupe si et seulement si
$$\ln q > -\frac{\ln 3}{3} \iff q > 3^{-1/3} \approx 0{,}693,$$c'est-à-dire $p < 1 - 3^{-1/3} \approx 0{,}307$. Au-delà d'environ $31\,\%$ de personnes infectées, aucune taille de groupe ne fait mieux que tester tout le monde, et un peu en dessous du seuil le gain est minuscule (avec $p = 0{,}3$, le meilleur choix, $k = 3$, ne fait gagner qu'environ $1\,\%$ des tests).
L'espérance donne une moyenne : $296$ tests pour l'exemple des $1\,000$ recrues. Mais un laboratoire doit commander ses réactifs à l'avance, et il veut savoir si le nombre réel de tests risque de beaucoup s'écarter de cette moyenne.
Étape 1 : une loi binomiale. Notons $N$ le nombre de groupes positifs parmi les $200$. Chaque groupe est positif avec la même probabilité $\pi = 1 - 0{,}98^5 \approx 0{,}0961$, et les groupes sont indépendants puisqu'ils contiennent des personnes différentes. On répète donc $200$ fois la même épreuve de Bernoulli de façon indépendante : $N$ suit la loi binomiale $\mathcal{B}(200 ; \pi)$.
Étape 2 : espérance et variance.
$$E(N) = 200\,\pi \approx 19{,}2,$$ $$V(N) = 200\,\pi\,(1 - \pi) \approx 17{,}4.$$Le nombre total de tests est $200 + 5N$ : on retrouve $E(200 + 5N) = 200 + 5\,E(N) \approx 296$ par linéarité de l'espérance.
Étape 3 : Bienaymé-Tchebychev. L'inégalité donne, pour l'écart $\delta = 10$,
$$P\left(|N - E(N)| \geqslant 10\right) \leqslant \frac{V(N)}{10^2} \approx 0{,}17.$$Il y a donc au moins $83\,\%$ de chances que $N$ soit compris entre $10$ et $29$, c'est-à-dire que le nombre de tests soit compris entre $200 + 5 \times 10 = 250$ et $200 + 5 \times 29 = 345$. L'inégalité est prudente : le calcul exact avec la loi binomiale donne une probabilité d'environ $98\,\%$. On peut le vérifier par simulation.
Sur $200$ campagnes simulées, la moyenne est proche de $296$, et presque toutes les campagnes tombent entre $250$ et $345$ tests. Plus on simule de campagnes, plus il est probable que la moyenne observée soit proche de l'espérance $296$ : c'est la loi des grands nombres.
Au printemps 2020, la Covid-19 se répand et les laboratoires manquent de réactifs pour les tests PCR. L'idée de Dorfman revient immédiatement. En mars 2020, une équipe du Technion, en Israël, montre qu'un seul prélèvement positif peut être détecté dans un mélange qui en contient jusqu'à $32$. Des laboratoires allemands, américains et chinois utilisent ensuite des mélanges de quelques prélèvements. En juillet 2020, l'agence américaine du médicament autorise un test sur des mélanges de $4$ prélèvements. Selon les autorités chinoises, la campagne de dépistage de Wuhan, fin mai 2020, a porté sur une dizaine de millions d'habitants en quelques semaines, en mélangeant une partie des prélèvements. Les chiffres précis varient selon les sources : on les citera avec prudence.
Le calcul de la section précédente pousse à faire de très grands groupes quand la maladie est rare. La biologie l'interdit : mélanger $k$ prélèvements dilue celui qui est positif $k$ fois. Or la PCR détecte le virus en recopiant son matériel génétique : à chaque cycle, la quantité est (environ) doublée, et l'appareil donne un résultat positif quand un seuil est atteint. Le nombre de cycles nécessaires s'appelle le Ct.
Si la quantité de départ est divisée par $k$, il faut $c$ cycles de plus pour la rattraper, avec $2^c = k$, donc
$$c = \frac{\ln k}{\ln 2}.$$Un mélange de $8$ demande $3$ cycles de plus, un mélange de $32$ en demande $5$, et un mélange de $1\,024$ en demanderait $10$. Un prélèvement faiblement positif, qui donnait un résultat juste avant le nombre maximal de cycles de l'appareil, devient alors invisible : c'est un faux négatif. C'est pourquoi les groupes réellement utilisés restent petits, souvent entre $4$ et $10$ : le modèle mathématique doit composer avec une contrainte de laboratoire. Le logarithme explique au passage pourquoi la perte reste modeste pour des groupes moyens : doubler la taille du groupe ne coûte qu'un cycle de plus.
La méthode de Dorfman fait deux étapes : le mélange, puis tout le monde. On peut faire mieux, et les mathématiciens ont étudié de nombreuses variantes depuis 1943.
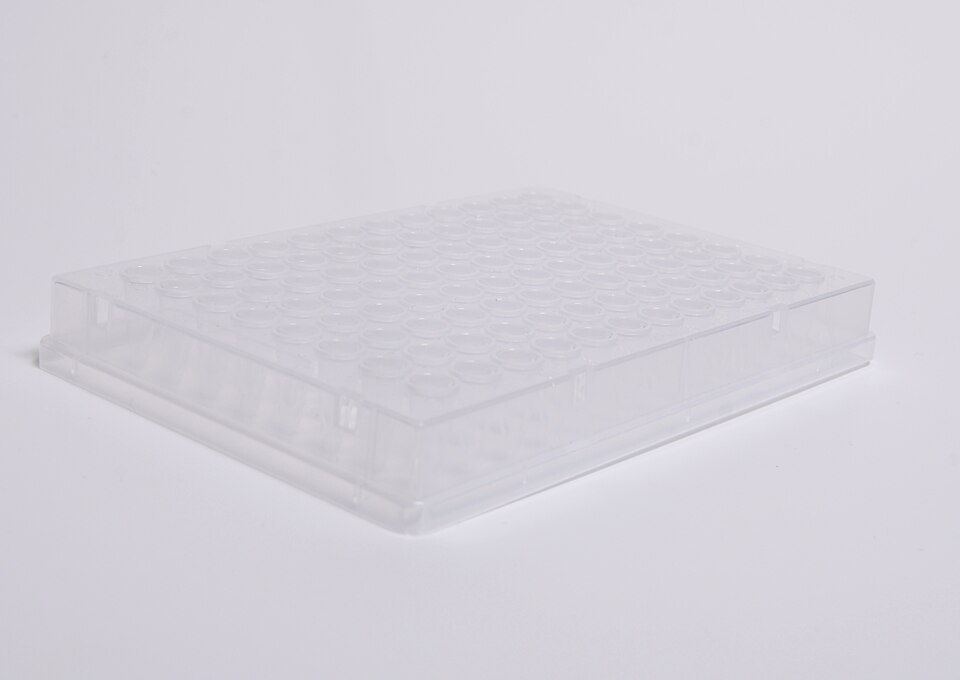
Les laboratoires rangent les prélèvements dans des plaques de $8 \times 12 = 96$ puits. On peut faire un mélange par ligne et un mélange par colonne : $8 + 12 = 20$ tests. Si un seul prélèvement est positif, une seule ligne et une seule colonne sont positives, et leur croisement désigne le malade, sans deuxième étape : $20$ tests pour $96$ personnes. S'il y a deux positifs dans des lignes et des colonnes différentes, deux lignes et deux colonnes s'allument, ce qui laisse $2 \times 2 = 4$ suspects à retester : un petit problème de dénombrement.
Si un groupe de $32$ contient un seul positif, on peut le retrouver en coupant le groupe en deux, en testant une moitié (si elle est négative, le positif est dans l'autre), puis en recommençant : $16$, $8$, $4$, $2$, $1$. Il faut $\log_2 32 = 5$ tests de plus, au lieu de $32$. C'est le même principe que la recherche dichotomique en algorithmique, et l'idée a été étudiée en 1959 par Milton Sobel et Phyllis Groll. Elle se heurte, elle aussi, au problème de la dilution.
Le groupement est entré dans la pratique ordinaire de la transfusion sanguine. Depuis la fin des années 1990, plusieurs pays, dont les États-Unis, recherchent le matériel génétique de virus comme le VIH ou celui de l'hépatite C dans les dons de sang en testant des mélanges de quelques dons (souvent de $6$ à $16$ selon les cas). Les virus recherchés sont rares chez les donneurs, ce qui est exactement la situation où la méthode est la plus rentable. D'autres pays testent les dons un par un, au prix d'un coût plus élevé, pour ne pas subir l'effet de la dilution : c'est un choix entre coût et sécurité.
Le modèle de Dorfman repose sur des hypothèses qu'il faut savoir critiquer :
- L'indépendance. Les membres d'une même famille ou d'un même foyer sont souvent infectés ensemble. Si on les regroupe, les positifs se concentrent dans quelques groupes : c'est en fait favorable, car il y a moins de groupes positifs que prévu. Mais le calcul de $q^k$ n'est plus valable.
- Le test parfait. Un vrai test a des faux positifs et des faux négatifs, et la dilution augmente les faux négatifs. Les raisonnements du texte Prendre des décisions avec les probabilités (formule de Bayes, sensibilité et spécificité) s'appliquent alors.
- La prévalence connue. Pour choisir $k$, il faut connaître $p$. Au début d'une épidémie, on l'ignore, et elle change d'une semaine à l'autre ; on l'estime alors avec un intervalle de confiance.
- Le temps. La deuxième étape retarde le résultat des personnes des groupes positifs, ce qui compte quand il faut isoler vite les malades.
Ce texte n'est pas un Grand Oral. Il rassemble des connaissances dans lesquelles chacun peut choisir une direction, la creuser et formuler sa propre question. Quelques directions possibles :
- Mathématiques : la loi et l'espérance du nombre de tests ; l'optimisation d'une taille de groupe par l'étude de fonction ; l'inégalité de Bernoulli démontrée par récurrence ; le seuil obtenu avec la fonction $\frac{\ln x}{x}$ ; la loi binomiale et l'inégalité de Bienaymé-Tchebychev ; la dichotomie.
- SVT : le dépistage d'une maladie, la PCR et la dilution, la sécurité transfusionnelle, la syphilis et son histoire, la Covid-19.
- SES : le coût d'une politique de santé publique, l'arbitrage entre coût, rapidité et sécurité, l'allocation d'une ressource rare (les réactifs) en temps de crise.
Le jury peut interroger sur les chapitres de spécialité mobilisés. Avec ce thème, il est utile de connaître parfaitement : les variables aléatoires, leur loi et leur espérance ; l'indépendance et la loi binomiale (espérance, variance) ; l'inégalité de Bienaymé-Tchebychev et la loi des grands nombres ; le raisonnement par récurrence ; la dérivation et l'étude des variations d'une fonction ; les fonctions exponentielle et logarithme ; les suites géométriques ; les boucles en Python.
Pour réviser ces chapitres, l'application Maths FlashBac reprend tout le cours de spécialité en cartes.
- Test groupé et Group testing (Wikipédia).
- Sur ce site : Prendre des décisions avec les probabilités, La modélisation des épidémies, La recherche opérationnelle et La planche de Galton.