← Tous les textes du Grand Oral
MathsSVTNSI
Les logiciels qui reconnaissent un visage, traduisent un texte ou répondent à une question s'appuient sur des « réseaux de neurones artificiels ». Le mot vient de la biologie : en 1943, deux chercheurs ont voulu décrire par des mathématiques ce que fait une cellule nerveuse. Mais que fait vraiment un neurone ? Qu'est-ce qu'un neurone « mathématique » ? Et que veut dire, pour une machine, « apprendre » ?
Ce texte part de ce que l'on étudie en SVT sur le message nerveux, construit pas à pas le neurone mathématique, et montre comment il apprend. Toutes les mathématiques utilisées restent dans le programme du lycée : équations de droites, fonction exponentielle, dérivation, suites géométriques. En NSI, on rencontre en première une autre méthode d'apprentissage automatique, l'algorithme des $k$ plus proches voisins ; les neurones artificiels ne sont pas au programme, mais les programmes Python de ce texte n'utilisent que des boucles et des tests. Il rassemble des connaissances ; à chacun d'y choisir une direction et d'y construire sa question.
- Le neurone biologique
- Le neurone de McCulloch et Pitts
- Une frontière qui est une droite
- Le perceptron apprend
- Ce qu'un neurone ne sait pas faire
- Une fonction plus douce : la sigmoïde
- Apprendre en descendant la pente
- Aujourd'hui, et les limites de la comparaison
- Des directions pour construire sa question
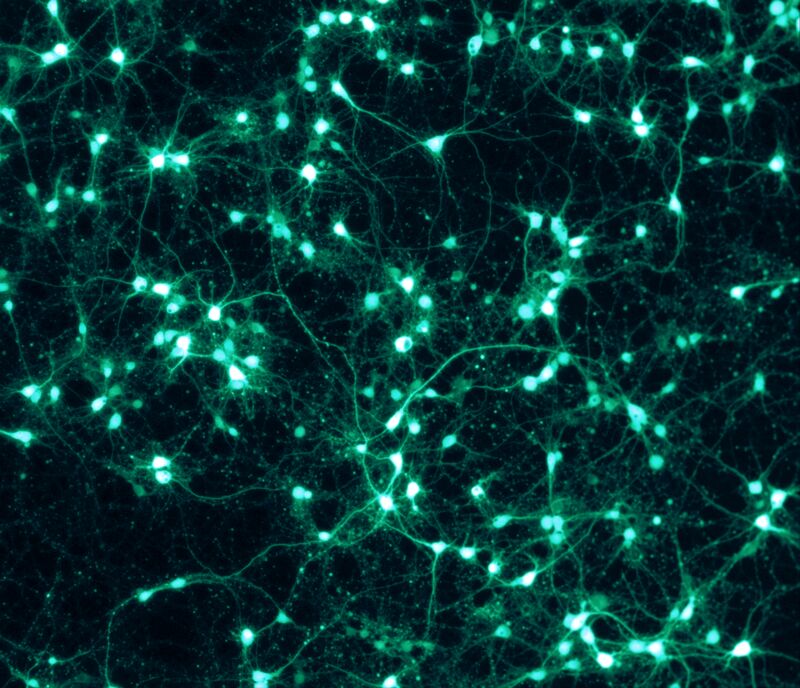
Le cerveau humain contient environ $86$ milliards de neurones, et chacun est relié à plusieurs milliers d'autres. Un neurone est une cellule, avec un noyau, mais de forme très particulière :
- les dendrites, de nombreux prolongements ramifiés, reçoivent les messages venus d'autres neurones ;
- le corps cellulaire, qui contient le noyau, rassemble ces messages ;
- l'axone, un prolongement unique qui peut mesurer de quelques millimètres à plus d'un mètre, transmet le message du neurone vers d'autres cellules ;
- les synapses sont les zones de contact entre l'extrémité de l'axone d'un neurone et un autre neurone.
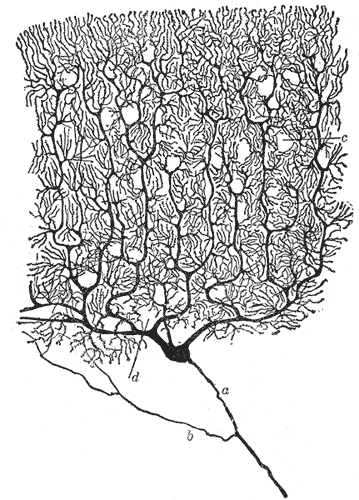
C'est l'Espagnol Santiago Ramón y Cajal (1852-1934) qui a montré, à la fin du XIXe siècle, que le système nerveux est fait de cellules séparées, les neurones, et non d'un réseau continu. Il a partagé le prix Nobel de médecine de 1906 avec l'Italien Camillo Golgi, dont la méthode de coloration lui avait permis de dessiner les neurones un par un.
Au repos, l'intérieur d'un neurone est chargé négativement par rapport à l'extérieur : la différence de potentiel électrique entre les deux côtés de la membrane, appelée potentiel de repos, vaut environ $-70$ millivolts (mV).
Quand le neurone est stimulé, ce potentiel peut augmenter. S'il dépasse un seuil, d'environ $-50$ mV, il se produit un événement brutal et bref : le potentiel monte jusqu'à environ $+30$ mV puis revient à sa valeur de repos, le tout en une à deux millisecondes. C'est le potentiel d'action. Il se propage ensuite le long de l'axone, à une vitesse de $1$ à $100$ mètres par seconde selon les fibres.
- Si le seuil n'est pas atteint, il ne se passe rien ; s'il est atteint, le potentiel d'action a toujours la même forme et la même hauteur. On dit qu'il obéit à la loi du tout ou rien.
- Comment le neurone transmet-il alors l'intensité d'une stimulation ? Par le nombre de potentiels d'action par seconde : une stimulation forte produit des potentiels d'action plus rapprochés. On parle de codage en fréquence.
Les mécanismes du potentiel d'action ont été décrits en 1952 par les Britanniques Alan Hodgkin et Andrew Huxley, à partir de mesures sur l'axone géant du calmar (épais d'environ un demi-millimètre, assez pour y glisser une électrode). Ils l'ont mis en équations, avec des équations différentielles, et ont reçu le prix Nobel en 1963.
À une synapse, le potentiel d'action qui arrive au bout de l'axone provoque la libération d'une molécule, le neurotransmetteur, qui se fixe sur le neurone suivant et modifie son potentiel. Il y a deux sortes de synapses :
- les synapses excitatrices rapprochent le potentiel du neurone suivant de son seuil (elles le font monter) ;
- les synapses inhibitrices l'en éloignent (elles le font descendre).
Un neurone reçoit en même temps des milliers de messages, excitateurs et inhibiteurs. Il en fait en quelque sorte la somme, au niveau du début de son axone : c'est l'intégration. Si le total dépasse le seuil, il émet à son tour des potentiels d'action ; sinon, il reste silencieux. Cette somme se fait de deux façons :
- sommation spatiale : des messages arrivés au même moment par des synapses différentes s'ajoutent ;
- sommation temporelle : des messages arrivés très rapprochés par la même synapse s'ajoutent.
Toutes les synapses n'ont pas le même effet : certaines sont plus « efficaces » que d'autres. Retenons ces trois idées, qui vont servir de modèle : chaque entrée a un poids, positif ou négatif ; le neurone fait la somme ; il compare cette somme à un seuil.
En 1949, le psychologue canadien Donald Hebb propose une idée qui va beaucoup compter : quand un neurone participe souvent à l'activation d'un autre, la synapse qui les relie se renforce. On la résume souvent par une formule anglaise : « neurons that fire together wire together » (les neurones qui s'activent ensemble se connectent ensemble). En 1973, Timothy Bliss et Terje Lømo observent effectivement, dans l'hippocampe du lapin, des synapses dont l'efficacité augmente durablement après avoir été très sollicitées. C'est l'une des bases de la plasticité cérébrale : le cerveau apprend en modifiant l'efficacité de ses connexions. C'est exactement l'idée que reprendront les neurones artificiels : apprendre, c'est modifier les poids.
En 1943, le neurologue américain Warren McCulloch et le jeune logicien Walter Pitts, âgé de vingt ans, publient un article qui propose un neurone « formel », c'est-à-dire réduit à une règle de calcul. Ils gardent du neurone biologique le tout ou rien, la somme et le seuil. Dans sa forme la plus simple, avec deux entrées :
- les entrées $x_1$ et $x_2$ valent $0$ ou $1$ (pas de message ou un message) ;
- chaque entrée a un poids, $w_1$ et $w_2$, un nombre réel : positif pour une synapse excitatrice, négatif pour une synapse inhibitrice ;
- le neurone calcule la somme pondérée à laquelle il ajoute un nombre $b$, appelé biais :
- la sortie $s$ vaut $1$ si $z > 0$, et $0$ sinon.
Le biais joue le rôle du seuil : dire que $z > 0$, c'est dire que $w_1x_1 + w_2x_2 > -b$. Le seuil est donc $-b$ : plus $b$ est négatif, plus il est difficile de déclencher le neurone.
| neurone biologique | neurone mathématique |
|---|---|
| messages reçus (ou non) | entrées $x_1$, $x_2$ valant $1$ ou $0$ |
| efficacité d'une synapse | poids $w_1$, $w_2$ |
| synapse excitatrice ou inhibitrice | poids positif ou négatif |
| sommation spatiale | somme $w_1x_1 + w_2x_2$ |
| seuil du potentiel d'action | seuil $-b$ |
| tout ou rien | sortie $1$ ou $0$ |
McCulloch et Pitts montrent que leurs neurones savent faire des opérations de logique. Prenons $w_1 = 1$, $w_2 = 1$ et $b = -1{,}5$. Calculons la sortie pour les quatre cas possibles :
| $x_1$ | $x_2$ | $z = x_1 + x_2 - 1{,}5$ | sortie $s$ |
|---|---|---|---|
| $0$ | $0$ | $-1{,}5$ | $0$ |
| $0$ | $1$ | $-0{,}5$ | $0$ |
| $1$ | $0$ | $-0{,}5$ | $0$ |
| $1$ | $1$ | $0{,}5$ | $1$ |
La sortie vaut $1$ seulement quand les deux entrées valent $1$ : ce neurone calcule « $x_1$ ET $x_2$ ». Le seuil $1{,}5$ est trop haut pour une seule entrée, mais il est dépassé par deux entrées ensemble.
Le OU. Gardons les poids $1$ et $1$ mais baissons le seuil : $b = -0{,}5$. Alors $z = x_1 + x_2 - 0{,}5$ : il vaut $-0{,}5$ quand les deux entrées sont nulles, et au moins $0{,}5$ dès qu'une entrée vaut $1$. La sortie vaut $1$ dès qu'au moins une entrée vaut $1$ : c'est « $x_1$ OU $x_2$ ».
Le NON. Avec une seule entrée, un poids négatif (une synapse inhibitrice) et un biais positif : $w_1 = -1$ et $b = 0{,}5$. Si $x_1 = 0$, $z = 0{,}5 > 0$ et la sortie vaut $1$ ; si $x_1 = 1$, $z = -0{,}5$ et la sortie vaut $0$. Le neurone renvoie le contraire de son entrée.
Avec ET, OU et NON, on peut construire n'importe quel calcul logique, donc, en principe, tout ce que fait un ordinateur. McCulloch et Pitts en concluaient qu'un réseau de neurones assez grand pouvait tout calculer. Mais il restait une question : dans leur modèle, c'est l'humain qui choisit les poids. Comment un réseau pourrait-il les trouver tout seul ?
Regardons le neurone autrement. Les deux entrées forment un point $M(x_1\,;x_2)$ du plan, et l'on peut d'ailleurs autoriser des entrées qui ne valent pas seulement $0$ ou $1$ : par exemple la taille et le poids d'un animal, ou deux mesures faites sur une image. Le neurone répond $1$ ou $0$ selon le point. Quels points donnent $1$ ?
Ce sont les points tels que $w_1x_1 + w_2x_2 + b > 0$. Or, en classe de première, on a vu que l'ensemble des points $M(x\,;y)$ tels que $ax + by + c = 0$, avec $a$ et $b$ non tous deux nuls, est une droite, dont le vecteur $\vec{n}(a\,;b)$ est un vecteur normal (orthogonal à la droite). Ici, l'équation $w_1x_1 + w_2x_2 + b = 0$ est donc celle d'une droite $\mathcal{D}$, de vecteur normal $\vec{n}(w_1\,;w_2)$.
- D'un côté de $\mathcal{D}$, l'expression $w_1x_1 + w_2x_2 + b$ est strictement positive : le neurone répond $1$. C'est le côté vers lequel pointe le vecteur normal.
- De l'autre côté (et sur la droite), elle est négative ou nulle : le neurone répond $0$.
Exemple : le neurone ET. La frontière a pour équation $x_1 + x_2 - 1{,}5 = 0$, c'est-à-dire $x_2 = -x_1 + 1{,}5$ : une droite de pente $-1$ qui coupe l'axe des ordonnées en $1{,}5$. Le point $(1\,;1)$ est au-dessus, les trois autres en dessous. Pour le OU, la droite est $x_2 = -x_1 + 0{,}5$ : seul le point $(0\,;0)$ est en dessous.
Un neurone découpe donc le plan en deux par une droite. On dit qu'il réalise une classification linéaire : il range chaque point dans l'une ou l'autre de deux catégories, selon le côté de la droite où il se trouve. « Apprendre » va consister à trouver une bonne droite, c'est-à-dire de bons nombres $w_1$, $w_2$ et $b$.
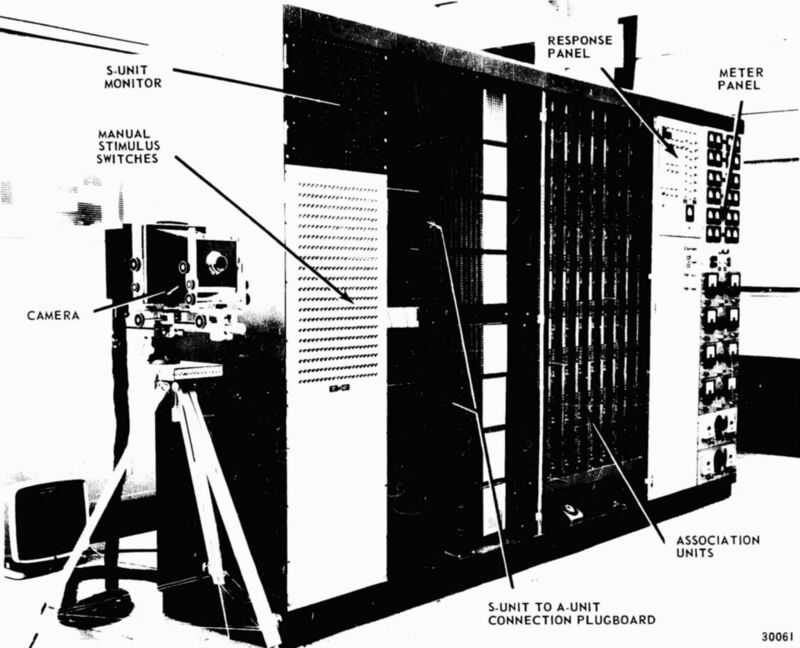
En 1958, le psychologue américain Frank Rosenblatt présente le perceptron : un neurone de McCulloch et Pitts qui trouve lui-même ses poids, à partir d'exemples. Il en construit une version électrique, le « Mark I Perceptron », reliée à une caméra de $20 \times 20 = 400$ cellules photoélectriques, capable d'apprendre à reconnaître des formes simples. Les poids y sont réglés par des potentiomètres que des moteurs électriques tournent pendant l'apprentissage. La presse de l'époque s'enthousiasme, parfois bien au-delà de ce que la machine savait faire.
On dispose d'exemples dont on connaît la bonne réponse $y$ ($0$ ou $1$). On part de poids quelconques, par exemple tous nuls, et l'on présente les exemples un par un. Pour chaque exemple $(x_1\,;x_2)$ :
- on calcule la sortie $s$ du neurone ;
- on calcule l'erreur $e = y - s$. Elle vaut $0$ si le neurone a bien répondu, $1$ s'il a répondu $0$ au lieu de $1$, et $-1$ s'il a répondu $1$ au lieu de $0$ ;
- on corrige les poids et le biais :
- $w_1 \leftarrow w_1 + e\,x_1$ ;
- $w_2 \leftarrow w_2 + e\,x_2$ ;
- $b \leftarrow b + e$.
(La flèche signifie « prend la nouvelle valeur ».) Si le neurone a bien répondu, $e = 0$ et rien ne change. On recommence avec tous les exemples, plusieurs fois, jusqu'à ce qu'il n'y ait plus d'erreur.
Supposons que le neurone ait répondu $0$ alors qu'il fallait $1$ : $z \leqslant 0$ et $e = 1$. Les nouveaux poids sont $w_1 + x_1$, $w_2 + x_2$ et $b + 1$. Recalculons la somme $z'$ pour le même exemple, terme par terme :
- $(w_1 + x_1)\,x_1 = w_1x_1 + x_1^2$ ;
- $(w_2 + x_2)\,x_2 = w_2x_2 + x_2^2$ ;
- le biais devient $b + 1$.
En additionnant, on retrouve $z = w_1x_1 + w_2x_2 + b$ et les termes en plus :
$$z' = z + x_1^2 + x_2^2 + 1.$$Comme $x_1^2 + x_2^2 + 1 \geqslant 1$, on a $z' \geqslant z + 1$ : la somme a augmenté d'au moins $1$, elle se rapproche de la zone où le neurone répond $1$. Dans le cas inverse ($e = -1$), le même calcul donne $z' = z - (x_1^2 + x_2^2 + 1)$ : la somme diminue. C'est l'idée de Hebb, transformée en calcul : on renforce ou on affaiblit les connexions selon le résultat.
Apprenons le OU au perceptron, à partir de $w_1 = w_2 = b = 0$. On présente les quatre exemples dans l'ordre, et l'on recommence. Chaque ligne donne les poids avant l'exemple, le calcul, et la correction. Les lignes où le neurone se trompe sont en rose.
| tour | $(x_1\,;x_2)$ | $y$ | $(w_1\,;w_2\,;b)$ | $z$ | $s$ | $e$ |
|---|---|---|---|---|---|---|
| 1 | $(0\,;0)$ | $0$ | $(0\,;0\,;0)$ | $0$ | $0$ | $0$ |
| 1 | $(0\,;1)$ | $1$ | $(0\,;0\,;0)$ | $0$ | $0$ | $1$ |
| 1 | $(1\,;0)$ | $1$ | $(0\,;1\,;1)$ | $1$ | $1$ | $0$ |
| 1 | $(1\,;1)$ | $1$ | $(0\,;1\,;1)$ | $2$ | $1$ | $0$ |
| 2 | $(0\,;0)$ | $0$ | $(0\,;1\,;1)$ | $1$ | $1$ | $-1$ |
| 2 | $(0\,;1)$ | $1$ | $(0\,;1\,;0)$ | $1$ | $1$ | $0$ |
| 2 | $(1\,;0)$ | $1$ | $(0\,;1\,;0)$ | $0$ | $0$ | $1$ |
| 2 | $(1\,;1)$ | $1$ | $(1\,;1\,;1)$ | $3$ | $1$ | $0$ |
| 3 | $(0\,;0)$ | $0$ | $(1\,;1\,;1)$ | $1$ | $1$ | $-1$ |
| 3 | $(0\,;1)$ | $1$ | $(1\,;1\,;0)$ | $1$ | $1$ | $0$ |
| 3 | $(1\,;0)$ | $1$ | $(1\,;1\,;0)$ | $1$ | $1$ | $0$ |
| 3 | $(1\,;1)$ | $1$ | $(1\,;1\,;0)$ | $2$ | $1$ | $0$ |
Détaillons la deuxième ligne : avec des poids nuls, $z = 0 \times 0 + 0 \times 1 + 0 = 0$, qui n'est pas strictement positif, donc $s = 0$, alors qu'il fallait $y = 1$ : $e = 1 - 0 = 1$. On corrige : $w_1 \leftarrow 0 + 1 \times 0 = 0$, $w_2 \leftarrow 0 + 1 \times 1 = 1$, $b \leftarrow 0 + 1 = 1$.
Au troisième tour, après la première ligne, plus aucune erreur : le perceptron a trouvé $w_1 = 1$, $w_2 = 1$ et $b = 0$, c'est-à-dire la sortie $1$ si $x_1 + x_2 > 0$. C'est bien le OU, avec d'autres nombres que ceux choisis plus haut : il y a beaucoup de droites qui conviennent, et l'apprentissage en a trouvé une.
Ça marche toujours ? Un théorème démontré au début des années 1960 (on l'admet ici) affirme que si une droite sépare parfaitement les exemples de réponse $1$ de ceux de réponse $0$, alors l'apprentissage s'arrête au bout d'un nombre fini de corrections, sur une droite qui les sépare. La figure suivante le montre sur des points placés au hasard.
Le OU exclusif (noté XOR en informatique) vaut $1$ quand une seule des deux entrées vaut $1$ : « fromage ou dessert », mais pas les deux.
| $x_1$ | $x_2$ | $x_1$ XOR $x_2$ |
|---|---|---|
| $0$ | $0$ | $0$ |
| $0$ | $1$ | $1$ |
| $1$ | $0$ | $1$ |
| $1$ | $1$ | $0$ |
Raisonnons par l'absurde : supposons qu'il existe des nombres $w_1$, $w_2$ et $b$ tels que le neurone calcule le OU exclusif. Traduisons chaque ligne du tableau par une inégalité.
- $(0\,;0)$ doit donner $0$ : $b \leqslant 0$.
- $(1\,;0)$ doit donner $1$ : $w_1 + b > 0$.
- $(0\,;1)$ doit donner $1$ : $w_2 + b > 0$.
- $(1\,;1)$ doit donner $0$ : $w_1 + w_2 + b \leqslant 0$.
Additionnons les deuxième et troisième inégalités : $w_1 + w_2 + 2b > 0$, c'est-à-dire $w_1 + w_2 + b > -b$. Or, d'après la première, $-b \geqslant 0$. Donc $w_1 + w_2 + b > 0$, ce qui contredit la quatrième inégalité.
La supposition de départ est donc fausse : aucun choix de $w_1$, $w_2$ et $b$ ne convient.
Géométriquement, c'est évident sur la figure ci-dessous : les points de réponse $1$, $(1\,;0)$ et $(0\,;1)$, sont sur une diagonale du carré, ceux de réponse $0$ sur l'autre ; aucune droite ne peut mettre les deux premiers d'un côté et les deux autres de l'autre.
En 1969, les Américains Marvin Minsky et Seymour Papert publient un livre, Perceptrons, qui démontre rigoureusement ce genre de limites. L'enthousiasme retombe, les financements aussi : c'est le début de ce qu'on a appelé le premier « hiver de l'intelligence artificielle ».
Ce qu'un neurone ne sait pas faire, trois neurones le peuvent, si on les branche les uns sur les autres. On remarque que « une seule entrée vaut $1$ » revient à « au moins une vaut $1$, mais pas les deux », c'est-à-dire « OU, et NON ET ».
- Un premier neurone calcule $h_1 = x_1$ OU $x_2$ (poids $1$ et $1$, biais $-0{,}5$).
- Un deuxième calcule $h_2 = x_1$ ET $x_2$ (poids $1$ et $1$, biais $-1{,}5$).
- Un troisième reçoit $h_1$ et $h_2$ et calcule $s$ : sa somme est $z = h_1 - h_2 - 0{,}5$ (poids $1$ et $-1$, biais $-0{,}5$).
| $x_1$ | $x_2$ | $h_1$ (OU) | $h_2$ (ET) | $z = h_1 - h_2 - 0{,}5$ | $s$ |
|---|---|---|---|---|---|
| $0$ | $0$ | $0$ | $0$ | $-0{,}5$ | $0$ |
| $0$ | $1$ | $1$ | $0$ | $0{,}5$ | $1$ |
| $1$ | $0$ | $1$ | $0$ | $0{,}5$ | $1$ |
| $1$ | $1$ | $1$ | $1$ | $-0{,}5$ | $0$ |
La sortie est bien le OU exclusif. Les neurones $h_1$ et $h_2$ forment une couche cachée, entre les entrées et la sortie. Géométriquement, chacun trace une droite, et le dernier neurone combine les deux : la zone de réponse $1$ est la bande comprise entre les deux droites.
Il restait un problème, que le perceptron ne résout pas : dans un réseau à plusieurs couches, comment savoir quels poids corriger quand la sortie est fausse ? La réponse passe par la dérivation.
La sortie du perceptron est donnée par une fonction en escalier : $0$ si $z \leqslant 0$, $1$ si $z > 0$. Cette fonction est constante par morceaux : sa dérivée est nulle partout (sauf en $0$, où elle n'est pas dérivable). Une petite modification d'un poids ne change donc presque jamais la sortie ; et quand elle la change, c'est d'un coup. Impossible de savoir dans quel sens modifier un poids pour améliorer « un peu » le résultat.
On remplace donc l'escalier par une fonction qui passe de $0$ à $1$ de façon continue et dérivable : la fonction sigmoïde, définie sur $\mathbb{R}$ par
$$\sigma(x) = \frac{1}{1 + \mathrm{e}^{-x}}.$$Elle a aussi un sens biologique : la fréquence des potentiels d'action d'un neurone augmente avec la stimulation, d'abord lentement, puis vite, puis elle plafonne, car un neurone ne peut pas émettre plus de quelques centaines de potentiels d'action par seconde. La sigmoïde a exactement cette allure, si l'on interprète $\sigma(x)$ comme une fréquence ramenée entre $0$ et $1$.
Limites. Quand $x$ tend vers $+\infty$, $-x$ tend vers $-\infty$ donc $\mathrm{e}^{-x}$ tend vers $0$ : par quotient, $\sigma(x)$ tend vers $\dfrac{1}{1+0} = 1$. Quand $x$ tend vers $-\infty$, $\mathrm{e}^{-x}$ tend vers $+\infty$, donc $1 + \mathrm{e}^{-x}$ aussi, et $\sigma(x)$ tend vers $0$. La courbe a deux asymptotes horizontales, d'équations $y = 0$ et $y = 1$.
Dérivée. Posons $u(x) = 1 + \mathrm{e}^{-x}$ : $u$ est dérivable, strictement positive, et $u'(x) = -\mathrm{e}^{-x}$. Comme $\sigma = \dfrac{1}{u}$, la formule $\left(\dfrac{1}{u}\right)' = -\dfrac{u'}{u^2}$ donne
$$\sigma'(x) = \frac{\mathrm{e}^{-x}}{\left(1 + \mathrm{e}^{-x}\right)^2}.$$Variations. Le numérateur et le dénominateur sont strictement positifs, donc $\sigma'(x) > 0$ : $\sigma$ est strictement croissante sur $\mathbb{R}$. Avec les limites, on en déduit que $0 < \sigma(x) < 1$ pour tout réel $x$.
Une formule remarquable. Calculons $1 - \sigma(x)$ :
$$1 - \sigma(x) = \frac{1 + \mathrm{e}^{-x} - 1}{1 + \mathrm{e}^{-x}} = \frac{\mathrm{e}^{-x}}{1 + \mathrm{e}^{-x}}.$$En multipliant par $\sigma(x) = \dfrac{1}{1 + \mathrm{e}^{-x}}$, on retrouve exactement $\sigma'(x)$ :
$$\sigma'(x) = \sigma(x)\big(1 - \sigma(x)\big).$$Cette formule permet de calculer la dérivée directement à partir de la valeur de $\sigma$, ce qui économise beaucoup de calculs dans un réseau. Par exemple, $\sigma(0) = \dfrac{1}{1 + 1} = \dfrac{1}{2}$ et $\sigma'(0) = \dfrac{1}{2} \times \dfrac{1}{2} = \dfrac{1}{4}$.
On peut aussi montrer que $\sigma(-x) = 1 - \sigma(x)$ (multiplier le numérateur et le dénominateur de $\sigma(-x)$ par $\mathrm{e}^{-x}$) : la courbe est symétrique par rapport au point $\left(0\,;\tfrac{1}{2}\right)$. Cette fonction n'est pas nouvelle : c'est la courbe de croissance d'une population limitée, étudiée par Verhulst en 1838 (voir le texte Les systèmes proies-prédateurs).
Apprendre, c'est rendre l'erreur la plus petite possible. Imaginons que l'erreur dépende d'un seul poids $w$ : c'est une fonction $E(w)$, et l'on cherche son minimum. Le cours de terminale dit comment savoir dans quel sens aller :
- si $E'(w) > 0$, la fonction est croissante autour de $w$ : pour diminuer l'erreur, il faut diminuer $w$ ;
- si $E'(w) < 0$, elle est décroissante : il faut augmenter $w$.
Dans les deux cas, on va dans le sens de $-E'(w)$. D'où la méthode de descente de gradient : on choisit un nombre $\eta > 0$ (la lettre grecque « êta »), appelé pas d'apprentissage, et l'on construit la suite
$$w_{n+1} = w_n - \eta\,E'(w_n).$$C'est l'image d'un randonneur dans le brouillard qui veut descendre au fond d'une vallée : il sent la pente sous ses pieds et fait un pas vers le bas, d'autant plus grand que la pente est forte.
Prenons $E(w) = (w - 3)^2 + 1$, dont le minimum est évidemment atteint en $w = 3$. On a $E'(w) = 2(w - 3)$, donc
$$w_{n+1} = w_n - 2\eta\,(w_n - 3).$$Posons $v_n = w_n - 3$ (l'écart au minimum). Alors
La suite $(v_n)$ est géométrique de raison $q = 1 - 2\eta$, donc $v_n = q^n v_0$. D'après le cours sur les suites géométriques, si $v_0 \neq 0$, $(v_n)$ tend vers $0$ si et seulement si $-1 < q < 1$, c'est-à-dire
$$-1 < 1 - 2\eta < 1 \iff 0 < \eta < 1.$$La méthode converge vers le minimum si et seulement si $0 < \eta < 1$.
| pas $\eta$ | raison $q = 1 - 2\eta$ | comportement de $w_n$ |
|---|---|---|
| $0{,}1$ | $0{,}8$ | s'approche de $3$, lentement |
| $0{,}25$ | $0{,}5$ | l'écart est divisé par $2$ à chaque pas |
| $0{,}5$ | $0$ | atteint $3$ en un seul pas |
| $0{,}75$ | $-0{,}5$ | s'approche de $3$ en sautant d'un côté à l'autre |
| $1{,}5$ | $-2$ | s'éloigne de plus en plus : la méthode diverge |
C'est une leçon générale : un pas trop petit rend l'apprentissage lent, un pas trop grand le rend instable. Le choix de $\eta$ est l'un des réglages délicats des réseaux de neurones.
Prenons maintenant un neurone avec une seule entrée, qui vaut toujours $1$, un poids $w$ et la sigmoïde en sortie : sa sortie est $\sigma(w)$. On veut qu'il réponde $0{,}9$. On mesure l'erreur par le carré de l'écart :
$$E(w) = \big(\sigma(w) - 0{,}9\big)^2.$$La dérivée. La fonction $E$ est de la forme $u^2$ avec $u(w) = \sigma(w) - 0{,}9$, et $(u^2)' = 2u\,u'$. Avec la formule $\sigma' = \sigma(1 - \sigma)$ :
$$E'(w) = 2\big(\sigma(w) - 0{,}9\big)\,\sigma(w)\big(1 - \sigma(w)\big).$$Le minimum exact. Comme $\sigma(w)\big(1 - \sigma(w)\big) > 0$, $E'(w)$ a le signe de $\sigma(w) - 0{,}9$. Il s'annule quand $\sigma(w) = 0{,}9$. Résolvons cette équation, qui s'écrit $\dfrac{1}{1 + \mathrm{e}^{-w}} = 0{,}9$ :
- en prenant l'inverse des deux membres : $1 + \mathrm{e}^{-w} = \dfrac{10}{9}$ ;
- en retranchant $1$ : $\mathrm{e}^{-w} = \dfrac{1}{9}$ ;
- en appliquant le logarithme : $-w = \ln\dfrac{1}{9} = -\ln 9$, donc $w = \ln 9 \approx 2{,}197$.
$E$ est décroissante puis croissante, et son minimum, $0$, est atteint en $w = \ln 9$. Ici, on sait trouver la réponse par le calcul ; dans un vrai réseau, avec des millions de poids, on ne le sait pas, d'où la descente de gradient.
La descente, à la main. Partons de $w_0 = 0$ avec un pas $\eta = 5$.
- $\sigma(0) = 0{,}5$, donc $\sigma(0)\big(1 - \sigma(0)\big) = 0{,}25$ et $E'(0) = 2 \times (-0{,}4) \times 0{,}25 = -0{,}2$.
- $w_1 = 0 - 5 \times (-0{,}2) = 1$. Puis $\sigma(1) \approx 0{,}731$ : la sortie s'est rapprochée de $0{,}9$.
- $\sigma(1)\big(1 - \sigma(1)\big) \approx 0{,}197$, donc $E'(1) \approx 2 \times (-0{,}169) \times 0{,}197$, soit $E'(1) \approx -0{,}066$.
- $w_2 \approx 1 + 5 \times 0{,}066 \approx 1{,}332$, et $\sigma(w_2) \approx 0{,}791$.
| $n$ | $0$ | $1$ | $2$ | $3$ | $5$ | $10$ |
|---|---|---|---|---|---|---|
| $w_n$ | $0$ | $1$ | $1{,}332$ | $1{,}512$ | $1{,}718$ | $1{,}951$ |
| $\sigma(w_n)$ | $0{,}5$ | $0{,}731$ | $0{,}791$ | $0{,}819$ | $0{,}848$ | $0{,}876$ |
La sortie se rapproche de $0{,}9$ à chaque pas, de plus en plus lentement, car la pente diminue près du minimum.
Dans un vrai réseau, l'erreur dépend de tous les poids à la fois. On applique la même idée à chaque poids séparément : on regarde comment l'erreur varie quand on ne modifie que ce poids-là, en gardant les autres fixes, et l'on fait un petit pas dans le sens qui la fait diminuer. Le calcul de toutes ces dérivées utilise sans cesse la dérivée d'une fonction composée, comme pour $E'(w)$ : on part de l'erreur en sortie et l'on remonte couche par couche vers les entrées. Cette méthode, la rétropropagation du gradient, a été popularisée en 1986 par David Rumelhart, Geoffrey Hinton et Ronald Williams. Elle a relancé les réseaux de neurones : elle permet d'entraîner des réseaux à plusieurs couches, et donc de dépasser les limites du perceptron.
Dans les années 1990, le Français Yann LeCun met au point des réseaux capables de lire les chiffres écrits à la main : ils ont été utilisés pour lire automatiquement les montants des chèques. À partir des années 2010, grâce à la puissance des processeurs graphiques et à d'immenses quantités de données, les réseaux « profonds », à très nombreuses couches, s'imposent en reconnaissance d'images, en traduction, en reconnaissance de la parole. En 2024, le prix Nobel de physique est attribué à John Hopfield et Geoffrey Hinton pour leurs travaux fondateurs sur l'apprentissage par réseaux de neurones artificiels.
Le principe de base n'a pas changé depuis le perceptron : des sommes pondérées, une fonction qui décide de la sortie, et des poids corrigés pour diminuer l'erreur. Ce qui a changé, c'est le nombre de neurones et de couches, et la quantité d'exemples.
Le neurone mathématique est une modélisation : il garde quelques traits du neurone biologique et laisse tout le reste de côté. Il ne faut pas confondre le modèle et la réalité.
- Le temps. Un vrai neurone émet des potentiels d'action à des instants précis, et le moment où ils arrivent compte (sommation temporelle). Le neurone formel calcule d'un coup, sans notion de temps.
- La complexité de la cellule. Les dendrites ne se contentent pas d'additionner : elles effectuent elles-mêmes des calculs. Les neurotransmetteurs sont nombreux et d'effets variés, et d'autres cellules du cerveau, les cellules gliales, participent à son fonctionnement.
- L'apprentissage. On ne sait pas si le cerveau fait quoi que ce soit qui ressemble à la rétropropagation. Un enfant reconnaît un chat après en avoir vu quelques-uns ; un réseau artificiel a besoin de milliers d'exemples.
- L'énergie. Le cerveau humain consomme environ $20$ watts, à peu près autant qu'une petite ampoule ; l'entraînement des grands réseaux artificiels consomme énormément plus d'électricité.
Les neurones artificiels se sont inspirés du cerveau, mais ils ont surtout évolué comme des outils mathématiques et informatiques. Ils servent aussi en retour aux neurosciences, comme modèles simplifiés à comparer aux mesures.
Ce programme applique la règle du perceptron aux tableaux du OU, du ET et du OU exclusif, et affiche, à chaque tour, le nombre d'erreurs et les poids. Pour le OU et le ET, les erreurs tombent à $0$ ; pour le OU exclusif, elles ne disparaissent jamais, comme le prévoit la démonstration.
Ce texte n'est pas un Grand Oral. Il rassemble des connaissances dans lesquelles chacun peut choisir une direction, la creuser et formuler sa propre question. Quelques directions possibles :
- Mathématiques : la droite frontière et son vecteur normal ; la règle du perceptron et pourquoi elle corrige dans le bon sens ; l'impossibilité du OU exclusif par l'absurde ; l'étude de la sigmoïde ; la descente de gradient comme suite récurrente, et sa convergence.
- SVT : le potentiel d'action et le tout ou rien, le codage en fréquence, les synapses excitatrices et inhibitrices, l'intégration, la plasticité cérébrale, et ce que le modèle laisse de côté.
- NSI : programmer le perceptron, comparer avec l'algorithme des $k$ plus proches voisins, la place des données dans l'apprentissage automatique.
Le jury peut interroger sur les chapitres de spécialité mobilisés. Avec ce thème, il est utile de connaître parfaitement : les équations cartésiennes de droites et le vecteur normal (première) ; la fonction exponentielle, ses limites et sa dérivée ; la dérivation (quotient, $\dfrac{1}{u}$, $u^2$, fonction composée) et le lien entre signe de la dérivée et variations ; la fonction logarithme ; les suites géométriques et leur limite ; le raisonnement par l'absurde.
Pour réviser ces chapitres, l'application Maths FlashBac reprend tout le cours de spécialité en cartes.
- Neurone formel, perceptron et potentiel d'action (Wikipédia).
- W. McCulloch et W. Pitts, « A logical calculus of the ideas immanent in nervous activity », Bulletin of Mathematical Biophysics, 1943.
- Sur ce site : Les algorithmes génétiques (une autre façon d'apprendre par essais) et Les systèmes proies-prédateurs.