← Tous les textes du Grand Oral
MathsSVTNSI
Beaucoup de problèmes consistent à chercher la meilleure solution parmi un très grand nombre de solutions possibles : le trajet le plus court pour un livreur qui doit passer chez cinquante clients, la forme d'antenne qui capte le mieux un signal, l'emploi du temps d'un lycée qui respecte le plus de contraintes. On dit que ce sont des problèmes d'optimisation. Quand les solutions possibles se comptent par milliards de milliards, on ne peut pas toutes les essayer, même avec un ordinateur.
Les algorithmes génétiques sont une façon de s'y prendre qui imite l'évolution des êtres vivants. L'idée, en une phrase : on part de solutions prises au hasard, on garde les meilleures, on les mélange et on les modifie un peu, et l'on recommence, génération après génération. Ce texte explique, étape par étape, d'où vient cette idée en biologie, pourquoi elle fonctionne, et quelles mathématiques permettent de la comprendre : le dénombrement, les probabilités, la loi binomiale, les fonctions. Il rassemble ces connaissances ; à chacun d'y choisir une direction et d'y construire sa question.
En 1859, dans L'Origine des espèces, Charles Darwin explique comment les espèces se transforment au cours du temps. Prenons l'exemple classique de la phalène du bouleau, un papillon de nuit d'Angleterre, qui se repose le jour sur les troncs d'arbres.
- La variation. Dans une population de phalènes, tous les individus ne sont pas identiques : la plupart sont clairs, quelques-uns sont foncés.
- L'hérédité. La couleur se transmet en grande partie des parents aux descendants : elle dépend des gènes.
- La sélection. Au XIXe siècle, la pollution des usines noircit les troncs. Sur un tronc noir, les papillons clairs se voient bien et sont davantage mangés par les oiseaux ; les foncés, mieux camouflés, survivent plus souvent et ont plus de descendants.
- Le résultat. Génération après génération, la proportion de papillons foncés augmente. Dans les régions industrielles, ils sont devenus largement majoritaires ; quand la pollution a diminué, au XXe siècle, les papillons clairs sont redevenus les plus nombreux.
Personne n'a « choisi » la couleur foncée : elle s'est répandue parce que ceux qui la portaient survivaient mieux dans ce milieu. Un algorithme génétique reprend exactement ces trois ingrédients : une population de solutions variées, une façon de les « reproduire » en transmettant leurs caractéristiques (hérédité), et une note qui favorise les meilleures (sélection). Cette note s'appelle l'adaptation.
Pour que la sélection ait de quoi choisir, il faut que les individus soient différents. Cette diversité a deux sources, étudiées en SVT.
Les mutations. L'ADN est une très longue molécule qui porte l'information génétique. Quand une cellule le recopie, il arrive, rarement, qu'une erreur se produise : c'est une mutation. La plupart sont sans effet ou défavorables ; quelques-unes sont favorables.
Le brassage génétique. Chez l'être humain, l'ADN est réparti en $46$ chromosomes, rangés par paires : $23$ paires, dans chaque paire un chromosome venu de la mère et un venu du père. Pour fabriquer un gamète (un spermatozoïde ou un ovule), la cellule ne garde qu'un chromosome de chaque paire : c'est la méiose. Le choix se fait au hasard, et c'est un problème de dénombrement.
- Avec une seule paire, notée (M1, P1) pour « venu de la mère » et « venu du père », il y a $2$ gamètes possibles : M1 ou P1.
- Avec deux paires, pour chacun des $2$ choix de la première paire, il y a $2$ choix pour la seconde : $2 \times 2 = 4$ gamètes, M1M2, M1P2, P1M2 et P1P2.
- Avec trois paires : $2 \times 2 \times 2 = 2^3 = 8$ gamètes (le tableau ci-dessous les énumère).
- Avec $23$ paires, par le même raisonnement (le principe multiplicatif) : $2^{23} = 8\,388\,608$ gamètes possibles.
| paire 1 | M | M | M | M | P | P | P | P |
|---|---|---|---|---|---|---|---|---|
| paire 2 | M | M | P | P | M | M | P | P |
| paire 3 | M | P | M | P | M | P | M | P |
C'est le brassage interchromosomique. S'y ajoute le brassage intrachromosomique : pendant la méiose, les deux chromosomes d'une même paire peuvent se croiser et échanger des morceaux. C'est le crossing-over : le chromosome obtenu est fait d'un morceau du chromosome maternel et d'un morceau du chromosome paternel, une combinaison qui n'existait pas avant. Enfin, à la fécondation, un gamète du père rencontre un gamète de la mère : rien qu'avec le brassage interchromosomique, un couple peut produire $2^{23} \times 2^{23} = 2^{46} \approx 7 \times 10^{13}$ enfants génétiquement différents.
Les informaticiens ont repris les mots de la biologie. Le tableau suivant les met en correspondance.
| en biologie | dans l'algorithme |
|---|---|
| un individu | une solution possible du problème |
| son ADN, ses chromosomes | le codage de cette solution (une suite de lettres, de chiffres…) |
| un gène | un élément de ce codage |
| la population | l'ensemble des solutions étudiées à un moment donné |
| la survie dans le milieu | une note, l'adaptation, qui dit si la solution est bonne |
| une génération | une étape de l'algorithme |
| la mutation | une petite modification au hasard |
| le crossing-over | le croisement : deux solutions échangent des morceaux |
Une différence essentielle. L'évolution des êtres vivants n'a pas de but : aucune espèce n'évolue « vers » une forme idéale, et ce qui est favorable dépend du milieu, qui change (la phalène l'a montré). L'algorithme génétique, lui, est écrit pour atteindre un objectif fixé par le programmeur : c'est une imitation de quelques mécanismes de l'évolution, pas une simulation de l'évolution.
Une objection revient souvent contre la théorie de Darwin : un organe aussi compliqué que l'œil ne peut pas être apparu « par hasard », pas plus qu'un singe tapant au hasard sur une machine à écrire ne peut écrire une pièce de Shakespeare. En 1986, dans son livre L'Horloger aveugle, le biologiste britannique Richard Dawkins répond avec une expérience sur ordinateur. Il est d'accord avec la première partie : le hasard seul ne peut pas produire quelque chose de complexe. Mais il montre que la sélection naturelle n'est pas le hasard seul.
Il prend une phrase de Hamlet, de Shakespeare : METHINKS IT IS LIKE A WEASEL (« je crois que ça ressemble à une belette »). Elle s'écrit avec $27$ symboles possibles : les $26$ lettres majuscules et l'espace. En comptant les espaces, elle a $28$ caractères : $8$ pour METHINKS, $1$ espace, $2$ pour IT, $1$ espace, $2$ pour IS, $1$ espace, $4$ pour LIKE, $1$ espace, $1$ pour A, $1$ espace et $6$ pour WEASEL. Le jeu consiste à obtenir cette phrase en partant de caractères tirés au hasard. Dawkins compare deux méthodes.
On tire au hasard les $28$ caractères, d'un seul coup, et l'on regarde si l'on a obtenu la phrase. Si ce n'est pas le cas, on recommence tout. Quelle est la probabilité de réussir ? Pour le savoir, il faut compter combien de suites de $28$ caractères existent. Commençons petit.
- Avec un caractère, il y a $27$ possibilités : A, B, …, Z ou l'espace.
- Avec deux caractères, pour chacun des $27$ choix du premier, il y a $27$ choix du second : AA, AB, …, BA, BB… soit $27 \times 27 = 27^2 = 729$ possibilités.
- Avec quatre caractères, comme dans le mot CHAT : $27^4 = 531\,441$ possibilités.
- Avec $28$ caractères : $27^{28}$ possibilités, environ $1{,}2 \times 10^{40}$, c'est-à-dire $12$ suivi de $39$ zéros.
Toutes ces suites ont la même probabilité d'être tirées, donc la probabilité d'obtenir la phrase en un tirage est
$$p = \frac{1}{27^{28}} \approx 8 \times 10^{-41}.$$Pour se rendre compte de la taille de ces nombres : un ordinateur qui écrirait un milliard de suites par seconde mettrait environ $3{,}8 \times 10^{23}$ ans pour écrire une fois chacune des $27^{28}$ suites, soit environ $27\,000$ milliards de fois l'âge de l'Univers.
Et si l'on fait beaucoup d'essais ? Faisons $N$ tirages indépendants. On cherche la probabilité d'obtenir la phrase au moins une fois. Il est plus simple de passer par l'événement contraire, « ne jamais l'obtenir » : à chaque tirage, on échoue avec la probabilité $1 - p$, et, les tirages étant indépendants, on échoue $N$ fois de suite avec la probabilité $(1-p)^N$. Donc
$$P(\text{réussir au moins une fois}) = 1 - (1-p)^N.$$Ce nombre est impossible à calculer directement à la calculatrice : $p$ est si petit que la machine arrondit $1 - p$ à $1$. On le majore grâce à une inégalité classique, que l'on démontre par récurrence.
Soit un réel $x \geqslant -1$. Pour tout entier naturel $N$, notons $\mathcal{P}(N)$ la propriété « $(1+x)^N \geqslant 1 + Nx$ ».
Initialisation. Pour $N = 0$, $(1+x)^0 = 1$ et $1 + 0 \times x = 1$ : l'inégalité $1 \geqslant 1$ est vraie.
Hérédité. Soit un entier naturel $N$ tel que $\mathcal{P}(N)$ est vraie, c'est-à-dire $(1+x)^N \geqslant 1 + Nx$. Comme $x \geqslant -1$, le nombre $1 + x$ est positif ou nul : on peut multiplier les deux membres de l'inégalité par $1 + x$ sans changer son sens. On obtient
$$(1+x)^{N+1} \geqslant (1 + Nx)(1 + x).$$On développe le membre de droite : $(1 + Nx)(1 + x) = 1 + x + Nx + Nx^2$, c'est-à-dire $1 + (N+1)x + Nx^2$. Comme $Nx^2$ est positif ou nul, ce nombre est supérieur ou égal à $1 + (N+1)x$. Finalement
$$(1+x)^{N+1} \geqslant 1 + (N+1)x,$$ce qui est la propriété $\mathcal{P}(N+1)$.
Conclusion. La propriété est vraie pour $N = 0$ et héréditaire : elle est vraie pour tout entier naturel $N$.
Appliquons-la avec $x = -p$ (qui est bien supérieur à $-1$) : $(1-p)^N \geqslant 1 - Np$, donc
$$P(\text{réussir au moins une fois}) = 1 - (1-p)^N \leqslant Np.$$Avec un milliard de milliards d'essais, $N = 10^{18}$, la probabilité de réussir au moins une fois est donc au plus $10^{18} \times 8 \times 10^{-41} = 8 \times 10^{-23}$ : c'est pratiquement impossible. Le hasard pur ne produit pas la phrase.
La deuxième méthode imite la sélection naturelle. Elle suit ces étapes.
- Départ. On tire au hasard une suite de $28$ caractères. C'est la « génération $0$ ».
- Reproduction avec erreurs (mutations). On fait $100$ copies de cette suite. En recopiant, on se trompe parfois : chaque caractère de chaque copie a $4\,\%$ de chances d'être remplacé par un caractère tiré au hasard.
- Note (adaptation). On donne à chaque copie une note : le nombre de caractères qui sont à la bonne place, comparés à la phrase visée. La note va de $0$ à $28$.
- Sélection. On garde la copie qui a la meilleure note, et l'on jette les autres.
- Recommencer. La copie gardée devient la génération suivante, et l'on revient à l'étape 2, jusqu'à obtenir la phrase.
Un exemple à la main, sur un mot court. Pour bien comprendre, prenons comme objectif le mot CHAT, et seulement $3$ copies par génération (les tirages ci-dessous sont un exemple imaginé). La note est le nombre de lettres à la bonne place.
| génération | suite gardée | note | copies obtenues (note) |
|---|---|---|---|
| $0$ | XQAZ | $1$ | XHAZ ($2$), XQAZ ($1$), KQAB ($1$) |
| $1$ | XHAZ | $2$ | XHAZ ($2$), CHAZ ($3$), XHUZ ($1$) |
| $2$ | CHAZ | $3$ | CHAZ ($3$), CHAZ ($3$), CMAZ ($2$) |
| $3$ | CHAZ | $3$ | CHAT ($4$), CHAZ ($3$), CHQZ ($2$) |
| $4$ | CHAT | $4$ | objectif atteint |
Au départ, seul le A est bien placé. À la génération $0$, une copie a reçu par hasard un H à la deuxième place : elle a la meilleure note, on la garde. À la génération $1$, une copie a reçu un C à la première place. À la génération $2$, aucune copie n'est meilleure : on garde une copie de même note. À la génération $3$, une copie obtient le T. Chaque lettre correcte, une fois trouvée, est conservée, parce que les copies qui la perdraient ont une moins bonne note et sont éliminées. C'est ce que Dawkins appelle la sélection cumulative : les améliorations s'additionnent d'une génération à l'autre, au lieu d'être tirées toutes ensemble d'un seul coup.
Pourquoi c'est beaucoup plus rapide : un ordre de grandeur. Revenons à la phrase de $28$ caractères, avec $100$ copies et $4\,\%$ de mutations.
- Pour qu'un caractère faux devienne juste dans une copie, il faut qu'il mute (probabilité $0{,}04$) et que le caractère tiré soit le bon (probabilité $\frac{1}{27}$) : par indépendance, $0{,}04 \times \frac{1}{27} \approx 0{,}0015$.
- Au début, presque tous les caractères sont faux : environ $27$. Une copie a donc environ $27 \times 0{,}0015 \approx 0{,}04$ de chances d'en corriger un. Parmi $100$ copies, la probabilité qu'aucune n'en corrige est environ $0{,}96^{100} \approx 0{,}017$ : presque à chaque génération, une copie gagne une lettre.
- À la fin, il ne reste qu'un caractère faux. Une copie le corrige avec la probabilité $0{,}0015$, mais il faut aussi qu'elle ne casse aucun des $27$ caractères justes, ce qui arrive avec la probabilité $0{,}96^{27} \approx 0{,}33$. Une copie réussit donc avec une probabilité d'environ $0{,}0005$, et au moins une des $100$ copies réussit avec une probabilité d'environ $0{,}05$ : il faut en général une vingtaine de générations pour trouver la dernière lettre.
Au total, la phrase est obtenue en quelques dizaines à une centaine de générations, soit quelques milliers de copies, au lieu des $10^{40}$ essais du hasard pur. La figure permet de le vérifier : on peut laisser tourner l'expérience ou avancer génération par génération.
Ce que l'expérience montre, et ce qu'elle ne montre pas. Elle montre la puissance d'une sélection qui s'accumule petit à petit, comparée à un tirage unique au hasard. Dawkins prévient lui-même qu'elle est trompeuse sur un point : elle a un but, la phrase visée, alors que la sélection naturelle ne vise rien ; elle favorise simplement ce qui survit et se reproduit le mieux dans un milieu donné. C'est justement ce but que les algorithmes génétiques exploitent : en optimisation, on veut atteindre un objectif.
Dans l'expérience de Dawkins, on ne garde qu'une copie à chaque génération, et il n'y a pas de croisement. Un vrai algorithme génétique travaille avec une population de plusieurs solutions et utilise trois opérations. Pour les présenter, prenons un petit exemple : chaque individu est une suite de $8$ chiffres $0$ ou $1$, et sa note est un nombre positif calculé à partir de ces chiffres (peu importe comment pour l'instant).
On veut choisir des « parents » pour la génération suivante, en favorisant les individus qui ont une bonne note, sans pour autant éliminer tous les autres (ils peuvent porter de bons morceaux de solution). La méthode de la roulette donne à chaque individu une chance proportionnelle à sa note.
Supposons une population de quatre individus A, B, C, D, de notes $1$, $2$, $3$ et $4$. La somme des notes est $1 + 2 + 3 + 4 = 10$. On imagine une roue de loterie partagée en secteurs, chacun d'autant plus grand que la note est grande : A occupe $\frac{1}{10}$ de la roue, B $\frac{2}{10}$, C $\frac{3}{10}$ et D $\frac{4}{10}$. On fait tourner la roue : l'individu sur lequel elle s'arrête est choisi. En général, si les individus ont pour notes $a_1$, $a_2$, …, $a_n$, l'individu numéro $i$ est choisi avec la probabilité
$$p_i = \frac{a_i}{a_1 + a_2 + \cdots + a_n}.$$Ces nombres sont bien des probabilités : ils sont positifs, et leur somme vaut $1$ car on divise la somme des notes par elle-même. Dans l'exemple, D, le meilleur, est choisi $4$ fois sur $10$ en moyenne, mais A, le moins bon, garde une chance sur dix.
Comment un ordinateur fait-il tourner la roue ? Il tire un nombre $r$ au hasard dans $[0\,;10[$ (la somme des notes) et regarde dans quel intervalle il tombe : $[0\,;1[$ pour A, $[1\,;3[$ pour B, $[3\,;6[$ pour C, $[6\,;10[$ pour D. Par exemple, si $r = 4{,}7$, c'est C qui est choisi.
On prend deux parents choisis par la roulette. On choisit au hasard un endroit où couper leurs suites de chiffres, le même pour les deux, et on échange les morceaux situés après la coupure. Dans l'exemple suivant, on coupe après le quatrième chiffre :
| parent 1 | 1 0 1 1 | 0 0 1 0 |
| parent 2 | 0 1 1 0 | 1 1 0 1 |
| enfant 1 | 1 0 1 1 | 1 1 0 1 |
| enfant 2 | 0 1 1 0 | 0 0 1 0 |
Chaque enfant reçoit le début de l'un des parents et la fin de l'autre : c'est l'équivalent du crossing-over. L'intérêt est que deux parents qui ont chacun une « bonne moitié » peuvent donner un enfant qui réunit les deux. Pour une suite de $L$ chiffres, il y a $L - 1$ endroits possibles pour couper (entre le 1er et le 2e chiffre, …, entre l'avant-dernier et le dernier) : ici $8 - 1 = 7$.
Enfin, chaque chiffre de chaque enfant peut être modifié (un $0$ devient $1$, un $1$ devient $0$) avec une petite probabilité, notée $\mu$ (la lettre grecque « mu »), indépendamment des autres. La mutation apporte de la nouveauté : sans elle, la population ne pourrait jamais contenir un chiffre qu'aucun individu de départ ne possédait à cet endroit.
Prenons un individu de $L$ chiffres et notons $M$ le nombre de chiffres qui mutent. Pour chaque chiffre, on se pose la question « ce chiffre mute-t-il ? » : c'est une épreuve à deux issues (une épreuve de Bernoulli) dont le succès, « il mute », a la probabilité $\mu$. On répète cette épreuve $L$ fois, une fois par chiffre, de façon indépendante : c'est un schéma de Bernoulli. Le nombre de succès $M$ suit donc la loi binomiale de paramètres $L$ et $\mu$ : pour tout entier $k$ de $0$ à $L$,
$$P(M = k) = \tbinom{L}{k}\,\mu^k(1-\mu)^{L-k}.$$Son espérance (le nombre moyen de mutations) est $E(M) = L\mu$. La probabilité qu'aucun chiffre ne mute s'obtient avec $k = 0$ : $P(M = 0) = (1-\mu)^L$.
Application numérique avec $L = 100$ chiffres et $\mu = 0{,}01$ :
- $E(M) = 100 \times 0{,}01 = 1$ : une mutation en moyenne par individu ;
- $P(M = 0) = 0{,}99^{100} \approx 0{,}366$ : environ un individu sur trois n'est pas modifié ;
- $P(M = 1) = 100 \times 0{,}01 \times 0{,}99^{99} \approx 0{,}370$ : environ un sur trois a exactement une mutation.
Le choix de $\mu$ est un compromis. S'il est trop petit, la population finit par être faite de copies presque identiques et n'explore plus rien de nouveau. S'il est trop grand, les bonnes solutions sont abîmées avant d'avoir pu se transmettre, et l'algorithme ne fait plus que tirer au hasard, comme le singe de Dawkins.
En réunissant les trois opérations, une génération d'un algorithme génétique se déroule ainsi, pour une population de $n$ individus :
- calculer la note de chaque individu ;
- choisir deux parents avec la roulette ;
- les croiser pour obtenir deux enfants ;
- faire muter les enfants ;
- recommencer les étapes 2 à 4 jusqu'à obtenir $n$ enfants, qui forment la nouvelle population.
On ajoute souvent une précaution, l'élitisme : le meilleur individu est recopié tel quel dans la génération suivante, pour ne jamais perdre la meilleure solution trouvée. On répète ensuite les générations, par exemple cent fois, ou jusqu'à ce que les notes ne s'améliorent plus.
Considérons la fonction $f$ définie sur l'intervalle $[0\,;1]$ par
$$f(x) = x\sin(10\pi x) + 1.$$On cherche la valeur de $x$ pour laquelle $f(x)$ est la plus grande possible : le maximum de $f$. La courbe de la figure plus bas montre que la fonction a plusieurs « bosses ». Chaque bosse est un maximum local : autour d'elle, la fonction ne prend pas de valeur plus grande. La plus haute de toutes est le maximum global, celui que l'on cherche.
Ce que donne le cours de terminale. On étudie habituellement les variations d'une fonction grâce au signe de sa dérivée. Ici, $f(x) = x \times \sin(10\pi x) + 1$ contient un produit $u \times v$, avec $u(x) = x$ et $v(x) = \sin(10\pi x)$. On a $u'(x) = 1$, et, par la formule de dérivation de $x \mapsto \sin(ax)$, $v'(x) = 10\pi\cos(10\pi x)$. La formule $(uv)' = u'v + uv'$ donne
$$f'(x) = \sin(10\pi x) + 10\pi x\cos(10\pi x).$$Les maxima de $f$ sont parmi les solutions de l'équation $f'(x) = 0$. Mais cette équation mélange un sinus, un cosinus et un produit par $x$ : on ne sait pas la résoudre par un calcul exact. On peut seulement situer les bosses à peu près. Le sinus vaut $1$, sa plus grande valeur, quand $10\pi x = \dfrac{\pi}{2} + 2k\pi$ avec $k$ entier, c'est-à-dire quand $x = 0{,}05 + 0{,}2k$. En ces points, $f(x) = x \times 1 + 1 = x + 1$ :
| $x$ | $0{,}05$ | $0{,}25$ | $0{,}45$ | $0{,}65$ | $0{,}85$ |
|---|---|---|---|---|---|
| $f(x)$ | $1{,}05$ | $1{,}25$ | $1{,}45$ | $1{,}65$ | $1{,}85$ |
Les bosses sont de plus en plus hautes : le maximum global est voisin de $x = 0{,}85$. Un calcul numérique précis donne $x \approx 0{,}851$ et $f(x) \approx 1{,}851$.
Pourquoi c'est difficile en général. Ici, on a pu deviner où étaient les bosses parce que la fonction est simple. Imaginons une méthode qui part d'un point et avance toujours dans le sens où $f$ augmente, comme un randonneur qui monte toujours dans le brouillard : elle s'arrête au sommet de la première bosse rencontrée, qui n'est pas forcément la plus haute. Un algorithme génétique, qui explore avec toute une population répartie sur l'intervalle, a de bien meilleures chances de trouver la plus haute bosse.
Pour appliquer l'algorithme, chaque individu doit être une suite de chiffres. On utilise l'écriture en base $2$, celle des ordinateurs. En base $10$, $870 = 8 \times 100 + 7 \times 10 + 0 \times 1$ : chaque chiffre est multiplié par une puissance de $10$. En base $2$, on n'utilise que les chiffres $0$ et $1$, multipliés par des puissances de $2$ : $512$, $256$, $128$, $64$, $32$, $16$, $8$, $4$, $2$, $1$.
Un individu est une suite de $10$ chiffres binaires, par exemple 1101100110. On calcule l'entier qu'elle représente :
| chiffre | $1$ | $1$ | $0$ | $1$ | $1$ | $0$ | $0$ | $1$ | $1$ | $0$ |
|---|---|---|---|---|---|---|---|---|---|---|
| valeur | $512$ | $256$ | $128$ | $64$ | $32$ | $16$ | $8$ | $4$ | $2$ | $1$ |
On additionne les valeurs des chiffres égaux à $1$ : $512 + 256 + 64 + 32 + 4 + 2 = 870$. Avec $10$ chiffres, on peut écrire tous les entiers de $0$ à $1\,023$, car $512 + 256 + \cdots + 1 = 2^{10} - 1 = 1\,023$ (c'est la somme des termes d'une suite géométrique). Il y a donc $2^{10} = 1\,024$ individus possibles. Pour obtenir un nombre $x$ entre $0$ et $1$, on divise par $1\,023$ : ici $x = \dfrac{870}{1\,023} \approx 0{,}850$. Les valeurs possibles de $x$ sont espacées de $\dfrac{1}{1\,023} \approx 0{,}001$ : c'est la précision de la recherche.
La note d'un individu est $f(x)$. Pour la roulette, il faut qu'elle soit positive : c'est le cas, car $\sin(10\pi x) \geqslant -1$, donc $x\sin(10\pi x) \geqslant -x \geqslant -1$ (puisque $x \geqslant 0$), et $f(x) \geqslant 0$.
La figure applique tout ce qui précède : $16$ individus de $10$ chiffres tirés au hasard, puis, à chaque génération, l'élitisme, la sélection par roulette, le croisement (avec la probabilité $0{,}8$) et la mutation de chaque chiffre (avec la probabilité $0{,}03$). Chaque point rouge est un individu, placé sur la courbe à l'abscisse $x$ qu'il code.
Le mot « le plus souvent » de la légende est important : un algorithme génétique ne garantit pas de trouver le maximum global, et deux exécutions donnent des résultats différents, puisqu'il utilise le hasard. C'est une méthode heuristique : elle trouve en général une très bonne solution en un temps raisonnable, sans preuve que ce soit la meilleure.
Un représentant de commerce doit visiter $n$ villes, chacune une seule fois, et revenir à son point de départ. Dans quel ordre doit-il les visiter pour parcourir la distance totale la plus courte ? C'est le problème du voyageur de commerce, l'un des plus célèbres de l'informatique. Il se pose pour une tournée de livraison, pour le trajet d'une machine qui perce des milliers de trous dans un circuit électronique, ou pour un robot qui ramasse des colis dans un entrepôt.
Prenons $4$ villes A, B, C, D, et partons de A (le point de départ ne change pas la longueur d'une boucle). Il faut choisir l'ordre dans lequel on visite B, C et D, puis revenir en A. Énumérons tous les ordres :
| A B C D A | A B D C A | A C B D A |
| A C D B A | A D B C A | A D C B A |
Il y en a $6$ : $3$ choix pour la première ville visitée, puis $2$ pour la deuxième, puis $1$ pour la dernière, soit $3 \times 2 \times 1 = 3! = 6$. Mais regardons de plus près : A B C D A et A D C B A sont la même boucle, parcourue dans les deux sens, donc de même longueur. Les $6$ ordres vont par paires (A B D C A avec A C D B A, et A C B D A avec A D B C A) : il n'y a que $\dfrac{6}{2} = 3$ trajets de longueurs différentes.
Avec $n$ villes, on fixe la ville de départ. Il reste $n - 1$ villes à ranger dans un ordre : $n - 1$ choix pour la première, $n - 2$ pour la deuxième, …, $1$ pour la dernière. D'après le principe multiplicatif, il y a
$$(n-1) \times (n-2) \times \cdots \times 1 = (n-1)!$$ordres possibles. Chaque boucle est obtenue deux fois, une fois dans chaque sens de parcours, avec la même longueur. Le nombre de trajets différents est donc $\dfrac{(n-1)!}{2}$. Pour $n = 4$, on retrouve $\dfrac{3!}{2} = 3$.
| villes | trajets | temps pour tous les essayer à un milliard par seconde |
|---|---|---|
| $5$ | $12$ | instantané |
| $10$ | $181\,440$ | un cinq-millième de seconde |
| $20$ | environ $6 \times 10^{16}$ | environ $2$ ans |
| $30$ | environ $4 \times 10^{30}$ | bien plus que l'âge de l'Univers |
Passer de $10$ à $20$ villes multiplie le nombre de trajets par environ $300$ milliards. La factorielle croît plus vite que n'importe quelle suite géométrique : on parle d'explosion combinatoire. Pour quelques dizaines de villes, il est impossible d'essayer tous les trajets, et l'on ne connaît aucune méthode qui trouve toujours le meilleur trajet rapidement ; savoir s'il en existe une est l'un des grands problèmes ouverts de l'informatique (le problème « P = NP »). On cherche donc de très bons trajets, sans garantie qu'ils soient les meilleurs : c'est là que les algorithmes génétiques sont utiles.
L'individu. Un individu est un ordre de visite, par exemple A D B E C pour $5$ villes. Sa note doit être d'autant meilleure que le trajet est court : on compare les longueurs, la plus courte étant la meilleure.
Le croisement ordinaire ne marche pas. Si l'on coupe deux trajets au même endroit et qu'on échange les fins, on obtient en général un trajet incorrect :
| parent 1 | A D B | E C |
| parent 2 | A B C | D E |
| enfant | A D B | D E |
L'enfant passe deux fois par D et jamais par C : ce n'est plus un trajet. On utilise donc un croisement adapté : on recopie un morceau du premier parent, puis on complète avec les villes manquantes, dans l'ordre où elles apparaissent chez le second parent. Avec les mêmes parents, on garde le début A D B du parent 1 ; il manque C et E, qui apparaissent dans l'ordre C puis E chez le parent 2 : l'enfant est A D B C E, un vrai trajet.
La mutation échange deux villes du trajet : A D B C E peut devenir A C B D E.
La figure applique cette méthode à $14$ villes placées au hasard, avec $80$ trajets par génération. Il y a $\dfrac{13!}{2} \approx 3 \times 10^9$ trajets possibles.
Une histoire courte. Dès les années 1950, quelques chercheurs simulent l'évolution sur ordinateur. Dans les années 1960, à Berlin, Ingo Rechenberg et Hans-Paul Schwefel inventent les « stratégies d'évolution » pour optimiser la forme de pièces mécaniques. En 1975, l'Américain John Holland publie Adaptation in Natural and Artificial Systems, qui fonde les algorithmes génétiques tels qu'on les connaît. Avec la puissance croissante des ordinateurs, ils se répandent dans les années 1990.
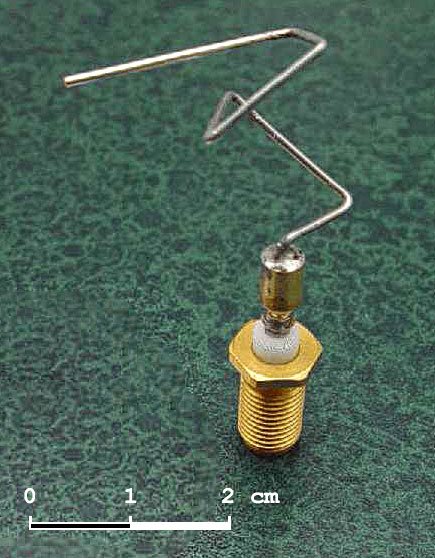
L'antenne de la NASA. En 2006, la NASA lance trois petits satellites, la mission Space Technology 5. Leurs antennes devaient respecter des contraintes très strictes de taille, de poids et de qualité de réception. Plutôt que de les dessiner, les ingénieurs ont laissé un algorithme évolutionnaire en chercher la forme : chaque individu était une forme d'antenne, décrite par une suite de segments, et sa note était calculée par une simulation de sa réception. Le résultat, une forme tordue qu'aucun ingénieur n'aurait imaginée, satisfaisait toutes les exigences et a fonctionné dans l'espace.
D'autres usages. Les algorithmes génétiques et leurs cousins servent à construire des emplois du temps et des tournées, à régler des réseaux électriques, à concevoir des pièces d'avion ou des molécules, et, en biologie, à reconstruire les arbres de parenté entre espèces à partir de leur ADN.
Des limites. Un algorithme génétique ne garantit pas de trouver la meilleure solution. Il demande beaucoup de calculs, puisque chaque individu doit être noté à chaque génération. Et il dépend de nombreux réglages : taille de la population, probabilités de croisement et de mutation. Quand le problème a une structure exploitable (une fonction dont on sait résoudre $f'(x) = 0$, un petit nombre de cas à essayer), les méthodes mathématiques classiques sont bien plus efficaces. Les algorithmes génétiques sont un outil pour les problèmes où l'on ne sait pas faire mieux.
Le programme Python suivant reproduit l'expérience de Dawkins. Chaque ligne est commentée. On peut changer le taux de mutation ou le nombre de copies, et observer l'effet sur le nombre de générations.
Ce texte n'est pas un Grand Oral. Il rassemble des connaissances dans lesquelles chacun peut choisir une direction, la creuser et formuler sa propre question. Quelques directions possibles :
- Mathématiques : le dénombrement des possibilités (suites de caractères, gamètes, trajets), l'inégalité de Bernoulli démontrée par récurrence, la loi binomiale des mutations, la sélection par roulette, maximum local et maximum global.
- SVT : la sélection naturelle, les mutations, le brassage inter et intrachromosomique, ce qui distingue l'évolution d'une optimisation.
- NSI : le codage en binaire, l'explosion combinatoire, les méthodes heuristiques, le problème du voyageur de commerce.
Le jury peut interroger sur les chapitres de spécialité mobilisés. Avec ce thème, il est utile de connaître parfaitement : le dénombrement (principe multiplicatif, $k$-uplets, permutations et factorielle) ; le raisonnement par récurrence ; le schéma de Bernoulli et la loi binomiale, son espérance ; la dérivation (produit, fonction $x \mapsto \sin(ax)$) et l'étude des variations ; la somme des termes d'une suite géométrique.
Pour réviser ces chapitres, l'application Maths FlashBac reprend tout le cours de spécialité en cartes.
- Algorithme génétique, problème du voyageur de commerce et brassage génétique (Wikipédia).
- R. Dawkins, L'Horloger aveugle, Robert Laffont, 1989 (chapitre 3).
- Sur ce site : La dérive génétique (le hasard dans l'évolution) et Approximation des solutions d'une équation.