← Tous les textes du Grand Oral
MathsNSISES
Un pirate qui veut entrer dans un compte n'a souvent qu'une méthode : essayer des mots de passe, un par un, le plus vite possible. La sécurité d'un mot de passe tient alors à une seule question mathématique : combien y a-t-il de possibilités, et combien de temps faut-il pour toutes les essayer ? Y répondre, c'est faire du dénombrement, manipuler des puissances et des logarithmes.
Mais les humains ne choisissent pas leurs mots de passe au hasard, et les sites stockent les mots de passe sous une forme transformée, le « hachage », dont la sécurité repose sur un résultat de probabilités étonnant : le paradoxe des anniversaires. Ces questions se traitent avec les mathématiques de terminale : dénombrement, probabilités, fonctions exponentielle et logarithme, convexité, algorithmique.
Ce texte rassemble ces connaissances. Il ne propose pas de Grand Oral tout fait : à chacun d'y choisir une direction et d'y construire sa question.
- Compter les mots de passe possibles
- Le code PIN et ses trois essais
- L'attaque par force brute
- Quelle longueur choisir ? Le logarithme
- L'entropie : mesurer en bits
- Les phrases de passe
- Les humains ne tirent pas au hasard
- Hacher et saler les mots de passe
- Le paradoxe des anniversaires et les collisions
- Ce que recommandent l'ANSSI et la CNIL
- Estimer un mot de passe
- Des directions pour construire sa question
Imaginons un clavier minuscule qui n'aurait que trois touches : $a$, $b$ et $c$. Combien de mots de passe de deux caractères peut-on écrire ? On peut tous les lister :
aa ab ac ba bb bc ca cb cc
Il y en a $9$. On le comprend avec un arbre : $3$ choix pour le premier caractère, et pour chacun d'eux $3$ choix pour le second, soit $3 \times 3 = 3^2 = 9$. Avec trois caractères, on obtiendrait $3^3 = 27$ mots de passe.
Un mot de passe de longueur $n$ écrit avec un alphabet de $k$ caractères est une suite ordonnée de $n$ caractères, avec répétitions possibles : c'est un $n$-uplet (ou une liste) d'éléments d'un ensemble à $k$ éléments.
Le nombre de $n$-uplets d'un ensemble à $k$ éléments est $k^n$.
On raisonne par récurrence sur $n$. Pour $n = 1$, il y a $k$ listes d'un seul élément, et $k^1 = k$.
Supposons qu'il y ait $k^n$ listes de longueur $n$. Une liste de longueur $n + 1$ s'obtient en choisissant une liste de longueur $n$ puis en lui ajoutant un dernier élément, parmi $k$ possibles. Chaque liste de longueur $n + 1$ est obtenue exactement une fois. D'après le principe multiplicatif, il y en a $k^n \times k = k^{n+1}$.
La propriété est vraie au rang $1$ et héréditaire : elle est vraie pour tout entier $n \geqslant 1$.
Les alphabets usuels sont les $10$ chiffres, les $26$ lettres minuscules, les $62$ lettres et chiffres
($26 + 26 + 10$), et les $94$ caractères imprimables d'un clavier (lettres, chiffres et signes comme
!, #, %). Le tableau donne le nombre de mots de passe possibles.
| Alphabet | $k$ | $n = 8$ | $n = 12$ |
|---|---|---|---|
| chiffres | $10$ | $10^8$ | $10^{12}$ |
| minuscules | $26$ | $2{,}1 \times 10^{11}$ | $9{,}5 \times 10^{16}$ |
| lettres et chiffres | $62$ | $2{,}2 \times 10^{14}$ | $3{,}2 \times 10^{21}$ |
| clavier complet | $94$ | $6{,}1 \times 10^{15}$ | $4{,}8 \times 10^{23}$ |
Deux leviers augmentent le nombre de possibilités : la taille $k$ de l'alphabet, qui est la base de la puissance, et la longueur $n$, qui est l'exposant. Le second est bien plus efficace : passer de $8$ à $12$ minuscules multiplie le nombre de mots de passe par $26^4 \approx 457\,000$, alors que passer de $26$ à $94$ caractères sur $8$ positions le multiplie par $\left(\frac{94}{26}\right)^8 \approx 29\,000$.
Un code de carte bancaire ou de téléphone compte $4$ chiffres : il y a $10^4 = 10\,000$ codes possibles. C'est très peu : un ordinateur les essaie tous en une fraction de seconde. La protection ne vient pas du nombre de codes, mais du nombre d'essais autorisés : au troisième échec, la carte est bloquée.
Si le code a été choisi au hasard (loi uniforme) et que le voleur essaie trois codes différents, quelle est la probabilité qu'il trouve ? Notons $A_i$ l'événement « le $i$-ème essai réussit ». Les trois événements sont incompatibles (un seul code est le bon), et chaque code a la même probabilité $\frac{1}{10\,000}$ d'être le bon, donc
$$P(A_1 \cup A_2 \cup A_3) = \frac{3}{10\,000} = 0{,}0003.$$Trois chances sur dix mille : c'est la limitation du nombre d'essais qui rend un code court acceptable. Un mot de passe en ligne, lui, peut être attaqué sans limite si le pirate a récupéré le fichier des mots de passe d'un site. C'est le cas qui nous intéresse désormais.
La loi uniforme est cependant une hypothèse optimiste. Une analyse publiée en 2012 sur plusieurs millions de codes à $4$ chiffres issus
de fuites a estimé qu'environ un code sur dix était 1234. Si c'est le cas, un voleur qui essaie 1234,
1111 et 0000 a bien plus de $3$ chances sur $10\,000$ : nous y reviendrons.
Attaquer « par force brute », c'est essayer tous les mots de passe possibles. Avec $N$ possibilités et une vitesse de $v$ essais par seconde, il faut au pire $\frac{N}{v}$ secondes.
Si le mot de passe a été tiré au hasard parmi les $N$, le nombre d'essais nécessaires est une variable aléatoire $X$ qui suit la loi uniforme sur $\{1, 2, \ldots, N\}$ : le bon mot de passe a autant de chances d'être le premier essayé que le dernier. Son espérance est
$$\begin{aligned} E(X) &= \frac{1}{N} \sum_{i=1}^{N} i \\ &= \frac{1}{N} \times \frac{N(N+1)}{2} \\ &= \frac{N+1}{2}. \end{aligned}$$En moyenne, le pirate trouve donc après avoir essayé environ la moitié des possibilités.
Prenons une vitesse de $v = 10^{10}$ essais par seconde. C'est un ordre de grandeur choisi pour l'exemple : une carte graphique récente peut aller plus vite sur certains formats, et un site bien conçu ralentit volontairement le calcul (voir la partie sur le hachage). Le temps maximal d'attaque est alors :
| Alphabet | $n = 8$ | $n = 12$ | $n = 16$ |
|---|---|---|---|
| $26$ | $21$ s | $110$ jours | $140\,000$ ans |
| $62$ | $6$ h | $10\,000$ ans | $1{,}5 \times 10^{11}$ ans |
| $94$ | $7$ jours | $1{,}5$ million d'années | $10^{14}$ ans |
Pour un mot de passe de $8$ caractères pris dans les $94$ du clavier, le calcul est :
$$\frac{94^8}{10^{10}} \approx \frac{6{,}1 \times 10^{15}}{10^{10}} = 6{,}1 \times 10^5 \text{ s}.$$Comme une journée compte $86\,400$ secondes, cela fait environ $7$ jours. Avec $12$ caractères, on passe à un million et demi d'années : chaque caractère ajouté multiplie le temps par $94$.
Retournons la question : quelle longueur $n$ faut-il pour qu'une attaque à $10^{10}$ essais par seconde dure au moins un siècle ? Un siècle compte environ $100 \times 3{,}156 \times 10^7 \approx 3{,}16 \times 10^9$ secondes. Il faut donc
$$k^n \geqslant 10^{10} \times 3{,}16 \times 10^9 \approx 3{,}16 \times 10^{19}.$$Étape 1 : passer au logarithme. Les deux membres sont strictement positifs et la fonction $\ln$ est strictement croissante sur $]0 ; +\infty[$, donc l'inégalité équivaut à
$$\ln\left(k^n\right) \geqslant \ln\left(3{,}16 \times 10^{19}\right).$$Étape 2 : la propriété du logarithme. Pour tout entier $n$, $\ln\left(k^n\right) = n \ln k$. L'inégalité devient $n \ln k \geqslant \ln\left(3{,}16 \times 10^{19}\right) \approx 44{,}9$.
Étape 3 : diviser. Comme $k \geqslant 2$, on a $\ln k > 0$, et l'on peut diviser sans changer le sens de l'inégalité :
$$n \geqslant \frac{44{,}9}{\ln k}.$$Étape 4 : conclure. Pour $k = 26$, on trouve $n \geqslant 13{,}8$, donc $14$ minuscules. Pour $k = 62$, $n \geqslant 10{,}9$, donc $11$ caractères. Pour $k = 94$, $n \geqslant 9{,}9$, donc $10$ caractères.
Le résultat est frappant : $14$ minuscules résistent aussi bien que $10$ caractères pris sur tout le clavier. Une longueur un peu plus grande compense largement un alphabet réduit, et un mot de passe long en minuscules est plus facile à retenir et à taper.
Plutôt que de manier des nombres comme $4{,}8 \times 10^{23}$, les informaticiens mesurent la force d'un mot de passe tiré au hasard par son entropie, exprimée en bits :
$$H = \log_2 N = \frac{\ln N}{\ln 2},$$où $N$ est le nombre de mots de passe possibles. Un bit correspond à un choix entre deux possibilités équiprobables, comme un lancer de pièce. Un mot de passe de $H$ bits est aussi difficile à deviner qu'une suite de $H$ lancers de pièce.
Le logarithme transforme les produits en sommes. Pour un mot de passe de $n$ caractères pris dans un alphabet de taille $k$,
$$H = \log_2\left(k^n\right) = n \log_2 k.$$Chaque caractère ajoute $\log_2 k$ bits : environ $3{,}3$ bits pour un chiffre, $4{,}7$ pour une minuscule, $6{,}0$ pour un caractère alphanumérique, $6{,}6$ pour un caractère du clavier complet. Ainsi $8$ caractères du clavier complet font $8 \times 6{,}55 \approx 52$ bits, et $12$ caractères environ $79$ bits.
Ajouter un bit double le nombre de possibilités, donc double le temps d'attaque. Ajouter $10$ bits le multiplie par $2^{10} = 1\,024$. L'entropie mesure aussi l'information au sens de Claude Shannon : voir le texte sur la linguistique quantitative.
Un mot de passe de $12$ caractères tirés au hasard, comme q7#Lp!2xV&9m, est très difficile à retenir. Une autre idée consiste
à tirer au hasard non pas des caractères, mais des mots. On obtient une phrase de passe, comme
« tulipe vapeur girafe ancre poivre lundi ».
En 1995, l'Américain Arnold Reinhold propose la méthode Diceware. On dispose d'une liste de $6^5 = 7\,776$ mots numérotés par des nombres à cinq chiffres compris entre $1$ et $6$. On lance cinq dés : les chiffres obtenus désignent un mot de la liste. On recommence pour chaque mot de la phrase.
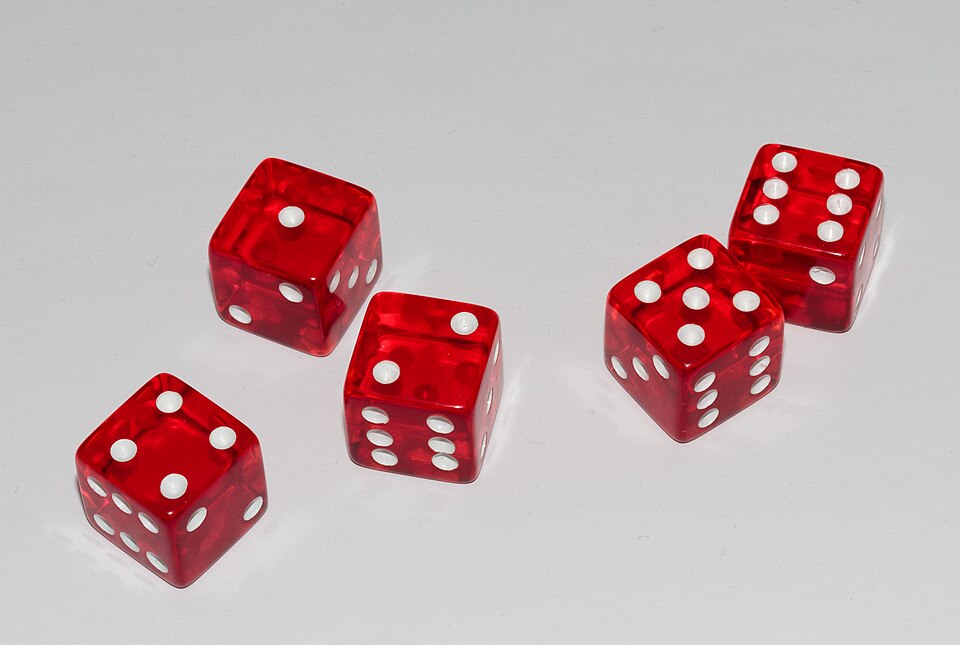
Pourquoi $7\,776$ mots ? Un lancer de cinq dés est un $5$-uplet de l'ensemble $\{1, 2, 3, 4, 5, 6\}$, et il y en a $6^5 = 7\,776$. Chaque mot apporte donc $\log_2 7\,776 \approx 12{,}9$ bits. Une phrase de $m$ mots est un $m$-uplet de la liste : il y a $7\,776^m$ phrases possibles, soit environ $12{,}9\,m$ bits.
| Mots | Possibilités | Entropie |
|---|---|---|
| $4$ | $3{,}7 \times 10^{15}$ | $52$ bits |
| $6$ | $2{,}2 \times 10^{23}$ | $78$ bits |
| $7$ | $1{,}7 \times 10^{27}$ | $90$ bits |
Six mots tirés aux dés valent donc à peu près douze caractères tirés sur tout le clavier, et sont bien plus faciles à retenir. Un point est essentiel : les mots doivent être tirés au hasard. Une phrase choisie par soi-même, comme un vers connu, est bien plus facile à deviner.
En 2011, la bande dessinée en ligne xkcd a rendu l'idée célèbre. Elle compare un mot de passe « compliqué » comme
Tr0ub4dor&3, construit à partir d'un mot du dictionnaire avec quelques substitutions prévisibles, à la phrase
correct horse battery staple, formée de quatre mots courants tirés au hasard. L'auteur estime le premier à environ $28$ bits,
car un attaquant connaît ces substitutions, et le second à $4 \times \log_2 2\,048 = 44$ bits, en supposant les mots
tirés parmi $2\,048 = 2^{11}$ mots courants. Le second est à la fois plus fort et plus facile à retenir.
Tous les calculs précédents supposent que le mot de passe a été tiré selon la loi uniforme. Ce n'est presque jamais le cas.
Quand des sites se font voler leurs fichiers de mots de passe, les listes publiées montrent toujours les mêmes choix en tête :
123456, password, azerty, des prénoms, des dates de naissance, des noms de clubs. En 2009, la fuite
du site RockYou a révélé environ $32$ millions de mots de passe, et 123456 y était le plus fréquent.
Le pirate n'essaie donc pas les mots de passe dans l'ordre alphabétique, mais du plus fréquent au moins fréquent : c'est
l'attaque par dictionnaire. Il utilise des listes de mots de passe réels, de mots de toutes les langues, et applique des
règles de transformation (majuscule au début, chiffre à la fin, a remplacé par @…).
Imaginons une population où, comme dans l'analyse des codes PIN citée plus haut, une personne sur dix choisit 1234, et où
les autres codes sont répartis de façon uniforme. Un voleur essaie 1234 en premier. La probabilité qu'il trouve au premier
essai est déjà $0{,}1$, à comparer à $0{,}0001$ pour un code tiré au hasard : mille fois
plus.
Ce raisonnement montre ce que l'entropie ne mesure pas : la formule $H = \log_2 N$ n'est valable que si tous les
mots de passe ont la même probabilité. Un mot de passe de $10$ caractères comme Azerty2024 a beau compter parmi
$62^{10}$ possibilités, il figure dans les premières listes essayées. La sécurité d'un mot de passe dépend de la
manière dont il a été choisi, pas seulement de sa longueur.
Un site sérieux ne stocke pas les mots de passe de ses utilisateurs. Il stocke leur empreinte, ou haché, calculée par une fonction de hachage : une fonction $h$ qui transforme n'importe quel texte en une suite de bits de longueur fixe, par exemple $256$ bits. À la connexion, le site calcule l'empreinte du mot de passe tapé et la compare à celle qu'il a gardée.
Une bonne fonction de hachage doit être facile à calculer, mais impossible à « remonter » : connaissant $h(x)$, on ne sait pas retrouver $x$ autrement qu'en essayant des mots de passe un par un. Si le fichier des empreintes est volé, le pirate doit donc mener une attaque par force brute ou par dictionnaire, ce qui nous ramène aux calculs précédents.
Deux précautions s'ajoutent :
- Le sel. Avant de hacher, on ajoute au mot de passe une chaîne aléatoire propre à chaque utilisateur, le
sel, stockée en clair à côté de l'empreinte. Deux personnes qui ont choisi
123456n'ont alors pas la même empreinte, et le pirate ne peut pas préparer à l'avance une table géante « mot de passe → empreinte » valable pour tout le monde : il doit recommencer le travail pour chaque compte. - La lenteur volontaire. Les fonctions conçues pour les mots de passe (comme bcrypt, scrypt ou Argon2) sont volontairement lentes : un millième de seconde pour l'utilisateur ne se remarque pas, mais divise la vitesse du pirate par un facteur énorme. Dans la figure de la partie sur la force brute, cela revient à déplacer le curseur vers la gauche.
Il reste un risque : comme une infinité de textes ont des empreintes prises parmi un nombre fini de valeurs, deux textes différents peuvent avoir la même empreinte. On parle de collision. Combien d'essais faut-il pour en trouver une ? La réponse est un résultat célèbre de probabilités.
Dans une classe de $23$ élèves, quelle est la probabilité que deux élèves au moins aient le même jour d'anniversaire ? On suppose les $365$ jours équiprobables (on oublie le $29$ février) et les élèves indépendants. Beaucoup de gens répondent « environ $\frac{23}{365}$ », soit $6\,\%$. La bonne réponse est un peu plus de $50\,\%$.
Plaçons-nous dans le cas général : $n$ éléments tirés au hasard, de façon uniforme et indépendante, parmi $N$ valeurs possibles ($N = 365$ jours, ou $N = 2^{256}$ empreintes). On note $C$ l'événement « au moins deux éléments ont la même valeur ». On calcule plutôt la probabilité de l'événement contraire, « toutes les valeurs sont différentes ».
Étape 1 : dénombrer. Les tirages possibles sont les $n$-uplets de valeurs : il y en a $N^n$, tous équiprobables. Les tirages sans valeur répétée sont les $n$-uplets d'éléments distincts (les arrangements) : $N$ choix pour le premier, $N - 1$ pour le deuxième, et ainsi de suite jusqu'à $N - n + 1$ pour le dernier.
Étape 2 : écrire la probabilité comme un produit.
$$\begin{aligned} P\left(\overline{C}\right) &= \frac{N(N-1) \cdots (N-n+1)}{N^n} \\ &= \prod_{i=0}^{n-1} \frac{N - i}{N} \\ &= \prod_{i=0}^{n-1} \left(1 - \frac{i}{N}\right). \end{aligned}$$Étape 3 : calculer pour 23 personnes. Avec $N = 365$ et $n = 23$, le produit vaut environ $0{,}493$ (calcul en Python ci-dessous). Donc $P(C) \approx 0{,}507$.
L'intuition se trompe parce qu'elle compare chaque élève à un autre. Or avec $23$ élèves, il y a $\binom{23}{2} = 253$ paires d'élèves, et chacune peut produire une coïncidence.
Pour comprendre comment $n$ dépend de $N$, on encadre le produit grâce à une inégalité classique.
Pour tout réel $x$, $1 - x \leqslant \mathrm{e}^{-x}$.
Posons $g(x) = \mathrm{e}^{-x} - 1 + x$ pour $x$ réel. La fonction $g$ est dérivable et $g'(x) = 1 - \mathrm{e}^{-x}$.
Comme la fonction exponentielle est strictement croissante, $\mathrm{e}^{-x} < 1$ lorsque $x > 0$, et $\mathrm{e}^{-x} > 1$ lorsque $x < 0$. Donc $g'(x) < 0$ sur $]-\infty ; 0[$ et $g'(x) > 0$ sur $]0 ; +\infty[$.
La fonction $g$ admet donc un minimum en $0$, égal à $g(0) = 1 - 1 + 0 = 0$. Ainsi $g(x) \geqslant 0$ pour tout réel $x$, ce qui est l'inégalité annoncée.
Géométriquement, la droite d'équation $y = 1 - x$ est la tangente à la courbe de $x \mapsto \mathrm{e}^{-x}$ au point d'abscisse $0$ ; la fonction étant convexe, sa courbe est au-dessus de ses tangentes.
Appliquons l'inégalité à chaque facteur du produit, avec $x = \frac{i}{N}$. Tous les facteurs sont positifs (on suppose $n \leqslant N$), donc on peut multiplier les inégalités membre à membre :
$$P\left(\overline{C}\right) \leqslant \prod_{i=0}^{n-1} \mathrm{e}^{-i/N} = \mathrm{e}^{-\frac{1}{N}\sum_{i=0}^{n-1} i}.$$La somme des entiers de $0$ à $n - 1$ vaut $\frac{n(n-1)}{2}$, d'où
$$P\left(\overline{C}\right) \leqslant \mathrm{e}^{-\frac{n(n-1)}{2N}},$$soit
$$P(C) \geqslant 1 - \mathrm{e}^{-\frac{n(n-1)}{2N}}.$$Cherchons $n$ pour que la probabilité d'une collision dépasse $\frac{1}{2}$. D'après l'inégalité, il suffit que
$$1 - \mathrm{e}^{-\frac{n(n-1)}{2N}} \geqslant \frac{1}{2},$$c'est-à-dire
$$\mathrm{e}^{-\frac{n(n-1)}{2N}} \leqslant \frac{1}{2}.$$En appliquant la fonction $\ln$, strictement croissante, puis en multipliant par $-2N$ (ce qui change le sens) :
$$-\frac{n(n-1)}{2N} \leqslant -\ln 2,$$ce qui équivaut à
$$n(n-1) \geqslant 2N \ln 2.$$Comme $n(n-1)$ est proche de $n^2$ pour $n$ grand, la condition est remplie dès que $n$ dépasse environ $\sqrt{2 \ln 2 \times N} \approx 1{,}18\sqrt{N}$. Pour $N = 365$, cela donne $1{,}18 \times \sqrt{365} \approx 22{,}5$ : on retrouve $23$ élèves.
Pour une fonction de hachage à $b$ bits, il y a $N = 2^b$ empreintes possibles. Trouver un texte qui a une empreinte donnée demande de l'ordre de $2^b$ essais. Mais trouver deux textes quelconques de même empreinte n'en demande que de l'ordre de $\sqrt{2^b} = 2^{b/2}$. C'est pourquoi les empreintes modernes comptent $256$ bits : une collision demanderait de l'ordre de $2^{128}$ calculs, hors de portée. Des fonctions plus anciennes, comme MD5 ($128$ bits) ou SHA-1 ($160$ bits), sont aujourd'hui abandonnées pour la sécurité, car des collisions y ont été fabriquées.
Le programme suivant calcule le produit exact et simule des classes de $23$ élèves.
La fréquence observée est proche de $0{,}507$ : plus on simule de classes, plus il est probable que la fréquence soit proche de cette probabilité (loi des grands nombres).
En France, l'Agence nationale de la sécurité des systèmes d'information (ANSSI) et la Commission nationale de l'informatique et des libertés (CNIL) publient des recommandations qui s'appuient précisément sur l'entropie.
- Dans ses recommandations de 2021 sur les mots de passe, l'ANSSI propose des ordres de grandeur : une entropie inférieure à $64$ bits est jugée très faible, de $64$ à $80$ bits faible, de $80$ à $100$ bits moyenne, et au-delà de $100$ bits forte.
- Dans sa recommandation de 2022, la CNIL retient, pour un mot de passe utilisé seul, une entropie d'environ $80$ bits. Elle en donne des exemples : $12$ caractères mêlant majuscules, minuscules, chiffres et caractères spéciaux, ou $14$ caractères sans caractère spécial obligatoire, ou une phrase de passe d'au moins $7$ mots.
On peut vérifier ces exemples avec les formules du texte : $12 \log_2 94 \approx 79$ bits, $14 \log_2 62 \approx 83$ bits, et $7$ mots Diceware donnent $90$ bits. Les seuils exigés sont plus faibles quand le site limite le nombre d'essais ou ajoute une seconde vérification (un code reçu par SMS, une application) : c'est la logique du code PIN. Ces recommandations évoluent : il faut se reporter aux textes en vigueur.
Deux conseils découlent de tout ce qui précède : utiliser un mot de passe différent pour chaque site (sinon une seule fuite ouvre tous les comptes), et utiliser un gestionnaire de mots de passe, qui tire au hasard de longs mots de passe et les retient à notre place.
L'outil ci-dessous applique les formules du texte. Il repère les familles de caractères utilisées (minuscules, majuscules, chiffres, autres signes), en déduit la taille $k$ de l'alphabet, puis calcule $H = n \log_2 k$ et le temps maximal d'une attaque par force brute. Le calcul se fait entièrement sur votre appareil : rien n'est envoyé. Par prudence, n'y tapez pas un vrai mot de passe : inventez un exemple du même genre.
L'outil donne une borne supérieure : il suppose que chaque caractère a été tiré au hasard. Un mot de passe comme
Azerty2024 obtient un bon score alors qu'il figure dans les premières listes essayées par les pirates. C'est toute la limite
de l'entropie calculée sur la longueur seule. À l'inverse, pour une phrase de passe, l'outil compte les lettres une à une : la vraie
entropie est celle du tirage des mots, environ $78$ bits pour six mots Diceware, et non plus de $200$.
Ce texte n'est pas un Grand Oral. Il rassemble des connaissances dans lesquelles chacun peut choisir une direction, la creuser et formuler sa propre question. Quelques directions possibles :
- Mathématiques : le dénombrement des $n$-uplets et des arrangements ; la loi uniforme et l'espérance du nombre d'essais ; le logarithme pour trouver une longueur ; l'entropie comme logarithme de base $2$ ; le paradoxe des anniversaires et l'inégalité $1 - x \leqslant \mathrm{e}^{-x}$ démontrée par l'étude d'une fonction.
- NSI : l'écriture binaire et les bits, les fonctions de hachage, le sel, l'attaque par dictionnaire, la complexité d'une recherche exhaustive, la programmation d'un estimateur.
- SES : le coût des fuites de données pour les entreprises, la protection des données personnelles et le rôle de la CNIL, l'arbitrage entre sécurité et facilité d'usage, les comportements réels des utilisateurs.
Le jury peut interroger sur les chapitres de spécialité mobilisés. Avec ce thème, il est utile de connaître parfaitement : le dénombrement (principe multiplicatif, $n$-uplets, arrangements, combinaisons) ; le raisonnement par récurrence ; les probabilités, l'événement contraire et l'indépendance ; les variables aléatoires et l'espérance ; la fonction logarithme et ses propriétés algébriques ; la fonction exponentielle, la dérivation et l'étude des variations ; la convexité et la position par rapport aux tangentes ; la loi des grands nombres ; les boucles en Python.
Pour réviser ces chapitres, l'application Maths FlashBac reprend tout le cours de spécialité en cartes.
- ANSSI, Recommandations relatives à l'authentification multifacteur et aux mots de passe (2021).
- CNIL, Mots de passe : une nouvelle recommandation (2022).
- Paradoxe des anniversaires et Diceware (Wikipédia).
- Sur ce site : La cryptographie, Les clés de contrôle, Les mathématiques de la Seconde Guerre mondiale (Enigma), La linguistique quantitative (l'entropie) et Le jeu du tic-tac-toe (dénombrer des parties).